Hy-Nomas发布8B交互式世界模型,支持多轮指令与连续相机控制
Hy-Nomas: Towards Free-form Interactive World Generation
提出基于8B扩散骨干的Hy-Nomas视频世界模型,通过动作感知因果注意力与提示增强器实现多轮自由文本交互及连续相机控制。开源权重、代码及基准,提供轻量化适配流程以支持具身智能交互式世界生成研究。
解读与情报 · arXiv cs.RO 与顶会论文库
每日筛选与机器人真机强相关的 VLA 策略、世界模型、全身运动控制(Locomotion)与灵巧操作论文,直接关联论文验证所用机器人本体。
Hy-Nomas: Towards Free-form Interactive World Generation
提出基于8B扩散骨干的Hy-Nomas视频世界模型,通过动作感知因果注意力与提示增强器实现多轮自由文本交互及连续相机控制。开源权重、代码及基准,提供轻量化适配流程以支持具身智能交互式世界生成研究。
Vision-Language-Action or World-Action? Just Action Models
研究提出Just Action Model(JAM)统一VLA与WAM范式,通过前瞻损失替代视觉生成。在LIBERO等基准上成功率优于FastWAM,训练FLOPs降低73%,验证无需推理期图像生成即可实现高效具身控制。
Can LLMs Uncover Hidden Physical Laws through Free Exploration?
研究提出LongChang自动化仿真框架,评测LLM在无提示下通过自由探索发现异常物理定律的能力。测试显示GPT-6-Astra发现率为16.7%,其余11个模型均为0%,揭示了当前大模型在具身科学推理与主动实验设计上的显著瓶颈。
MLE-World: Predicting Machine Learning Experiment Outcomes with a Learned World Model
基于Qwen3.5-4B微调的MLE-World世界模型,无需执行即可预测代码终端输出与验证分数。在MLE-bench Lite任务中预测准确率达77.9%,引导测试时缩放策略使AI Agent平均性能提升22.1%,大幅降低真实训练开销。
PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
针对VLA模型物理理解弱及视频生成延迟高痛点,提出PDRVLA。通过轻量物理动态模块提取特征替代在线视频生成,在LIBERO等四项仿真基准中最高成功率达99.3%,验证了无视频生成下的高效动作决策能力。
RynnWorld-Latent: A Cross-Embodiment World Model Conditioned on Universal Latent Actions
提出RynnWorld-Latent跨具身世界模型,利用3D锚定潜在动作统一异构数据接口。在5.53亿帧数据预训练,支持数字遥操与潜在动作合成双路径,显著提升LIBERO策略成功率及真机任务执行效果。
SO-101 Bench: Accessible Spatial Manipulation
面向低成本机械臂SO-101推出Isaac Lab仿真基准,含4类任务与3629条演示。验证显示5种策略在虚实环境排名Spearman相关系数达1.00,LLM代码生成代理以83.2%成功率显著优于纯VLA模型。
ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
针对VLA模型受限于机器人演示数据多样性的问题,ThinkWorld框架提出Chain-of-Dynamics动作表征,利用世界想象强化学习从无标注人类视频中提取状态转移监督,实现人机经验统一推理空间,在仿真与真机验证了跨任务泛化效果。
Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
研究提出EvidenceConnect数据合成框架与ZwZ2模型,通过单图缩放视图生成需比对或链式推理的问答对,结合VLM共识与区域消融验证质量。经RLVR训练后,模型在具身空间推理、多模态长上下文及Agent任务上实现泛化提升。
EmbodiedLab: Benchmarking Embodied Agents That Act to Know
新基准EmbodiedLab聚焦机器人“以动求知”能力,覆盖5学科30个实验与14种装置。评测显示前沿模型原生控制成功率低于50%,失败主因是装置交互而非感知规划,操作技能蒸馏对弱模型提升显著优于感知增强。
Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
研究发布OSMA-Bench基准与SSI指标,测试发现VLM及VLA策略虽能识别障碍物语义,却无法将其转化为匹配的避障速度与距离参数。增加显式参数推理步骤可改善VLM策略的运动适应性,暴露了语义理解与底层运动控制间的接地鸿沟。
PhysEvolve: Verifier-grounded Self-evolution for Physical Reasoning with Executable Worlds
针对VLM物理因果推理短板,提出PhysEvolve自进化框架。基于Qwen3-VL-8B,利用物理引擎生成反事实数据与精确验证反馈,在PhysBench等基准实现最高24.4分提升,零样本迁移至流体软体等复杂动力学场景。
Rollback: Experience Backtracking in World Models for Policy Improvement
提出Rollback范式将世界模型转为反事实引擎,通过回溯决策点探索替代动作生成细粒度监督。结合异步真机执行与LoRA动态修正,在三项真实任务中成功率较基线提升超10%,8小时训练超越人类水平。
The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
针对多模态智能体环境构建成本高与迭代慢痛点,提出The Trinity递归自改进框架。通过能力驱动Real2Sim2Real机制重构任务树,在28个训练基准均分提升34点,18个未见基准提升26点,并验证于真实具身任务。
Intrinsic Goals for Autonomous Agents: Hierarchical Exploration Captures Future Volitional Action in Drosophila
研究结合果蝇全脑记录与神经机械数字孪生,验证DIAYN算法在无外奖励下最优复现生物自主探索。该算法通过离散运动基元库最大化行为熵,精准匹配果蝇10秒前决策编码及半球间运动学表征,为具身智能内生驱动提供生物学基准。
InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
提出InteractiveWorld仿真环境与InteractiveBench基准,支持AI指导人类Agent的闭环交互验证。评测显示12个前沿MLLM在长程引导与规划任务中最高成功率仅25%,揭示当前模型在物理世界辅助能力上的显著短板。
RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
提出RynnVLA-Latent框架,通过3D隐动作将3万小时异构视频转化为7.45亿监督信号。4B参数策略在LIBERO达98.8%成功率,RoboTwin 2.0双臂基准88.6%,并在真实灵巧手与移动抓取任务中取得最优表现。
AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
针对长视频稀疏篡改检测难题,发布含16650对样本的AV-FABLE双时间线基准。提出NFSR方法,通过分离解码器读取冻结AV-LLM特征,在域内及三个分布外设置中实现最优音视频篡改时序定位性能。
RoboJev: An Open Vision-Language Judge for Robot Success Detection
开源视觉语言模型RoboJev-27B专用于机器人操作任务成功判定,在SO-101测试集平衡准确率达95.2%,AUROC为0.993。模型基于JEV-27B-VL微调,单H100推理耗时0.26秒,支持跨实验室泛化,配套代码与评测数据集已开源。
DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
针对机器人操作模仿学习数据覆盖难题,DiscoDemo利用强化学习作为多样化轨迹生成器。该方法在四项任务中将下游视觉运动策略真机成功率从39%提升至78%,仿真成功率从40%升至62%,验证了多模态解对预训练VLA的增强效果。
HoloBoxing: A Simple Recipe for Humanoid Boxing with 7 Minutes of Single-GPU Training
提出基于预训练全身控制器的人形机器人拳击学习范式,通过解耦运动技能与任务决策,仅需单GPU额外训练7分钟即可掌握复杂交互。利用32维动作解码器与模仿学习初始化,在复用底层控制的同时高效优化上层策略。
RynnUnify: Towards Unified Embodied Brain
RynnUnify 16B模型通过交错视频-语言推理融合理解与长程规划,强化学习扩展提升预测推理6.0分,真机任务成功率达46.7%,构建统一具身大脑基座。
World-in-Context: Interactive Video World Modeling with In-Context Conditioning
提出World-in-Context交互视频世界模型框架,利用In-Context Conditioning将视角、动作与相机控制统一为显式Token。5B参数模型在WBench导航性能持平22B EchoWM,视角切换成功率达93.8%,显著优于同尺寸基线。
Ψ-0.6: Adaptive Streams of Thought in a Unified Vision-Language World Model
Ψ-0.6提出统一视觉语言世界模型,通过自适应思维流交织图像、文本与几何运动表征。该模型在多视角空间推理上零样本超越主流开源模型,支持反事实仿真,并经任务反馈强化学习优化中间表征选择,提升具身物理推理能力。
Reading, Writing, Sharing, and Interacting with the World through Video
该综述提出以世界建模为统一视角审视视频基础模型,将视频视为潜在时序世界的有损投影。研究梳理了读、写、共享、交互四类核心操作,指出领域重心正从片段级感知向持久状态预测、物理因果有效性及具身决策评估迁移。
AgentVQA: A Unified Benchmark for Agentic Visual Understanding
针对具身智能体视觉理解评测难题,AgentVQA基准整合机器人等五领域1000条真实样本。22个模型测试显示最优准确率仅58.5%,瓶颈在于视觉状态接地与3D空间推理,而非逻辑能力。
Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
论文提出Dual Exam基准,在物理及数字等四大领域独立评估多模态智能体与世界模型。GPT-6 Astra与GPT-Image-2分项领先,但150例耦合测试成功率为零,证实当前组件级能力无法直接转化为联合系统的互惠学习效能。
Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
针对VLA模型任务状态识别难题,Echo框架将停止与失败信号嵌入动作块维度并联合去噪。无需帧级标注即可学习状态,通过差异化去噪速率引导动作生成,在真实操作实验中显著提升策略执行成功率与鲁棒性。
F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
提出F2G-Pose框架,通过几何感知基础特征提升实现单次前向类别级6D位姿、尺寸及形状补全。在SOPE/ROPE数据集达SOTA,纯位姿推理28 FPS,代码与预训练模型已开源,验证了真实操作场景部署潜力。
FLORA: An Open Model Suite for Scaling Robotics Data Engines
面向GR00T训练的工业级数据引擎Flora正式开源,集成结果奖励、过程奖励及时间戳描述生成能力。系统在WGO-Bench等基准达SOTA,实测日处理20万小时数据,推理成本较GPT-6 Astra降低125倍,支持物理自研与人机迁移。
FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
针对VLA模型多视图利用率低的问题,提出FocusVLA框架。通过历史动作预测未来交互意图并动态路由全局/局部视图,在RoboTwin 2.0及真机测试中成功率分别提升10.1pp和13.3%,且无需修改核心架构即可集成。
HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
提出分层VLA智能体HiSTEVE,通过能力感知编排器与策略耦合检测器解决开放世界长程自主难题。在MineStudio Bench获85.0%原子任务得分,OpenHA平均成功率37.4%,实现纯视觉原生键鼠操控下的铁镐制作等复杂任务。
Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
研究显示基于原始历史的朴素RAG在LoCoMo等四大基准测试中六项排名第一,超最强智能体记忆0.13-5.53分。证实高证据覆盖率可弥补利用率不足,挑战了复杂记忆架构在对话任务中的必要性。
Skeleton-Grounded Latent Action Model for Robot World Models
针对潜在动作模型难以解耦机器人运动与场景变化的问题,提出SkeLAM框架。通过骨架监督分解运动学分量,在DROID数据集上末端执行器ADE降低19.5%,LPIPS降低11.1%,并实现零样本人机动作迁移与真实策略评估对齐。
UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
针对长程交互智能体评估难题,发布包含6.4万条真实用户轨迹的UserArena基准及OPTD算法。该方案支持五级评估体系与生产环境A/B测试离线验证,显著提升模拟器在长时序决策中的保真度与策略复现能力。
Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
针对AI训练随机采样痛点,提出依赖感知稀疏解码与DDRA编码方案。在机器人数据集上实测,同等质量下加载吞吐达LeRobot v3的1.45倍,媒体负载降低58.7%,有效破解视频存储跨帧依赖瓶颈。
Toward Recursive Self-Improvement in Physical AI
针对物理AI递归自改进难题,综述梳理从行为优化到生成过程优化的路径。提出反馈有效性、组件适配性、跨任务迁移及安全成本四大增益传递条件,指出当前研究虽证实操作任务行为提升,但尚未隔离出递归机制本身的独立收益。
ALPS: Visual State Encoders for World Models
ALPS通过联合预训练统一物理状态、语言对齐与像素重建能力。在LIBERO基准中,其ViT-B/16模型状态探测误差最低,冻结token配合文本塔实现85.5%策略成功率,并支持未来token直接解码为像素以供视觉检视。
Agentic World Action Models
AW-0框架采用混合Transformer架构联合生成代码、视频与动作,解决世界模型技能复用难题。在RoboTwin 2.0及物理双臂任务中,其任务成功率、语义推理及鲁棒性均优于VLA与WAM基线。
CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
针对扩散模型自运动漂移问题,CausalAlign通过Delta-Token空间对齐3D基础模型,使Wan2.2几何一致性提升超20%,RoboCasa365移动操作任务成功率提高10个百分点。
DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
研究提出通用双臂灵巧跟踪框架DONIC及包含1575序列的BiHOI数据集。通过PPO与行为克隆反馈闭环及物体中心奖励机制,单策略在未见轨迹上实现86.79%成功率,大幅超越现有双臂基线模型。
Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
针对自回归视频扩散模型物理演化建模不足问题,提出Future Chunk Prediction辅助训练目标。该方法无需额外预训练编码器,在更低算力预算下实现优于标准Teacher Forcing的物理合理性,并构建出更具结构化的表征空间。
Self-Distilling Future Video Representations for World Action Models
针对世界动作模型推理瓶颈,FRED框架利用自蒸馏与历史时序上下文提升单步去噪下的未来视频表征质量。在零样本环境泛化及人类视频技能迁移任务中,该方法将机器人执行成功率从19.4%提升至50.0%,显著优于现有竞争方案。
FrontierCS 2: A Benchmark for Computer Science R&D
FrontierCS 2基准包含48个开放式任务,覆盖机器人等13个计算机科学领域。评测显示Claude Opus 5.5通过率仅58%,16项任务零通过,揭示当前最强模型在复杂科研代码重构与系统级研发中仍面临显著瓶颈。
LaLa-World: Scaling Latent World Models with Natural Language Actions
论文提出LaLa-World语言条件潜世界模型,通过自然语言统一数值动作与视觉变化接口,实现跨域联合训练。其MPC规划性能优于现有LWM,训练成本降低6倍、推理提速13.9倍;下游策略LaLa-Policy在LIBERO等基准推理速度提升5.5倍。
Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
针对多模态智能体从计算机操作向机器人物理交互迁移的挑战,提出PAPAV统一能力框架。分析64个基准发现仅5个评估预测、3个评估验证,揭示物理约束下感知与执行评测失衡现状。
Steering Black-Box Large Language Model Agents with Pitfall Anticipation World Model
针对黑盒LLM智能体缺乏环境先验问题,提出陷阱预判世界模型PAWM。该模型仅在潜在失败点介入预测,经SFT与GRPO两阶段训练,使Claude Sonnet 4.5在ScienceWorld和WebArena-Lite基准上分别提升24.3%和7.7%。
From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
针对VLA模型在长程任务中缺乏历史依赖问题,提出SERA自进化机器人代理框架。该方法通过可编辑Harness维护任务上下文,利用环境Rollout自主优化规划配置。在RoboMME基准测试中,SERA整体成功率达51.38%,较无自进化基线提升7个百分点。
TARSphere: A Robot-Oriented Full-Stack Framework for Long-Horizon Embodied Agents in Evolving Physical and Social Environments
提出面向机器人的全栈框架TARSphere,含仿真基础设施、MLLM决策中枢及360条基准数据。评测8款多模态大模型显示通用模型优于专用具身模型,但在任务更新与人机协作上仍存瓶颈,强调执行安全评估必要性。
Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
研究通过120组配置验证具身智能持续预训练缩放规律,发现数据多样性显著提升相关世界迁移能力,而单纯扩大模型规模在远距离世界中泛化反而下降,揭示了构建通用具身智能体需超越单一CPT阶段。
AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
研究提出AgenticRoboRL框架,通过SFT与多轮强化学习后训练优化机器人规划器。在LIBERO-PRO基准上,9B参数模型任务成功率从18.1%提升至71.0%,逼近GPT-5.5水平,验证了开源小模型经后训练替代闭源大模型的可行性。
World Models with Configurable Perception
针对噪声干扰问题,ConfigWM通过语言引导的任务条件状态提取实现可配置感知。在多变干扰环境中,其规划成功率平均超最强基线22.3%,物理量探测Pearson r提升0.365,验证了任务相关状态表征的鲁棒性。
RoboCasa-Shift: Stage-Aware Robustness Evaluation of Vision-Language-Action Policies in Long-Horizon Household Manipulation
针对VLA模型聚合指标掩盖失败细节的问题,提出RoboCasa-Shift诊断基准。基于1040次GR00T N1.5实测揭示非单调退化规律,证实相同端到端性能损失对应不同执行阶段故障分布,代码已开源。
RoboJudge: Multimodal Language Models as Judges for Embodied Video Generation
研究推出RoboJudge-Bench评测基准与12K视频训练集,微调9B MLLM实现具身视频物理与指令对齐评估。该模型与人类评分Pearson相关性达0.719,显著优于Gemini-3.7-Flash等通用大模型,填补了具身世界模型自动化评测缺口。
Not All Features Are Created Equal: A Mechanistic Study of Vision-Language-Action Models
研究通过可解释性管线发现pi0.5等VLA模型动作专家绑定绝对坐标,导致场景微扰即失败。在UR10e实机验证中,激活注入使99.6%回合执行错误轨迹,目标位移10-15cm后抓取完全失效,开源Action Atlas平台含520+个SAE与79个概念。
WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
提出WorldStream开放式3D世界模型,通过宏微观分层规划器与确定性编译机制,实现超地图边界扩展、自然语言交互及编辑状态持久化。该架构在有限算力预算下支持 tiles 独立规划与无缝连接,为具身智能提供可交互的无限仿真环境。
Nonequilibrium energetics of sensing and actuation by a smart active particle
该文针对智能主动体能量分配问题,提出自转向粒子最小模型,并在不同任务几何中揭示热力学权衡。
ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
研究团队发布ACE-Brain-0.6,通过统一数据管线整合机器人操作与多源视觉数据,构建150万可验证空间接地监督样本。基于Qwen3.5-9B微调后,该模型在7项公共基准中4项超越GPT-6 Astra,均分达75.41,证实规模化接地数据可显著提升开源小参数模型的具身空间感知能力。
Design and Implementation of a Microservice-Architecture Master Control System for AIMS
面向 AIMS 高自主观测需求,论文设计微服务主控系统,并在三台望远镜不同自动化等级上验证稳定性。
MORPHIT: Flexible spherical approximation of robot morphology for representation-driven adaptation
MORPHIT通过梯度优化自动调节机器人形态的球形近似,并在定量评估和机器人基础设施集成中验证。
Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
针对全模态大模型跨模态幻觉难题,提出免训练框架Omni-Woodpecker。通过正交分解与冲突条件重平衡机制,在Qwen2.5-Omni-7B上使CMM和AVHBench基准分别提升12.9和8.6分,代码已开源。
Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
提出WildAWM流水线,利用开源模型合成支持GUI、MCP及CLI的341个长程任务环境。经执行质量门控验证,GPT-6-Astra解决率仅60%。Qwen模型在该合成数据上训练后,在8个OOD基准中实现泛化提升,代码已开源。
BiDex-100: A Comprehensive Benchmark for Bimanual Dexterous Manipulation Across 100+ Simulation Tasks
针对双手灵巧操作评测缺失痛点,BiDex-100提供106项仿真任务与8080条验证过的遥操作演示(625万帧),覆盖泛化、指令遵循等五大能力轴,并为7款主流VLA模型建立统一性能基线。
TILDE: Teacher-in-the-Loop Distillation from Embodied Foundation Models
针对具身基础模型复现成本高的问题,提出TILDE蒸馏框架与AutoDAgger自主数据聚合管线。该方法融合在策略蒸馏与教师恢复轨迹学习,无需人工监控即可收集纠错数据,在三项真实机器人任务中性能较行为克隆提升最高4.1倍。
The hive mind is a single reinforcement learning agent
论文证明局部模仿规则产生的群体认知等价于单个在线RL智能体,并在蜜蜂摇摆舞加权投票模型中分析。
Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
提出LayerEditor统一框架,通过上下文RGB-Alpha令牌建模与组合编辑先验蒸馏,实现指令驱动编辑与可控RGBA图层生成解耦。配套发布LayerEditor-100K数据集及评测基准,支持具身场景分层操作与资产复用。
Not All Actions Contribute Equally: Learning Precise Progress Estimation from Imprecise Demonstrations
针对示范中动作贡献不均的问题,PRIME用跨轨迹图和最短路学习进度估计,并在仿真与真实精密操作中验证。
Beyond Success Rate: Interventional Evaluation of Memory in Vision-Language-Action Systems
提出 IMEP 在 VLA 系统中干预评估记忆作用,并在多类记忆与 ChainBench 上验证其影响。
From Sliding Windows to Self-evolving Lifelong Memory: A Dual-perspective Survey of Memory Paradigms for Long-Horizon Robotics VLA Models
该综述针对 VLA 长时程任务记忆不足,按范围与持久性建立分类,并在代表性系统上比较分析。
Simultaneous Force and Motion Control in Generalised Coordinates
针对接触约束下机械臂力与运动控制可行性难题,方法在广义坐标中构建QP,并在MuJoCo仿真验证。
Robotic Spatiotemporal Editing: A Unified Interface for Controllable Action Generation via Masked Action Reconstruction
该工作面向多样时空参考下的可控机器人行为生成,提出MAP接口与补全策略,并在ManiSkill、LIBERO-10及真实实验验证。
Pedicel-Targeted Strawberry Harvesting via Imitation Learning on a Low-Cost Teleoperated Robotic Arm
面向草莓果梗精准采摘,提出视觉运动模仿学习流水线,并在低成本遥操作机械臂与边缘平台上验证。
Reinforcement Learning Based Multi-Terrain Adaptive Whole-Body Control for a Quadruped Manipulator
针对复杂地形下四足机械臂末端任务一致性难题,提出强化学习全身控制框架,并在小型平台实地验证。
Blind Precise Assembly: Proprioceptive Sim-to-Real Peg-in-Hole for Diverse Parts
研究仅凭关节本体感知的盲装配策略,用仿真强化学习训练,并在多类装配仿真和真机插销中验证。
No Eyes, No Problem: What Does Touch Contribute to Blind Baoding Ball Manipulation?
研究无视觉持续保定球操控,结合传感器对齐仿真、触觉校准和域随机化,在Shadow Dexterous Hand Lite真机上验证零样本迁移并分析触觉作用。
Embodiment-Aware Planning for Heterogeneous Bimanual Manipulation
针对单一简单夹爪难覆盖复杂操作约束的问题,提出具身感知有限时域优化规划,并在异构双臂平台验证。
Structured Perception Representations for Off-road Dynamics Learning
提出SpatialBEV利用预测状态周围BEV特征学习越野动力学,并在跨季节数据集和高速真机路线验证。
What Makes a Good Symbol for Hybrid Discrete-Continuous Planning?
本文从推理算法视角定义有用符号,并在仿真与真实机器人任务中验证其可降低求解成本且保持解质量。
Enhancing Visual Task-Redirection Attacks on Vision-Language-Action Models via Closed-Loop Optimization
提出 TRACO 以闭环优化增强定向视觉攻击,并在多个 VLA 模型和仿真环境中提升任务重定向成功率。
Sample-Efficient Reinforcement Learning for Policy Improvement via Flow-Reversed Action Anchors
AnchorQ用流反转动作锚与价值引导采样提升通用机器人策略,并在仿真和真实操作任务中验证。
Unifying Embodied Foundation Models via a Model-to-Policy Formulation
针对 VLA 与 WAM 的架构和目标差异,提出基于随机核的架构无关概率表述,并在 OpenVLA 和 DreamZero 上实例化。
Look Before You Act: Bridging Active Perception and Vision-Language-Action Models via Observation-Aligned Data Adaptation
提出ActiveAlign,使VLA在主动感知终止状态上训练,并在LIBERO任务和真实遮挡场景验证成功率提升。
Learning Robot Metareasoning: Adaptive Computation Budgets for Real-Time Control
该论文将实时控制中的计算预算选择建模为SMDP,并用强化学习策略在多类机器人任务上自适应分配规划时间。
Encoding tactile stimuli for Braille recognition with organoids
研究将触觉传感器数据映射为电刺激模式,使神经类器官在开放环人工触觉盲文分类任务上得到验证。
Shape-Aware Neural Time Fields for Rigid-Body Motion and Manipulation Planning
针对杂乱环境中位姿耦合的刚体运动规划,提出 Shape-Aware Neural Time Fields,并在2D/3D规划和推物操纵中验证。
Adaptive Code Generation for Controlling Robots
提出双AI机器人控制框架,用LLM生成受限可执行代码、VLM提供语义扎根,并在前沿模型基准中验证。
An amphibious untethered inchworm soft robot for fast crawling locomotion
面向软体机器人无缆部署,提出磁力驱动的尺蠖式软体机器人,并通过实验表征验证其多模态运动能力。
Foundation-Model-Driven 3D Scene Graphs for Mobile Manipulation
将FOUND-IT集成到移动操作平台,以基础模型驱动3D场景图作为空间记忆,并在实机实验中验证多种移动操作能力。
Compositionally Safe Construction of Autonomous Driving Systems
研究基于驾驶操作协调执行的组合式方法,构建安全ADS,并以组合性结果证明其适用性。
Foundation Models for Autonomous Space Robotics: Architectures, Physical Adaptation, and Validation
本文综述基础模型如何通过感知、预测、规划与动作支撑自主空间机器人,并在轨道操作和近距离操作验证路径中分析。
AWAM: Active Trajectory-Conditioned View Imagination for Robust Robot Manipulation
AWAM通过主动规划观察并沿轨迹想象视图,结合世界模型与扩散动作预测,在仿真基准和真机试验验证稳健操作。
BeJEPA: A Goal-Conditioned Humanoid Behavior World Model via Unsupervised RL
BeJEPA用无监督RL和JEPA学习目标条件行为世界模型,并在运动跟踪与Unitree G1真机上验证。
CoEvolve: Self-Evolving Code Policies from Skills to Strategies for Humanoid Robots
CoEvolve将团队协作表示为固定运动技能上的可执行代码,并以验证引导演化,在双仿真Unitree G1搬运任务中验证。
DefFlow: Goal-Conditioned Deformable Object Manipulation using 3D Point Flows
DefFlow通过联合预测机器人与可变形物体的目标条件3D点流,实现面向多种3D目标形态的操作,并在仿真设置和真实机器人上验证。
Ego2Contact: Predicting Touch from Egocentric Human Video for Contact-Rich Robot Manipulation
Ego2Contact从人类第一视角视频学习视觉-触觉先验,迁移到机器人手,并在人体、机器人数据及仿真/真机策略中验证。
GR-VIP: Geometric representation conditioning for precise visuomotor policy
GR-VIP利用相对相机位姿预训练视觉编码器的稠密关系特征,解决移动机器人精确目标相对控制问题,并在真实对接任务中验证。
GRASP: Global-Local Representation Alignment and Spatial-Physical Grounding for Bimanual Robotic Manipulation
针对关节空间VLA训练目标与任务成功不一致,GRASP注入物理与视觉先验,并在仿真和真机长程双臂任务验证。
HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
HexaShell以轻量框架让VLM编码智能体通过命令行控制双臂机器人,并在RoboDojo 42项任务上验证能力边界。
InstAgent: A Recursively Self-Improving Agent Operating System for Heterogeneous Robot Collaboration
针对异构机器人协作中的经验复用、上下文记忆与依赖建模难题,InstAgent以行为树和共享多模态时空记忆组织协作,并在真实多机器人任务上验证。
LAW: Unifying Language, Action, and World Modeling for Agentic Physical Intelligence
LAW通过闭环VLM-WAM统一语言推理、动作生成和世界建模,在RoboTwin与长程真机任务上验证。
Language Models Learn to Improve Language Models
提出LM2LM框架,通过研究世界模型(RWM)作为奖励代理解决AI研发RL训练高成本难题。Qwen3.8-27B在8个环境中超越GPT-6-sol,数据生成成本降低33%,验证了具身与基础模型递归优化的可行性。
LonGaussian: Tracking Foundation Priors for Long-Context Feedforward Gaussian Reconstruction
LonGaussian面向长图像序列重建,结合流式前馈框架、点轨迹合并与深度一致性过滤,在DL3DV和RealEstate10K验证。
LY-GWM-RoboCasa-Human300: Prediction-Guided Action Selection with a Graph Dynamics Model
该策略用图动力学预测与二值状态奖励从动作候选中选择,在RoboCasa任务本地和官方评测中验证。
MambaAct: Efficient Mamba Action Experts for Flow-Matching Vision-Language-Action Models
针对流匹配VLA实时控制推理开销,MambaAct以Mamba动作专家替换Transformer专家,并在LIBERO和真实部署验证提速与性能收益。
MOSS: Multimodal Origami Swamp Robot System
MOSS用3D打印折纸轮和曲柄变形机制解决湿地水陆多地形适应问题,并在土壤、沙、泥和水中验证。
NestedVLA: Learning to Consolidate and Generate Skills for Vision-Language-Action Models
NestedVLA用任务条件超网络生成动作专家参数,整合异构技能,并在三个RL基准上验证效果。
ORD-WM: Learning Object-Centric Rigid Dynamics for 3D World Modeling in Robotic Manipulation
ORD-WM通过学习以物体为中心的刚体动力学,在仿真和真实操作场景中验证3D世界预测与重规划。
PASS-VLN: Passability-Aware Local-Command Vision-and-Language Navigation
PASS-VLN面向身体约束下的局部VLN执行,结合可通行性基准与模型,并在实验、规划集成和真实部署中验证。
RoboHarness: A Simple Harness Outperforms VLA and World Action Models
研究提出RoboHarness框架,通过视觉几何控制面板赋能LLM代理执行具身任务。Qwen3.8-Flash-Next在该架构下于BEHAVIOR Challenge 2025中超越主流VLA模型,代码已开源,验证了编码代理替代端到端动作生成的可行性。
SenseSwarm: Swarm Exploration via Neural Structure Estimation with Shared World-Anticipation for Rapid Mapping
SenseSwarm在共享占据地图上预测未知结构并引导去中心化群体,在真实楼层基准的仿真中加速地图重建。
Structural Affinity: An Algorithm for Coherent Cage-Based Shape Design
针对 CBD 优化中的网格畸变,提出 Structural Affinity 双笼耦合方法,并在三类形状设计任务中验证。
VLA-Fabric: Learning Interaction for Composable Multi-Arm VLA Agents
针对多臂 VLA 动作生成中的协同问题,VLA-Fabric 为每臂配置完整 VLA 并学习跨策略交互,在仿真和物理实验中验证。
Training-Free Target-Aware Refinement of 3D Gaussian Language Map
提出免训练目标感知优化方法,改进已蒸馏3D Gaussian语言地图,并在三个基准和真机演示中验证。
Benchmarking 3D Reconstruction for Under-Ice Robotic Perception in Arctic Environments
针对北极冰下视觉感知难题,发布包含MOSAiC实测与Unreal Engine仿真数据的3D重建基准。通过跨模态配准多波束声呐真值,量化评估SfM与单目深度估计在弱纹理、低光照环境下的重建精度,填补冰下光学感知评测空白。
Discontinuous-Property Mechanical Metamaterials: A Framework for Discontinuous Lattice Dynamics
该工作面向不连续晶格系统,提出DPMM并以几何正则化扩展带理论,在响应分析和概念验证实验中验证。
Finite-Time Guarantees for Constrained Reinforcement Learning under Partial Observability
针对CPOMDP中奖励最大化与成本约束问题,采用有限历史窗口和原始-对偶算法,并在部分可观测网格世界验证。
From Optical Flow to Safety: Visual Safety Certification via Scale-Free Relative Motion
该文面向单目自主导航安全,利用光流编码的深度归一化相对运动构建RV-C^3BF,并在仿真和TurtleBot3实机上验证避障。
Cross-Embodiment Causal Transfer from Human Videos to Robot Manipulation
针对人类视频难以直接监督机器人动作的问题,CBST以因果束选择语义条件,在机器人操作基准验证成功率提升。
Slip-Induced Fall Suppression During Cornering for a Remotely Operated Motorcycle with a Rear-Wheel-Swing Mechanism
针对摩托车转弯滑移诱发摔倒,提出按车速和路面条件分配辅助控制输入的优化方法,并在遥控摩托车实验中验证。
Manifold Generative Annealing for Contact Constraint-aware Impedance Control with Reinforcement Learning Prior
提出 MGA 联合无模型与模型生成框架,优化接触任务中的运动与阻抗,并在三类任务上验证。
Learning Rational Strategies for Temporal Objectives in Multi-Agent Systems
研究未知动态随机多智能体系统的理性合成,用MARL与奖励自动机学习策略,并在8个一般和并发随机博弈中验证。
Disagreement-Guided Weak-to-Strong Routing
针对弱模型部署中何时调用强模型的问题,提出基于模型分歧的无监督路由,并在智能体式和单轮任务上验证。
Vision-Guided Closed-Loop Autonomous Navigation of Light-Driven Janus Microbots
针对微米尺度动态导航难题,框架融合 YOLOv11 视觉定位与航点磁控,并在轨迹、迷宫避障和货运中验证。
When to Ask for Help: A Decision-Theoretic Account and Measurement Standard for Slow-Module Scheduling in Dual-System Vision-Language-Action Models
将慢模块调用形式化为VoI决策,并在测量系统、LIBERO闭环与部署轨迹上验证调度标准。
Safe Reinforcement Learning with Receding-Horizon Safety Critic and Differentiable Action Shields
针对机器人强化学习中安全故障的时序滞后性,提出后退视界安全评论器与可微CBF滤波器。该方法通过预测未来状态安全性并最小修改策略动作,在四足仿真中显著降低噪声与地形扰动下的灾难性失败率。
What Should Robot Policies Learn to Predict? Rethinking Supervision Targets in Vision-Language-Action Learning
论文用带样本级路由的统一 VLA 框架研究监督目标分配,并在 LIBERO、CALVIN 与四个真机任务上验证。
Scaling Online Exploration for Robot Agents
RAX通过在线探索让机器人智能体生成可执行程序,在仿真与真机多形态操作任务上验证其泛化和自改进能力。
Regions of Attraction of CBF-Based Safety Filters for Stable Planar Linear Systems
研究CBF安全滤波器诱导的动力学,用平面线性系统参数刻画,并以车辆侧偏和三维示例说明。
A 2D Image Feedback-Based Autonomous Endovascular Navigation Method: A Perception and Control Framework
针对血管内自主导航的二维图像反馈难题,提出中心线图与规则控制框架,并在物理双器械平台的模拟平面图像闭环运行中验证。
Plans Are Not Executions: Adapting Frozen World-Model Planners to Controller-Induced Execution Shift
针对冻结世界模型规划器的规划-执行差距,ExecutionBridge利用规划-执行轨迹对适配自车潜变量,在NAVSIM验证。
Memory as Weights: Internalizing Long-Term History for Streaming Videos
MaLoW将历史上下文内化为轻量参数更新,用于流式视频理解,并在多个基准及VLA模型上验证。
Towards bio-inspired visual navigation: a neuromorphic navigation paradigm for MAVs
提出端到端事件驱动神经形态范式,结合事件视觉、SNN与处理器,在仿真和真实部署中验证MAV复杂环境视觉导航。
Ablation-Driven Selective Laser Direct Mass Transfer for Micro-LEDs with High Speed, Enhanced Gap Tolerance, and High Precision
针对 Micro-LEDs 巨量转移瓶颈,提出 D-DLAT 以烧蚀冲击主动推进芯片,并在不同尺寸转移、图案化和阵列重排中验证。
Attribution-Gated Joint Estimation of Intention and Capability for Assist-as-Needed Upper-Limb Robots
针对AAN难分意图运动与自愿力矩能力变化,提出归因门控MHE-MPC,并在健康受试者目标与疲劳任务中验证。
Multi-Teacher On-Policy Distillation for Flow-Based Vision-Language-Action Models
针对多领域VLA技能难以整合,提出两级在策略蒸馏,并在LIBERO-40、CALVIN和Meta-World MT50验证。
Trajectory-based Diffusion from One-shot Human Video for Generalizable Manipulation
TDV从单次人类视频提取物体轨迹并生成数据,缓解视觉与具身差异,在RLBench仿真和真实实验验证可泛化操作。
Sub-Millisecond Reflexes for Continuous Physical Human-Robot Interaction
针对连续物理人机交互中的控制切换延迟,提出开源ROS 2兼容反射引擎,并在Franka机械臂上验证。
CBF-Based Control Allocation for Omnidirectional Tiltrotor Aerial Robots
针对倾转空中机器人重构时期望力旋量可能不可行,提出CBF分配器,并在MuJoCo机动仿真中验证。
Safe and Fuel-Efficient Motion Planning for Lunar Propulsive Drones
提出视觉引导最优控制运动规划框架,用于月球推进式无人机在指定航点间安全省燃料跳跃,并在高保真月球仿真中验证。
An Agentic Framework for Proactive Robots with Procedural Assistance Memory
提出基于 PAM 的智能体框架,用 VLM 预测任务、VLA 执行,在5天桌面辅助评估中验证主动协助。
Policy-Aligned Predictive Verification for Adaptive VLA Action-Chunk Execution
针对VLA动作序列执行长度选择,提出PAV在内部任务条件表示空间评估候选前缀,并在LIBERO、RoboTwin 2.0和真实操纵中验证。
Robust Reinforcement Learning for Dynamic Treatment Regimes under Model and Measurement Uncertainty
提出鲁棒强化学习框架,在临床数据校准的转移性前列腺癌模拟器上学习可靠自适应治疗策略。
Evaluating Inquiry Learning in LLM-Based Agents: Hypothesizing, Reasoning, and Exploration
提出统一交互框架评估 LLM 探究能力,在扩展 Countdown 数学环境中验证探索、因果发现与假设改进。
Learning Intrinsic Dynamics in Latent World Models
针对视觉变化掩盖动作—结果关系,提出以动作可预测性约束潜在表征,并在Push-T多外观潜在规划中验证Concat IDM。
The Tilted Sampling Problem: Optimism, Posterior Sampling, and Logarithmic Regret
本文研究未知奖励诱导Gibbs分布的在线倾斜采样,提出采样遗憾框架与UCS、TS^2并给出对数遗憾理论保证。
Specification Gaming and a Constrained Reinforcement Learning Mitigation in a Cleaning Gridworld
该文在清洁 Gridworld 中构造代理/真实目标缺口,用约束强化学习惩罚利用行为并验证可消除规格博弈。
A Flow-Theoretic Multimodal Control Framework Fusing Mental and Physical Engagement for Upper-Limb Rehabilitation
针对AAN难辨肌肉无力与心理不投入,融合EEG与sEMG参与度进行自适应阻抗控制,并在健康受试者上验证。
Modular Inverse Dynamics and Wrench Recovery for Closed-Chain Mechanisms Using Path Assembly
针对闭链内反力不定问题,提出路径装配逆动力学与力旋量恢复流程,并在七自由度重载混联机械臂规定运动上验证。
Comfortably Stuck: Evaluation Pitfalls in Bench2Drive's Closed-Loop Protocol
指出Bench2Drive闭环评估会误判E2E驾驶模型,提出距离式舒适度修正,并在CARLA仿真八个模型及UniAD、VAD上验证。
Asking Smarter Questions: Targeted Active Preference Learning for Underspecified Rewards
针对人类示教难以覆盖全部任务特征的问题,提出定向偏好查询与解释方法,并在仿真和用户研究中验证。
Coverage-Preserving Self-Healing in Partially Observable 3D UAV Swarm Networks via an Advection-Diffusion Graph Transformer
面向受损后全局可观测性受限的UAV集群通信网络,提出AdDiff-GT并在分区仿真场景验证拓扑恢复与空间保持。
Robust Multi-Agent Pursuit with Preemptive Communication via Reachability-Based Control Barrier Functions
针对间歇通信下多智能体安全追捕,提出统一控制/通信策略,并在追逃仿真中验证零碰撞与减通信。
Auditable and Deployable Multi-Agent Motion Planning via Posetal Games from Legal Guidelines
针对法律约束下多智能体运动规划,提出基于法律指南的偏序博弈框架,并在海上多船相遇中验证。
Quantum control of solid state qubits via Reinforcement Learning
本文用仿真分析无模型强化学习在自旋浴中NV核自旋间接控制的态制备与量子门设计表现。
Inertially Significant Humanoid Teleoperation via Whole Body Model Predictive Control and Online Parameter Estimation
针对重工具或大载荷导致的惯性变化,结合WB-MPC与EKF在线估计参数,并在人形系统仿真和硬件实验中验证。
De-Risking Robotic Welding for In-Space Metal Joining Through Physics-Grounded Digital Twins
面向在轨金属连接焊接表征不足,提出物理基础数字孪生原型,并在交叉验证、边界案例和仿真机械臂焊缝中评估。
Provably Efficient Risk-Sensitive Offline Reinforcement Learning via Optimized Certainty Equivalents
本文用OCE统一刻画风险度量,设计悲观值迭代/最小二乘值迭代,在表格与线性函数逼近设置下给出离线风险敏感RL理论保证。
Diffeomorphic Hidden-State Steering: Improving Imitation Learning Policy Robustness through Expert Hidden-State Geometry
针对闭环执行中误差累积问题,DHS利用专家隐藏状态几何在测试时引导,并在四个仿真操作任务验证提升抗观测噪声成功率。
A Mode-Unified, Continuous, and Biomimetic Control Strategy of a Robotic Lower Limb Prosthesis
研究提出模式统一下肢假肢控制框架,利用RBF插值融合坡度与步态相位,单FSM控制器实现平地至35度坡梯连续自适应。10名截肢者实验验证膝踝运动学拟合度达0.78-0.99,无需分模式调参。
Constrained Multi-Agent Reinforcement Learning in Imagination
针对约束多智能体强化学习的交互效率问题,CA-MAMBA用多智能体世界模型预测成本并在想象中更新,在SMAC和MAMuJoCo验证。
Learning Changes the World and Then What Was Learned has Changed: Training and Deploying Neural Networks in the Control Loop
针对闭环控制中离线训练神经网络引发的分布偏移,提出失效分类与在线适应策略,并在非线性Duffing振子上验证。
A team of Gemini 4 Argon agents beats Minecraft
四个 Gemini 4 Argon 智能体通过 Mineflayer 自主协作,在沙盒 Minecraft 生存世界击败末影龙。
Bellman-Consistent Trajectory RL for LLM Arithmetic Reasoning
针对 LLM 算术推理终端奖励稀疏问题,提出 Bellman 一致轨迹 RL,并在 Countdown 任务上验证。
Onboard Lightweight LLM Reasoning for Human-Aware Safe UAV Navigation
针对UAV将人、车、墙同作占据几何的安全缺口,提出机载BLIP与轻量LLM管线,并在Gazebo导航与着陆中验证。
Dynamic properties and motion reproducibility of a compact pneumatically actuated humanoid upper body for data-driven control
该研究面向气动高自由度机器人控制难题,分析13自由度上半身动态特性,并在4自由度手臂子系统验证数据驱动控制。
Sim-to-Real Reinforcement Learning for Path-Safe Target Reaching in Robotic Harvesting of Hydroponic Lettuce
提出PSA-PPO解决水培生菜采收中受限空间安全到达问题,并在仿真与UR10e温室采收系统上验证。
End-to-End Vision-Language-Action Policies for Autonomous Lunar Rover Docking
研究提出面向月球车自主对接的端到端视觉-语言-动作策略,通过高保真仿真生成安全感知专家数据训练。闭环测试显示其在未见感知扰动下性能对标模块化基线,自适应执行地平线机制有效降低推理频率并限制危险接触率。
Minimizing Age of Incorrect Information in Pull-Based Remote Estimation of a Markov Source
研究基于拉取的DTMC源远程估计,用SMDP、belief-MDP和CDRL在ZD与UD信道模型下最小化MAoII。
Learning Self-Orchestration in Decentralized Agent Swarms
提出MPT,通过竞价联合学习动作策略与自编排,并在具身制作、机器人导航和深度研究上验证收益。
Perceptual Comparisons of Viscoelastic Renderings: Fractional- vs Integer-Order Models
研究粘弹性材料触觉渲染的逼真度,比较FO-SLS与整数阶模型,并通过人体实验验证其感知优势。
Active Visual Perception: Opportunities and Challenges
本文综述主动视觉感知,提出闭环分析与评估框架,并从数据集、交互环境和物理平台讨论验证方式。
Can Autonomous Vehicles Keep Their Cool? A Survey of Thermal Side-Channel and Perception Attacks
该综述面向AV热感知与热遥测残余风险,系统化十三项工作,并用商品代理支持软件共租户分支。
Promoting arm movement practice with a novel wheelchair armrest early after stroke: a randomized controlled trial
研究以随机对照试验评估轮椅安装康复装置 Boost 在卒中住院康复中促进上肢自练的可行性和初步疗效。
All-in-One Memory: Process-Rewarded Reinforcement Learning for Memory Agents
AiO-Mem将检索、写入与停止建模为共享证据状态上的轨迹,用过程奖励强化学习优化记忆策略,并在长上下文记忆基准上提升答题准确率。
Anvil: Scaling Embodied Spatial Intelligence through Knowledge Recirculation
Anvil通过知识循环统一数据生成、训练与评测,提升具身空间智能,并在七个公开基准上验证。
AVALON: Zero-Shot Indoor Navigation with Human-Seeded Topological Memory
AVALON面向机器人未见但用户熟悉的室内环境,以人类播种分层空间记忆实现拓扑导航,并在Unitree Go2任务上验证。
BridgeAfford: Bridging Query-Target Gap for Generalizable 3D Affordance Grounding
针对未见物体3D功能区域定位泛化差的问题,BridgeAfford通过区域对齐与视觉证据聚合,在LASO和PIAD上验证有效。
CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
CarryOn通过双循环增强冻结VLA策略,面向个性化可靠机器人辅助,并在真机与仿真中验证。
CF-Splat: Closed-Form Triangle Splatting with Mesh Priors
CF-Splat在已知网格和标定相机上将外观估计化为线性最小二乘,并在多种真实数据集验证高效NVS。
CLAD: Keypoint Matching Using Global Line Correspondences
CLAD利用线对应的全局几何上下文表征关键点,并在TUM RGB-D SLAM和户外视频序列上验证匹配效果。
CLIS-MPPI: Closed-Loop Model Predictive Path Integral Control With Initial-State Sampling Under Execution Delay
针对执行延迟导致的状态不匹配,提出CLIS-MPPI,并在UR5e真实窄通道任务中验证。
CoDA: Co-Evolution of Data Engines and Action Policies
CoDA让仿真数据引擎与动作策略通过共享记忆协同进化,并在操作任务与LIBERO-Pro上验证提升。
Compliant GMT: Making General Motion Tracking Compliant via Residual Reference Adaptation
C-GMT通过基于本体感知历史的残差适配器,为预训练GMT引入顺应性,并在仿真和真实G1实验中验证。
Contact-UAN: Unsupervised Actuator Networks as a Residual World Model for Humanoid Control
针对仿真策略迁移硬件时力交互失效问题,提出Contact-UAN残差世界模型。仅用6.5分钟实机数据训练,实现运行扭矩降低20%、力跟踪误差减少43%,支持精准阻抗控制与动态跳跃。
CQDC-Warp: GPU-Accelerated Differentiable Quasi-Dynamic Simulation for Contact-Rich Manipulation
CQDC-Warp面向接触丰富操作轨迹合成,提供GPU可微准动态仿真用于批量MPC,并在Allegro手内旋转等实验验证。
DemoStream: Batched Task-and-Motion-Plan Optimization for Automated Learning from Demonstration
DemoStream通过批量TAMP采样与约束满足优化演示质量,并在仿真消融和真实世界演示采集中验证。
DexMimic: A Generalist Dexterous Hand-Object Tracking Policy via Value-Guided Reset Allocation
针对灵巧操作技能复用难题,提出DexMimic通用策略与价值引导重置分配机制。实验验证了训练效率提升、零样本泛化能力及真机部署有效性,并开源涵盖训练、微调与泛化的全链路基准测试集。
E2DRL: End-to-End Differentiable Reinforcement Learning for 3D Obstacle Avoidance in Quadruped Robots
提出E2DRL框架解决腿足机器人视觉避障梯度断裂难题,通过软可微碰撞与SAPO教师策略蒸馏,在Unitree Go2上首次实现端到端可微强化学习的3D避障Sim-to-Real部署。
EliteReplay: Preserving Diverse Solutions in RL Post-Training via Quality-Diversity Search
EliteReplay用质量-多样性搜索构建精英档案并结合GRPO,在多个text-to-SQL任务上提升准确率并保留解法多样性。
FACT: A Multimodal Force-Action-Track Foundation Model for Human-to-Robot Dexterity
提出FACT基础模型与EgoForce大规模人类触觉数据集,通过视觉规划与力觉精炼级联架构解决人机数据异构难题。仅用10条机器人轨迹微调,成功率较T-Rex提升60%,验证了力觉监督在跨具身知识迁移中的关键作用。
FALCON: FPGA-Accelerated Latency-Certifiable Occupancy Networks for Camera-Based Autonomous Driving
FALCON在嵌入式FPGA上构建摄像头3D占用前端,通过分层延迟保证与看门狗,在代理和完整管线上验证时延与精度。
Fast-VLA: You Only Think Once for Robot Manipulation
Fast-VLA通过每回合一次调用冻结4B VLM构建任务记忆,在RoboTwin和LIBERO评测中验证机器人操作策略加速。
FastVLA: Task-Conditioned and Temporally Adaptive Visual Token Compression for Efficient Vision-Language-Action Models
FastVLA以任务注意力和时间自适应压缩视觉 Token,在仿真与Franka真机上提升VLA推理效率并保持成功率。
FutureLift: Lifting Trajectory Proposals into Bidirectional Future Graphs for Motion Forecasting
FutureLift将多模态轨迹提案表示为异构未来图,对自动驾驶运动预测候选进行残差细化,并在Argoverse2和WOMD验证。
GeoPano: Towards Geometrically Accurate 3D Reconstruction from a Single Panorama
GeoPano面向单张全景图3D重建,通过全景感知注意力与混合监督恢复一致点云,并在实验中优于既有SOTA。
GeoState: Learning View-Decoupled Geometry States for 3D World Modeling
GeoState将多视角GFM特征聚合为视图解耦场景状态,用于预测3D世界建模,并在Waymo、KITTI和nuScenes验证。
Has GPT-6-Astra Achieved Embodied Intelligence?
报告评估GPT-6-Astra的机器人操控与导航能力,结合ICL、代理式控制和真机部署,在12个基准与8种机器人配置上验证。
GRID-Planner: Graph-Structured Relational Reward Shaping for Diffusion Planning
针对复杂多智能体交互下的自动驾驶闭环规划难题,GRID-Planner用图关系奖励整合扩散规划,并在nuPlan和interPlan验证。
KODA: Kinematics--Observation Data Alignment for Humanoid Learning from Human Egocentric Demonstration
KODA将第一视角人类RGB演示转换为全身VLA训练数据,并在Unitree G1四个移动操作任务和两种控制器上验证。
LIBERO-PeRM: Benchmarking Personalized Robotic Manipulation
提出LIBERO-PeRM,用受控仿真偏好学习基准评测具身智能体的个性化操作,并在五个任务套件上实验。
LICOA: Learning Instruction-Conditioned Optical Actions for Mobile Spatial Augmented Reality
LICOA针对SAR中位姿、区域或路径预设问题,用移动底盘、2DoF镜和多相机接口学习指令条件光学动作,并在未见真实环境闭环任务验证。
LIN-SLAM: Lightweight LiDAR--Inertial Neural SLAM for Real-Time Onboard Navigation
LIN-SLAM融合几何LiDAR惯性估计与神经隐式建图,在多数据集和Go2真机上验证实时机载SLAM。
LTM: Latent Transition Based In-Context Memory for Vision-Language-Action Models
针对操作中需记住不可见交互的问题,LTM以连续观测的潜在转移存储历史,并在RoboMME、LIBERO-Mem和真机计数上验证。
MAGMA: Multiplier-Augmented Geometric Motion Algorithm
针对受约束高维机械系统最优控制难题,提出基于AGHF和增广拉格朗日的MAGMA,并在多类受限轨迹生成问题上验证。
MAIA: Anticipating Interaction Anomalies in Contact-Rich Manipulation via Multimodal World Models
MAIA用视觉-动作-力世界模型预测计划动作后果并提前预判接触操作异常,在真实多模态数据集和新旧任务上验证。
Mem4Act: Learning Effective Latent Memory for Long-Horizon Robotic Manipulation
Mem4Act通过固定大小潜在记忆学习,解决长程机器人操作中的记忆依赖控制,并在RoboMME、RMBench和四项真实任务验证。
MemComposer: Learning to Assemble Memories for LLM Agents via Reinforcement Learning
MemComposer通过强化学习按查询组装LLM智能体记忆,并在τ^2-bench三领域和两个冻结执行器上验证效果。
MetaShare: Failure-Aware Collective Self-Improvement for Open-Ended Agents
MetaShare通过记录成败修改和跨谱系检索,帮助开放式智能体避开失败路径,并在多类任务实验中验证效果。
MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
MJev-Spatial面向交互速率空间判断,将选择、数值和点预测统一为分类,并在空间问答与12个基准上验证。
MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
针对长程自主机器学习工程优化,提出后训练方法训练MLExpert,并在MLE-Bench Lite等任务上验证。
MOSS: Mode-Oriented Source Shaping for Robot Flow Matching Policies
针对生成式操作策略难以主动控制执行模式,MOSS通过模式特定高斯源选择生成起点,并在仿真和真实操作任务上验证。
MR-MPCC: Model Predictive Contouring Control for Robotic Manipulator Tracking under Moving Reference Frames
提出MR-MPCC以降低移动参考系下机械臂路径跟踪误差,并在ROS2--MuJoCo与UR5e平台验证。
MuSTMM: Learning Sound-Triggered Mobile Manipulation across Multiple Scenes
针对未见场景STMM评估不足,提出MuSTMM并引入显式空间记忆导航策略,在未见场景单/多事件设置中验证。
OnBodyAI - Why the Next AI Needs a Body
本文提出OnBodyAI概念,阐述大语言模型具身化后如何贴身服务用户,并概述科研与产业需求。
OntoAct: Hypothesis-Based Neuro-Symbolic Agents through Ontological Abstraction
OntoAct将经验抽象为本体公理,结合LLM假设生成与符号验证,在Tacit-FLE、Mars和ALFWorld验证。
Collective Learning for Unified Robotic Manipulation via Predictive Dynamics Adaptation
针对跨具身集体学习中动力学差异导致的策略崩溃,PACE框架通过预测性动力学适配器解耦任务意图与本体特性。仿真测试整体成功率超93%,动态分布外零样本达89%,显著优于Diffusion Policy基线,并在KUKA真机验证了Sim-to-Real迁移可行性。
PACER: Process-Aware VLA Policy Learning from Human Corrections for Robotic Disassembly
针对机器人拆卸任务中SFT数据稀缺与分布偏移难题,PACER框架通过过程感知纠错与证据重加权机制,在UR5e主板拆卸基准测试中将成功交接率从54%提升至87%,验证了利用人类纠错轨迹优化VLA策略的有效性。
Physical AI: A Survey of Models, Learning, Systems, and Open Challenges
该综述面向Physical AI可靠自主性,按物理交互闭环系统梳理模型、学习、系统、评估与安全。
PolyMorph: Learning Locomotion Policy for Cross-Embodiment Adaptation
提出形态条件化强化学习框架PolyMorph,通过图Transformer与URDF模块化解析,使单一运动策略适配异构腿足机器人。仿真验证覆盖双足至四足及未见构型,并在真实四足平台多配置下成功部署,无需针对特定机体重训。
Q($γ_H$): Entropy-Guided Horizon Mixing in Multi-Discount Q-Learning
针对固定折扣限制单一规划视野的问题,Q(γ_H)以熵置信号混合多折扣头,并在经典控制和深度强化学习基准上验证。
REKI: Registering Knowledge in VLAs
REKI用公开数据预训练VLA,结合VLM、flow-matching动作专家和低成本记忆,在多个基准及真机上验证。
Receding-Horizon Next-Best-View Planning for Highly Occluded Target Perception
针对机器人主动感知中严重遮挡难题,研究提出滚动时域次佳视点(RH-NBV)规划器。该方法评估候选视点序列而非孤立视点,在UR5e机械臂实测中将重度遮挡下ROI覆盖率提升至63.8%,显著优于传统单步NBV基线。
RingNav: Task-Shaped Circular Memory for Visual Heading
针对微型机器人算力受限痛点,提出仅10.6k参数的RingNav视觉航向估计器。通过将记忆约束在S1流形,在TartanAir数据集降低27%转向误差,并在Raspberry Pi Zero 2W与GAP8上分别实现27.3Hz和33.4Hz实时推理。
RoboCloth: A Large-Scale Real Cloth Material Dataset for Neural Reflectance Reconstruction
RoboCloth采集500种真实布料,用机器人控制相机与光照,并以两阶段神经重建在自有留出材料和UBO2014上验证。
RoboSpan: Learning Modular Coordination Policies for High-DoF Whole-Body Mobile Manipulation with Teleoperation
针对高自由度移动操作误差累积难题,提出HMF框架与COMET模型解耦29-DoF动作空间。集成全掌触觉表征与VLM任务分解,在物理机器人长时序任务中成功率较主流基线提升超20%,显著增强接触丰富场景下的鲁棒性。
RoPE-Flow: Monocular Vision-based Robot Pose Estimation via 2D Graph-Conditioned 3D Flow Matching
RoPE-Flow用2D热图特征、图条件生成与3D流匹配估计单目相机到机器人位姿,并在多机器人多相机及跨场景基准验证。
SATOR: Backpropagation-Free 3D Test-Time Adaptation via Sample-Adaptive Token Routing
SATOR为缓解3D点云分布偏移下的性能下降,采用样本自适应Token路由做无源无反传TTA,并在三个3D损坏基准验证。
Schrödinger's Navigator: Imagining an Ensemble of Futures for Zero-Shot Object Navigation
针对零样本物体导航在遮挡场景下的脆弱性,提出Schrödinger's Navigator框架。通过轨迹条件3D世界模型维持多重未来假设,结合FAVM价值图实现主动决策,在仿真与宇树Go2真机实验中显著提升隐蔽目标发现率与避障安全性。
SKATER: Synthesized Kinematics for Advanced Traversing Efficiency on a Humanoid Robot via Roller Skate Swizzles
研究提出足底四被动轮人形机器人及Swizzle步态强化学习框架,实机验证相比双足行走冲击强度降75.86%、运输成本降63.34%,显著提升能效与关节寿命。
SpaceCache: Intermediate Feature Reuse for Efficient Semantic Segmentation on Point Cloud Streams
SpaceCache针对点云流逐帧重复计算问题,以免训练特征缓存复用Transformer中间特征,并在室内外基准验证加速效果。
Spark-0: Scaling Spatially Aligned Tactile Pretraining for Robot Dexterous Manipulation
针对接触丰富灵巧操作中视觉难感知的问题,Spark-0以空间对齐VTLA结合触觉监督与条件控制,并在SparkArena和Ego Humanoid上验证。
SPEAR: Selective Preference Elicitation with Adaptive Rewards for VLM-Guided Robotic Manipulation
SPEAR通过可区分性查询选择和自适应奖励转换,提升VLM偏好标注效率,并在操控基准与真实硬件上验证。
System1-Arena: Which Decisions Can Be Left to System 1?
提出 System1-Arena 基准,用统一决策请求评测 System-1 与推理模型,在多类任务和闭环环境中验证。
T2-z: Test-Time Optimization of Environment Latents for Robotic World Models
T2-Z通过测试时优化可学习环境潜变量,使机器人世界模型适应未见环境,并在仿真设置和真实机器人任务上验证。
Efficient Test-Time Adaptation For Robot Policies
针对机器人部署环境漂移难题,提出TEMPO测试时自适应方法。通过熵正则化与基于分数的记忆机制,在无奖励条件下实现端侧自监督策略优化。MuJoCo仿真最高提升80%,Unitree Go2实物验证有效。
TRACE: Typed Reference-Aware Conversational Editing for Humanoid Motion Diffusion
TRACE用类型化可测运动学量连接语言请求与参考运动,在Unitree G1运动生成和多轮编辑评估中提升对齐与质量。
Tread: A Visuo-Inertial Framework for Terrain and Locomotion Context-Aware Gait-Phase and Speed Estimation in Wearable Robotics
提出Tread视惯融合框架,通过胸戴相机与下肢IMU构建因果管线。地形预判准确率达96.3%且提前1.46秒,步态相位RMSE低至1.75%,速度估计误差0.218km/h,有效解决穿戴机器人多模态感知割裂问题。
TS-WAM: Temporal Latent Actions and World-Action Coupling for Vision-Language Robot Control
TS-WAM面向视觉语言机器人控制,借助自监督时序学习与未来视觉预测,在仿真与真实操作中验证泛化和鲁棒性。
Uni-PNP: Unified Prehensile and Non-prehensile Policy Learning for Generalizable Object Pose Reaching
Uni-PNP通过接触动力学几何编码器与两阶段强化学习,统一学习抓取/非抓取操作,并在多物体多夹爪位姿到达中验证。
VeriVLA: Adaptive Test-Time Verification for Flow-Based VLAs with Latent World Models
VeriVLA针对基于流的VLA测试时样本质量难估问题,用双轴触发与JEPA潜在世界模型排序,在真实任务和仿真中验证提升。
VLA-$Δ$: Learning Physical State Transition for Vision-Language-Action Models
VLA-$Δ$以当前与未来状态的物理变化为显式学习目标,并在LIBERO、RoboTwin和真机实验中验证。
Do VLAs Really Follow Instructions? Diagnosing How-Level Instruction Following in Vision-Language-Action Models
本文诊断VLA的How级指令跟随,提出段级增强指令训练,并在标准基准与SIMPLER-IN上验证。
VP-EVT: Active Visibility Preservation for Embodied Visual Tracking
VP-EVT将目标可见性显式纳入运动控制,结合语言引导感知与历史估计,在OccEVT-Bench闭环遮挡评估中验证。
Trajectory Prediction Method for person under WSN with Hierarchical Envelope Adversarial Domain Adaptation
针对行人交互复杂与域偏移问题,提出含包络样本构造和局/全局对抗域适应的HEADA-LTCTPM,并在两个公共数据集验证。
X-Fly: Learning to Reach and Stop in Full-Chunk Aerial Vision-Language Navigation
X-Fly针对完整动作块空中VLN的恢复与停止问题,用分阶段训练在OpenFly测试集验证性能提升。
$λ_0$: Scaling Open-World Egocentric Human Data for Humanoid Loco-Manipulation
研究发布500小时HumanVerse数据集与λ0基础模型,通过视点对齐与离线运动优化管线,将人类全身演示零样本迁移至Unitree G1。该模型在真实世界长程移动操作任务中达62.5%成功率,验证了规模化人类数据对人形具身智能的有效性。
$S^3$-Nav: Structured Spatial-Semantic Decision Making for Language-Guided Robot Navigation
S^3-Nav面向部分可观测的语言引导导航,构建持久空间语义状态并控容呈现,在多环境物体与关系目标任务验证。
Refine Actions If Needed: Adaptive Action Chunk Refinement for Robot Manipulation
为兼顾操作成功率与推理延迟,RAIN预测不同细化级别动作误差以自适应细化提案,并在ManiSkill和真机任务验证。
Hyperspherical Contrastive Representations Unlock Planning and Exploration
提出自监督强化学习C-Slerp,用超球面对比表征规划中间路标,并在长时程导航和机器人操作中验证。
Runtime Monitoring of Supermartingale Certificates
针对超鞅证书依赖模型导致部署失效的问题,提出基于投注序贯检验的运行时监测,并在文献基准上验证。
Beyond Kinematic Tracking: Preserving Expressive Characteristics in Humanoid Whole-Body Control
该文针对人形全身控制中表现性特征易丢失的问题,提出带补偿目标与运动感知门控的残差学习,并在仿真和Unitree G1真机八类动作上验证。
Tactile-Guided Robot Learning: From Representation Learning to Foundation Models
本文从学习中心视角综述触觉引导技能学习,梳理触觉在学习与控制流程中的作用及相关文献资源。
Dungeon and Visibility World Generator
提出开源Dungeon and Visibility World Generator,用可配置二维/三维环境和视线查询支持探索、覆盖与多智能体部署算法评估。
A Practical Framework for Incremental Testing and Technology Maturation of Spacecraft Autonomy
论文面向AI航天器自主部署的信任鸿沟,提出离线地面测试与在线飞行监测结合的验证框架,并在强化学习姿态控制案例中展示。
Mixed-Reality Feedback Control: Towards Blending of Control and Digital Twinning
针对多现实反馈回路对控制建模支持不足,提出混合控制输入与反馈信号的框架,用于多现实同时运行对象。
Causal Analysis of Robot Foundation Models Enables Efficiency Gains
研究用激活修补分析三种VLA模型中图像与指令影响动作的因果路径,并在评估与真机部署中验证效率提升。
Robust Real-Time Monocular Human Pose Estimation with Insole-Based Sensor Fusion
针对单目实时姿态在遮挡或短时离框下失准,融合智能鞋垫足底压力与加速度,在多模态数据集和三类视觉骨干上验证。
Learning-Based Adaptive MPC for Magnetorquer-Only Satellite Attitude Control
针对磁力矩器卫星姿态控制受控权损失和磁场未知问题,提出含学习磁场模型的自适应MPC,并在地球与天王星轨道仿真验证。
Remember, Revisit, Revise: Scaffold Memory for Long-Horizon 3D Geometry
SMORE为冻结几何基础模型加入可修正外部记忆,并在五个数据集的多类3D几何任务上验证长序列推理改进。
Race to Recovery: Designing Advanced Safety Systems for Autonomous Driving via Learning Autonomous Racing
针对失控车辆恢复问题,先用强化学习训练漂移竞速策略再迁移恢复,在Gym-Khana、294个初始状态及1:10 F1TENTH实车上验证。
Neurosymbolic Learning of Interpretable World Models
提出CGWM,用时序逻辑知识学习可解释概念并以可微推理规划,在两个游戏环境验证更稳健。
When Do Discrete Actions Make Good Continuous Controllers?
通过比较连续与离散策略在单任务、多任务VLA、仿真和真机中的表现,发现离散动作预测可匹敌或优于连续策略。
Learning Navigation from Multimodal Demonstrations with Geometric Candidate Modes
针对离线导航示范多模态导致行为克隆取平均的问题,提出基于局部几何候选模式的分层策略,并在仿真和LimX Tron 1双足机器人上验证。
Towards Certifiable State Estimation under Observability Degeneracy
针对感知退化下可认证状态估计失效问题,提出候选驱动对偶认证框架,并在退化测量鲁棒配准中验证。
Towards Agentic Robots: Model, Data, Environment, and Harness
本文针对智能体式机器人研究割裂的问题,提出统一综述框架,梳理现有研究与未来方向。
One-shot Human Video-Guided Adaptation for Vision-Language-Action Models
针对VLA难以快速适应未见操作任务,CapPro用单个人类演示视频引导预训练策略,并在源任务和未见目标任务上验证。
Hierarchical Residual Policy Learning for Real-World Mobile Manipulation with Sparse Human Guidance
HiRe-MoMa通过分层残差微调冻结基策略,并以稀疏人类干预对齐价值,在TIAGo++真机移动操作实验中验证。
Anticipatory Commonsense with Moving Objects: An ASP-Based Framework for Predictive Reasoning with Interacting Trajectories
提出混合声明式框架,结合ASP、语义引导预测与能量优化,在Argoverse 2上验证交互运动轨迹的预测推理。
Cracking Mobile Manipulation: From Failure Diagnosis to Agentic Robot System
针对VLA在长程移动操作中组合成功率低的问题,论文通过失败诊断设计智能体干预,并在RoboCasa365、BEHAVIOR-1K和真机任务上验证。
Human Demonstrations as Post-Training Data for Any Robot Body: Retargeting the Object, Not the Hand
该工作将手机采集的人类演示转为物体运动记录,通过按URDF求解机器人并在仿真中验证其后训练适用性。
Reflect After Failure: Brain-Inspired Self-Evolving Agents for Embodied Spatial Intelligence
针对具身空间任务中失败原因难判定的问题,HiMeco通过PEP反思与技能抽象自进化,并在ESI-Bench和EmbSpatial-Bench验证。
Modeling and Understanding Neural Weights of Humanoid Policies with Diffusion
该研究用线性自编码器与 Diffusion Transformer 建模人形控制网络权重,并在 Unitree G1 真机多种动作上验证生成网络。
Reinforcement Learning via Advantage Guidance
本文提出 Advantage Guidance,以监督学习式优势条件训练和对比扩散引导优化策略,并在26个长时程稀疏奖励任务上验证。
Occupancy Modeling via Drifting: One-Step Generation Enables Direct Policy Extraction
该文面向从无标签数据强化学习,采用 Drifting 一步生成采样器建模占用,并在标准基准上验证可直接提取策略。
Active Perception of Upper-Limb Functional Mobility through Human-Robot Handovers
针对协作机器人适应上肢损伤者能力的问题,提出基于重复交接请求的在线主动感知,并在仿真和物理平台验证。
Design and Characterization of a Unified Continuum Robot Actuation Platform
本文提出解耦硬软件与连续体设计的统一驱动平台,并在开源手术机器人系统及两类手术用例中实验验证。
Dynamic morphing of non-Euclidean active shells enabled by flutter under a steady stimulus
提出利用颤振使薄主动壳在稳态刺激下动态变形,并在板和圆柱壳分析仿真及水凝胶板实验中验证。
Digital Twin-Conditioned RSS-Fingerprint Localization in Cell-Free Millimeter-Wave Networks
针对数字孪生指纹在无蜂窝毫米波定位中的sim-to-real差距,DTCond融合真实与DT指纹,并在真实28GHz无蜂窝测试床及闭环用例上验证。
Line-Augmented cuVSLAM: Robust Visual Odometry in Low-Texture Environments
面向低纹理环境中点特征视觉里程计失效问题,在线特征增强 cuVSLAM 中融入直线约束,并在 RGB-D 序列上验证精度提升。
A particle swarm optimization with a reduced-subspace trust-region safeguard for contact-rich controller tuning
提出结合PSO探索与TR局部细化的PSO+TR,用于无导数优化可解释插入控制器,并在BCP基准和合成平面插入任务验证。
Outperforming 1000 Euclidean Layers With Hyperbolic Goal-Conditioned RL
针对复杂导航中欧氏距离与路线距离不匹配,方法用双曲测地距离改造CRL,并在困难导航任务上验证。
Value-Guided Repulsion for Offline Reinforcement Learning
针对漂移策略仅按几何关系排斥动作的问题,VRQL将Q值融入粒子交互场,并在OGBench与D4RL AntMaze配置上验证。
Uncertainty-Driven Self-Play for Robust Multi-Agent Driving Policies
提出以认知不确定性引导的自博弈,让探索智能体挖掘难例,并在nuplan Val14、Argoverse 2和Waymo验证。
Probabilistic Physics Digital Twin for Human-Robot Interaction
针对物理属性难精确获取的问题,提出概率物理数字孪生,并在人机交互场景中验证其指导行动与规划。
A Master-to-Simulation Interface with Demonstration-Trajectory Guidance for Vascular Intervention
该研究面向机器人血管介入引导不足问题,构建主端到SOFA接口,并在物理模型实验中验证成功轨迹引导效果。
Co-Evolving Acting and Forecasting for Language Agents
针对长程rollout成本高且中间监督利用不足,CoPE用多步动作目标训练策略骨干,并在五个基准验证。
Back on Track: Deployment-time Policy Improvement via World Model Planning
该框架用离线训练的监测与干预及世界模型规划,在LIBERO-Goal和Franka Panda上提升黑盒视觉运动策略部署表现。
ACRO: Actor-Critic Rollout Orchestration
ACRO解决固定VLA执行中何时继续或干预的问题,用Critic与轨迹回退编排恢复,并在仿真和真机操作验证。
AdaRSI: On-Demand Recursive Self-Improvement for Embodied Agents
针对预训练VLA在未见长程任务中途失败,AdaRSI按需归因并微调不可靠子步骤,在RoboCasa365上验证提升成功率。
Atomic-WAM: Execution-Grounded Atomic-Motion Reasoning for World Action Models
Atomic-WAM用原子运动描述连接任务推理与动作生成,并在RoboLab real-to-sim评估中验证默认和模糊指令任务。
AutoRSR: Automated Real-to-Sim-to-Real Data Generation for Scalable Robot Learning
AutoRSR将扫描的真实工作空间自动转为仿真资产并生成操作数据,在三项真机操作任务上验证。
Coordi-pi: Coordination-Aware Dual-Hand Action Representation for Bimanual Dexterous Manipulation
针对双手灵巧操作的高维结构化动作空间,提出 Coordi-π 动作表示,并在 DexJoCo 与真实双手任务上验证。
CoWear: Towards Collaborative Wearable Inertial Localization with Multiple Smart Devices
CoWear面向异构可穿戴惯性定位,提供同步数据集与不确定性融合框架,并在手机、手表、眼镜参考目标上验证。
Generative World Simulation with DAO and JING
提出融合DAO世界引擎与JING体验模型的生成式世界仿真框架,实现共享状态持久化与第一人称视听生成闭环,支持智能体在保留历史后果的环境中持续交互与演化。
DD-GBP: Anytime Multi-Arm Planning and Continuous Execution via Distributed Dynamic Gaussian Belief Propagation
针对动态环境中长时程多臂在线安全执行,DD-GBP以分布式动态高斯信念传播规划关节轨迹,并在多臂场景和双臂运输实验中验证。
EgoJEPA: Beyond Retargeting for Dexterous Manipulation from Egocentric Videos
EgoJEPA为人类视频到机器人控制迁移去除规则重定向,以三阶段表征与世界建模在真实操作任务上验证。
FoveaVLA: Foveation Actions Replace the Wrist Camera in VLAs
FoveaVLA针对腕部相机视野受限与外部相机细节丢失,预测交互区域并裁剪原图,在四个真实任务套件上验证。
GS-PRM: Gaussian Visual Roadmap for Image-Goal Navigation
针对图像目标导航的全局规划需求,GS-PRM用3DGS渲染构建视觉路线图,并在仿真和真实环境中验证。
HM3D-M3: A Benchmark for Multi-Agent, Multi-Modal, Multi-Object Goal Navigation
HM3D-M3针对多智能体多模态多对象导航,构建基准并以两种基线在室内场景和三机器人团队上验证。
HyperLoop: Hyperspectral-Assisted Loop Closure Detection in 3D-SLAM for Planetary Exploration
HyperLoop将高光谱成像引入3DGS-SLAM闭环检测,并在MMOTS行星类比遍历数据上验证效果。
KinoGen: Customizable Humanoid Loco-Manipulation References via Kinematically Grounded Video Generation
KinoGen通过运动学约束视频生成合成人形机器人移动操作参考,并在八项任务和Unitree G1上验证。
MoCaP: Mobile Code-as-Policies for Zero-Shot Mobile Manipulation from Passive Human Videos
针对从被动人类视频迁移经验到机器人移动操作的问题,MoCaP生成策略指导,并在真实室内任务验证。
MorphAct: Robot Policies Morphing with the Worlds They Act In
MorphAct通过上下文低秩参数生成动态调整机器人策略,并在LIBERO、Meta-World和真实评估中验证性能提升。
MUCO: A Mani-Unit-Structured Manipulation Framework for Compositional Long-Horizon Robot Tasks
MUCO以可复用操作单元编排长时程操作,基于语言视觉选择策略,并在RLBench、RoboTwin 2.0和真实任务验证。
NavAble: A Large-Scale Dataset and Synthetic Data Generation Pipeline for Blind Navigation
NavAble面向BLV导航中无障碍关键物体识别数据稀缺问题,结合真实数据与合成流水线,并在分割模型和助行机器人自视角数据上验证。
ObjDream: Guiding Vision-Language-Action Models with Object-Level Understanding and Future State Prediction
ObjDream通过对象级表征与动作条件未来状态预测指导VLA,并在多个基准和真实机器人中验证泛化。
PAWA: Panoramic Action-conditioned World Modeling for Multiple Agents
PAWA面向多人共享环境预测,构建动作对齐的POV/全景视频数据与双塔模型,并在Minecraft数据集上验证。
PhySGA: A Physics-Space Grounded Agentic Framework for Generalizable and Interactive 3D Composition
PhySGA针对复杂3D物体组合难题,结合智能体探索与物理仿真,并在Isaac Sim中验证效果。
SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving
提出SafeDriveVLA,用导航条件化世界模型dreaming与合规模式预测,在Bench2Drive验证冲突感知端到端驾驶。
SERO: Learning from Executable Oracle Continuations for Long-Horizon Agentic Reinforcement Learning
SERO从当前策略到达状态恢复环境,让训练用预言机继续交互并按策略可达性加权学习,在ALFWorld和WebShop上验证。
SHRED: Self-Play for Heterogeneous Road-Users without Expert Demonstrations
SHRED通过异构自博弈从随机初始化训练车辆、行人和骑行者,并在WOSAC、Waymo零样本和InterPlan上验证。
Soloist: A Generative Model for Blind Voice Separation in the Wild
Soloist面向野外盲语音分离,用条件生成音频码序列的方法,在合成混合与真实录音上验证。
SOMA: Stack-of-Objects Manipulation using a Quadruped Robot
SOMA用分层强化学习实现四足机器人三维非抓取堆叠物操控,并在仿真基准和Unitree Go1真机上验证。
SonoWorld: Towards Interactive Pose-Controllable Ultrasound World Models
针对机器人超声缺少真实可控仿真环境,SonoWorld用临床视频学习6-DoF可控世界模型,并在留出跟踪扫描和用户研究中验证。
SPECTRA-VLA: Base-Fine Hyperspectral Token Transfer at Frozen Vision-Language-Action Interfaces
针对VLA冻结解码器难用高光谱状态的问题,SPECTRA-VLA以残差丰富目标令牌,并在86个留出采集上验证。
StateCraft: Augmenting Video World Models with Abstract-State Reasoning
StateCraft将可更新抽象状态与视觉状态解耦,结合语言模型和视频扩散模型,在生成式界面基准和3D概念实验中验证长程一致生成。
TGrasp6D: Task-Informed Vision-Language Priors and Pose Refinement enable Zero-Shot Task-Oriented 6DoF Grasping
TGrasp6D用视觉-语言先验与6DoF位姿优化解决零样本任务导向抓取,并在TaskGrasp和真实物体上验证。
VIGOR-MPC: Vision-Guided Objective Regulation MPC
VIGOR-MPC通过学生-教师蒸馏将视野感知长时域MPC转为视觉在线调参短时域MPC,并在仿真和硬件视觉自主赛车中验证。
What Matters for World Modeling in Vision-Language-Action Models?
研究VLA中世界模型集成的关键因素,统一比较四类范式、多种表征和骨干,并在多种设置含真实世界中验证。
VLRLA: Deployment-Time Adaptation of Vision-Language-Action Models through In-Context Reinforcement Learning
提出VLRLA框架,为VLA模型加入上下文强化学习,在仿真和真实部署中验证部署时适应能力。
VLX-Go: Robust Embodied Tracking through Multi-Stage Learning and On-Policy Refinement
VLX-Go通过视觉语言对齐与在策略优化,将干扰环境人形跟踪成功率提升至58.22%,碰撞率降低1.99个百分点,代码已开源。
From Failures to Learnable Worlds: Policy-Conditioned Environment Generation for Navigation Agents
提出WEDGE框架,利用LLM分析预训练导航策略失败轨迹并自动验证弱点特征,据此定向生成高难度训练环境。在ProcTHOR与HM3D基准上,该弱点导向适配法显著优于随机及硬样本挖掘策略,证实失败模式可作为环境构建的有效指导信号。
Beyond Safe Execution: Safe Online Reinforcement Learning for Autonomous Driving with Value Calibration and Adaptive Guidance
提出SOAR-Flow,通过CBF-MPC安全过滤、价值校准与自适应引导,对离线初始化驾驶策略进行安全在线微调,并在仿真和UGV上验证。
Beyond Planning: Differentiable Control-in-the-loop End-to-End Autonomous Driving
DIVA将可微识别车辆动力学嵌入端到端驾驶训练,打通感知到车辆状态链路,并在闭环Bench2Drive上验证。
Perception Beyond the Visible: Incompleteness-Aware Scene Understanding for Robot Autonomy
提出面向机器人自主的不完备性感知场景理解愿景,围绕三类不完备性组织方法并展望信念中心4D表示。
Steertuning Policies from a Few Human Videos
提出 Steertuning,通过人类数据预训练扩散策略并少量演示微调,在12项任务和12个新环境中验证机器人新任务学习。
Reading Right, Acting Wrong: Diagnosing Decision Failures of System One Models in Agent Loops
本文用独立事实探针诊断 System One 模型代理决策错误,并在多类代理决策状态基准上验证。
Empowering Edge Agents: A Systematic Analysis of Edge-Cloud Collaboration in LLM Agent Execution
论文提出EC2-Bench,评估长程LLM智能体执行中的边缘-云协作,并在可执行数字工作空间任务上实证分析。
Force Sensor-Based Picking Pattern Analysis and Two-Jaw Gripper Design for Cherry Tomato Robotic Harvesting in Greenhouse
面向温室樱桃番茄采摘,论文用六轴力/扭矩数据驱动设计仿生柔顺夹爪,并在仿真和商业温室真机试验中验证。
Smartphone-Based, Field-Deployed AI Inspection System for Power Distribution Infrastructure
提出基于智能手机的AI配电巡检流程,结合图像验证、深度学习、单目深度和规则处理,在APEPDCL五条馈线现场试点验证。
Towards a Data-Centric Understanding of Spatial Reasoning in Multimodal Large Language Models
综述预训练 MLLM 空间推理微调方法,重点分析数据集构建、标注模态与模型评估。
Locomotion with Online Awareness of Dynamics for Precision Footholds
针对未知载荷下窄梁精确接触困难,LOAD结合显式惯性估计与隐式动力学特征,并在仿真和硬件窄梁通行中验证。
Physics-Aware Object-Centric SE(3) Forecasting for Real-Time Proactive Dynamic Grasping
面向主动动态抓取,提出以物体为中心的 SE(3) 预测与可达选择框架,并在仿真和真实动态抓取中验证。
A Collision-Aware Predictive Rerouting Framework for Connected and Automated Vehicles
针对城市非 recurrent 拥堵缓解,提出碰撞感知预测重路由框架,并在SUMO城市场景仿真中验证。
The Human--VLA Communication Gap: What Humans Leave Implicit and What Policies Cannot Recover
研究人类自然指令与VLA策略间的通信鸿沟,通过信息与执行缺口划分,在受控物理任务变体上验证。
What Makes a Good Visual Representation for Spatial Understanding in MLLMs?
研究MLLM空间理解的良好视觉表征,比较蒸馏与融合迁移,并在静态3D和动态4D空间推理基准验证。
Imagining Goals with Geometric Horizon Models for Policy Generalization
该工作面向零样本目标泛化,提出 TD-Aug 从 geometric horizon model 采样想象新目标,并在 stitching-based OGBench 任务验证。
Collaborative Planning for UAV-UGV Teams under Operational Constraints via Masked Error-bounded Neuro-Symbolic Diffusion
针对受能量与道路可达性约束的UAV-UGV协同规划,MEND以神经符号掩码扩散生成动作序列,并在仿真、真实地图和实体团队验证。
Learning Robot Policies for Whole-Body Mobility Assistance via Dynamic Human Motion Generation
提出基于动态人体运动生成的仿真框架,学习全身移动辅助策略,并在仿真STS、L&T及初步真实STS迁移中验证。
Boundary Control of a Modified Timoshenko-Ehrenfest Beam via Reduced-Order Reinforcement Learning
研究弹性梁主动振动控制,将偏微分方程约化为 ROM,并用 PPO 在边界控制问题上与 LQR 数值比较。
Agentic Robot Creation through Generation, Verification, and Revision
研究将高层意图转为机器人及行为,提出设计评估指标与Roboforge,并在生成形体、多机器人行为和实体Gorilla上验证。
Model-Based Online Decision Making via Generative Trajectory Planning
GTP用扩散先验生成并结合学习的动力学、奖励和值模型细化动作序列,在连续控制和长时程操作任务上验证在线决策。
Intent-guided Adaptive Stiffening for Visuomotor Policies under Unknown Resistance
针对未知阻力下视觉运动策略执行权限不足问题,提出残差增刚层,并在两个真实接触操作任务上验证。
Walk Like This: Stylized Locomotion for Physics-Based Characters through Example-Driven Diffusion
针对速度与风格独立可控的表现性腿式运动,提出示例驱动扩散框架,并在仿真人形角色和实体机器人上验证。
Where Small Mistakes Matter: Quantifying State Criticality for Imitation Learning
针对模仿学习中状态重要性不均,SCRIM估计动作微扰的最坏价值退化,并在仿真与真实操作任务验证。
Known-Voice Cloning and the Limits of Personality Transfer for Character Design
研究考察熟悉人物克隆声音能否将人格印象迁移到虚拟角色,并在大学现场和线上两项研究中验证。
Benchmarking Interaction-Oriented Aerial Mobility across Heterogeneous Environments
CrossFly用统一仿真与评估框架评测异构环境长程空中移动,并在多类轨迹和VLA智能体上验证。
Data-Free Continual Learning for World Action Model with Rectified Generative Replay
针对 WAM 顺序微调遗忘且旧数据不可用,提出 R^2-WAM 自生成并校正回放,在 LIBERO 与真实任务上验证。
Neuro-Symbolic Graph Transformers for Hierarchical Intention Recognition from Multimodal Human Activity Sequences
提出NSGT,将HR-G偏置与FOL损失用于多模态层级意图识别,并在合成NTU-Hierarchy上验证。
Cross-Embodiment Affordance Transfer for Robotic Manipulation
为解决人类可供性标注与机器人约束不匹配,框架结合点云和机器人描述符预测可执行区域,并在家用物体数据集验证。
Multimodal Fusion of RGB and Complementary Modalities for Semantic Segmentation
针对RGB-X语义分割中的跨传感器特征失配与融合不稳,提出BPCF模块,并在六类模态配对和八个公开数据集上验证。
What Matters in Quality-Aware VLA Pretraining: A Benchmark and Empirical Study
研究VLA预训练中如何利用示范质量,比较加权、过滤与条件化,并在AXIS-Bench和真实实验中验证。
Limits of Statistical Assurance for Embodied and Agentic AI under Adaptive Adversaries
本文刻画具身与工具使用AI在自适应对手下有限安全评估的局限,并在模拟RoCo、AgentDojo和语言模型控制器实验中验证。
ABot-ER: Unified Embodied Reasoning through Agentic Data-Model Co-Evolution
ABot-ER用数据-模型自进化与任务条件自适应训练,在十二个基准上验证统一具身推理。
ACCRUE: Continual Off-Policy Reinforcement Learning for Robot Foundation Models
ACCRUE面向RFM持续学习新任务与保持旧行为,携带轻量演员-评论家并在仿真和真机装配中验证。
Action Jets: Learning the Local Shape of the Action-conditioned Data Manifold
提出Action Jet,以泰勒多项式近似固定状态下动作可达帧的局部流形,在BridgeData V2和DL3DV场景上验证短时域加速与预测。
AffectWorld: Benchmarking Emotion-Driven Future World Prediction
AffectWorld通过情绪-动作-世界状态三任务,评测日常视频中情绪驱动的未来世界预测。
APTree: Extended Behavior Trees for Adaptive and Scalable Automated Robotic Task Planning in Construction
APTree用行为树整合自动规划与模块化执行,并在真实亭构建案例中验证建筑机器人任务规划。
Box-WAM: Box Trajectories as Compact State Representations for World Action Models
BoxWAM用任务相关物体的有向边界框轨迹替代未来视频帧,在机器人操作任务上降低计算成本并提升动作预测。
CALM: Decentralized Control of Cooperative Aerial Manipulation with Multi-Agent Reinforcement Learning
CALM以去中心化MARL结合估计与观测器,控制多UAV提篮跟踪移动地面机器人,并在留出轨迹上验证。
ChunkAct: Action Chunking for Agentic Robotics
ChunkAct通过将记忆编译为动作块,减少智能体机器人控制中的LLM调用,并在LIBERO-Pro上验证性能与效率提升。
Code2Worlds-2: Physically Plausible Agent Harness for Embodied World Simulation
Code2Worlds-2通过场景编译器与仿真闭环细化,将4D世界生成转为具身仿真,并在SimCode4D及多类场景验证。
CoSMO: Conformal Semantic Mapping for Open-World Safe Robot Navigation
CoSMO将VLM嵌入校准为覆盖集和安全膨胀,在MP3D与四足机器人上验证开放世界安全导航。
DexStitch: Learning and Composing Dexterous Skills from Human Videos via Contact-Aware Robotic Inpainting
DexStitch将人类长程视频切分并转成机器人数据,学习可拼接灵巧技能,在留出会话和四个家庭技能上验证。
DR-VLA: Learning Human-Like Quadruped Navigation from Egocentric Web Videos via Domain-Invariant Scene Representations
DR-VLA用域不变场景表示从第一视角网络视频迁移人类导航经验,并在EgoLynx-Robot和NAVSIM v1上验证。
DriveWLA: Unifying Future Dynamics and Scene Semantics through World-Language-Action Modeling for Autonomous Driving
DriveWLA用MoT统一语义理解、未来动态与轨迹生成,并在开环、闭环及多基准零样本评估中验证。
EgoCPT: Learning Dexterous Manipulation from a Single Ego-Centric Video with Contact-Aware Optimization
为从人类第一视角视频学习灵巧操作,EgoCPT用接触感知优化重定向手轨迹,并在五个任务上验证。
EgoMatrix: Physically Faithful Dexterous Robot Demonstrations from Egocentric Human Videos
EgoMatrix将单目第一视角人类视频转为双手灵巧轨迹和机器人观测视频,并在TACO、OakInk2和自采数据上验证。
EqC: Equilibrium Energy Control for Introspective Lifelong Robot Learning
EqC用显式条件能量景观进行动作精炼与能力判断,并在仿真和真实双臂操作中验证终身学习。
ForeTac: Predictive Contact Guidance for Generative Robot Policies
ForeTac通过预测并评估候选动作的触觉后果来引导生成式策略,并在四个真机接触操作任务上验证。
ForkCast: Predictive Recovery for Vision-Language-Action Policies via Counterfactual Futures
ForkCast通过比较反事实未来,为冻结VLA策略预测何时及如何恢复,并在仿真RoboTwin 2.0和真实机器人上验证。
GLST: Global-Local Spatio-Temporal Memory Decomposition Framework for Online Chained-Goal Navigation
针对部分可观测且目标在线变化的长程导航,GLST分解全局-局部时空记忆,并在仿真和Spot真机上验证。
GreenWAM: A World Foundation Model for Robotics
GreenWAM用共享解剖动作空间与联合训练,构建可跨不同本体兼作世界模型和策略的机器人模型,并在多项基准和真实人形机器人上验证。
I3L: Iterative Interactive Imitation Learning for Whole-Body Mobile Manipulation
I3L通过全身纠正与迭代策略优化,解决离线示教策略在长程全身移动操作中的可靠部署问题,并在三种机器人、八个仿真与真实任务上验证。
LAG-IO: Multi-IMU State Estimation for Legged Robots Using Factor Graphs
针对腿式机器人本体状态估计漂移,LAG-IO用因子图紧耦合多IMU与关节编码器,并在四足机器人非结构地形实验验证。
MedEvo: Medical Reasoning Evolution through Knowledge Navigation
MedEvo用医学标签体系与错误诊断修复失败轨迹并选择数据,在七个基准及MedXpertQA-MM上验证提升准确率。
MMTA: Benchmarking Multimodal Temporal Analysis with Time Series, Text, and Vision
为评估MLLM整合时间序列与真实视觉证据,MMTA以共享模式和加权指标构建三模态任务,并在九领域测试集验证。
OccWAM: Occupancy World-Action Models with Joint Scene-to-Ego Flow Matching
OccWAM用场景条件流匹配联合生成未来占用与自车轨迹,并在Bench2Drive和nuScenes验证自动驾驶规划与预测。
OneDemo: Unified Policy Learning and Data Generation from a Single Demonstration
OneDemo将单个成功演示编辑建模为强化学习,用于策略学习和数据生成,并在Meta-World与DexMimicGen任务上验证。
PACT: Posture-Aligned Co-Design Technique for Hand Configuration and Retargeting in Multi-Finger Imitation Learning
为提升遥操作示教姿态保真度,PACT联合优化机器手设计与重定向,并在遥操作和模仿学习中验证。
PrT-Flow: Probability-Tractable Flow Matching for Reinforcement Learning
PrT-Flow用可逆JTT与CET实现可求动作概率的多步生成,并在Robomimic Lift和OGBench Cube-Triple上验证。
ReEnvision: Future-Guided Selective Action Repair for Long-Horizon Manipulation
ReEnvision面向长时程操作偏差,借助未来动作信念选择性修复,在CALVIN、L-CALVIN、RLBench及真机任务验证。
RESTA: Time-Scaling Augmentation for Data-Efficient Robot Imitation Learning
RESTA通过轨迹反转与时间重采样增强,提升机器人模仿学习数据效率,并在16个成对双臂操作任务上验证。
RoboFQE: Rollout-Free Evaluation of Visual Robot Policies from Offline Trajectories
RoboFQE用离线机器人轨迹进行无Rollout离策略评估,在仿真与真实操纵任务中验证策略回报估计。
RoboSimStudio: An Interactive Toolkit for Human and Agent Rapid Real2Sim of Robot Manipulation Tasks
RoboSimStudio通过可编辑求解器、接触模型和物理参数,帮助人类与编码智能体快速构建并迭代机器人操作仿真。
RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
RoTA-Bench用交互式3D到2D投影对齐评估视觉语言模型的3D空间推理,并在构建任务集上验证。
SchemaPose: RGB-Based Category-Level Pose Estimation with Parametric Category Schema
SchemaPose面向RGB类别级9D姿态估计,采用显式参数化类别图式与查询式端到端框架,在合成和真实数据上验证。
Sim4RAD: A MATLAB Toolkit for Design-Phase Sizing, Actuator Selection and URDF-Model Verification of Serial Robotic Arms
Sim4RAD用参数化刚体建模与多类分析,支持串联机械臂早期执行器选型,并在7-DOF仿人臂三种布局上验证。
TacitVLA: Reasoning Vision-Language-Action Models Without Reasoning Latency
TacitVLA让动作专家不关注当前生成推理,在操控与自动驾驶等四个基准上验证低延迟推理VLA。
TRACE: Efficient Transfer Learning for Neural Whole-Body Control Across Humanoid Embodiments
TRACE通过运动学先验、蒸馏与低秩强化学习,将SONIC从Unitree G1迁移到H2并在评估动作和真机演示中验证。
WorldOracle: Benchmarking Action-Conditioned World Models against Real-World Executions
WorldOracle以相同初始观测和低层动作序列为条件,从四个维度在真实执行套件上评测ACWM预测。
WoVR+: World Model as Reliable Simulator for Versatile VLA Policy Optimization with RL
WoVR+通过幻觉感知世界模型与分阶段想象训练,减少 VLA-RL 真机交互,并在 RoboTwin 和6项真机任务上验证提升。
YUBI-Real2Sim: 3DGS Scene Verification for Reliable Policy Evaluation
针对真机评估 VLA 成本高且难复现的问题,YUBI-Real2Sim 用 3DGS 重建与 MuJoCo 仿真,在双鱼眼腕视角下验证策略评估。
Interactive Navigation Beyond Reachability: Benchmark and Agentic Framework
针对需改变连通性与目标可见性的交互导航,提出MultINav-Bench和基于状态交互图的MultINav-Agent,并在该基准验证。
Estimating the Causal Impact of Social Navigation Signals in Corridor Scenarios
研究走廊人机交互中社交导航信号是否提升通行成功,用因果DAG对比干预与观测估计并验证。
Observe, Share, or Predict? Disentangling Partner Information in Embodied Multi-Agent Collaboration
研究无对话具身协作中伙伴状态、知识交换和动作预测的作用,并在Habitat的PARTNR基准上验证。
Force-Modulated Dexterity: Unified Compliance for Contact-Rich Manipulation
针对遥操作难以复现细微接触力的问题,FOMO-Dex以统一柔顺形式进行力驱动修正,并在多种富接触操作中验证。
Phase-Conditioned Affordance Fields for SE(3)-Equivariant Visuomotor Policies
针对全局 SE(3) 等变假设难适应任务相关区域变化,方法学习 PAF 点云评分,并在 MimicGen 与多物体真机任务上验证。
XAI-Guided Fourier Domain Generalisation for Pure-Simulation Sim-to-Real Deep Reinforcement Learning
针对仿真训练视觉自动驾驶策略真实部署退化,XFD以XAI归因引导傅里叶域泛化,并在仿真与零样本真实部署中验证。
Human-Like Redundancy Resolution for Real-Time Bimanual Humanoid Teleoperation
针对双臂人形遥操作中腕部跟踪与肘部姿态稳定的矛盾,提出自适应肘部引导和抗奇异腕部跟踪,并在消融、压力测试与真机任务中验证。
Can a Frontier VLM Serve as a Robot Policy for Memory-Dependent Manipulation?
使用冻结的 GPT-6-Astra 直接作为策略,在 RoboMME 16项依赖记忆操作任务800集上验证,成功率92.1%。
A Survey of Flow Matching in Reinforcement Learning
本文针对强化学习中 Flow Matching 文献碎片化问题,按建模目标和 RL 信号整合机制梳理相关方法。
What Limits Cross-Task Generalization in World Action Models?
该文用AoE解耦并诊断WAM跨任务泛化,在两种世界模型和三项操作基准上以VITA提升生成未来的执行成功率。
Digital-Twin-driven textile classification and foreign object recognition in automated sorting systems
提出数字孪生驱动的双臂机器人分拣系统,融合抓取预测、多模态感知与VLM,在真实纺织品分类和异物识别场景验证。
Proactive Physical AI through Continuous Observation and Timely Intervention
提出ProAgent,通过持续观察、主动时机模型与响应模型,在实验和真机评估中实现及时物理干预。
LiDAR-based Humanoid Navigation in Dynamic, Non-Convex Environments via Spatio-Temporal Safe Corridors
该框架由 LiDAR 粒子表示构建时空安全走廊,并结合 LIP 规划与 WBC,在 Digit 仿真中验证动态非凸环境导航。
Constrained Differentiable Policy Learning for Safe Quadrotor Navigation
针对四旋翼安全导航中惩罚权重需调参的问题,提出显式约束的可微策略学习,并在仿真、Gazebo/PX4和实体四旋翼验证。
ClearNav: Perception-Aligned Quadrotor Flight Using Differential-Physics
ClearNav通过约束朝向、横向速度和近障速度训练导航策略,并在仿真与真实杂乱环境验证更安全的四旋翼飞行。
D-World: An Explicit World-Language-Action Model with Recursive Self-Improvement under Dual Control
为解决机器人世界模型难以直接检查纠正,D-World用可执行数字孪生显式建模,并在双臂机器人任务上验证。
DEFlow: Deep Equilibrium Flow Maximum-Entropy Reinforcement Learning
DEFlow用隐式欧拉和平衡系统构建流策略,并在Multi-Goal docking、操作和MuJoCo任务上验证。
DexNinja: Learning Robust Dexterous Cutting Policy with a Real-to-Sim-to-Real Data Engine
DexNinja针对灵巧切割数据昂贵与仿真鸿沟,用real2sim2real生成训练分布,并在食物切片任务上验证。
Decision-Making in Digital Twins: Optimization, Control, and Learning
本文综述Digital Twins驱动的决策方法,聚焦仿真优化、序贯决策与风险感知决策。
DR-APO: Decoupled-Representation Advantage-Guided Policy Optimization from Continuous Control to Embodied Navigation
DR-APO为高斯、扩散和流策略提供解耦表征的优势引导优化,并在MuJoCo与具身导航中验证。
EgoWholeView: Camera-Only Head-Mounted Capture of Body and Bimanual Hand Motion for Embodied Demonstrations
EgoWholeView用六个同步广角RGB头戴相机与专用融合流程,捕捉身体和双手运动,并在六相机记录上验证。
Embodied Skill Bench: Benchmarking How Well Agents with Embodied Skills Perform on Physical Tasks
该工作将多类模块封装为具身技能,提出EmbodiedSkillBench,并在四个智能体的100个扰动LIBERO-Pro任务上验证复用效果。
FEM-Validated Real-Time Modelling of Soft Tactile Deformation
针对软触觉传感器难以兼顾精度与实时性,结合少量实测验证、FEM与GNN,在平面软触觉结构上验证二维变形预测。
G$^2$WAM: World Action Models for Efficient and Geometry Grounded Image-Goal Navigation
针对图像目标导航中的视野外目标与空间记忆需求,G$^2$WAM用场景坐标定位和潜空间动作世界模型,在轨迹预测基准与闭环导航中验证。
Language2Drive: Do Vision-Language-Action Models Really Follow the Instructions in Autonomous Driving?
提出Language2Drive及PCU,在CARLA仿真、重建真实场景和开环基准中检验自动驾驶VLA的指令跟随能力。
MIRROR: Reflecting Hidden Symmetries from Offline Robot Interaction Data
MIRROR从离线交互数据学习观测-动作联合对称变换,并在Robosuite任务与真机零样部署中验证。
MOSAIC: Mode- and Support-Aware Inference-Time Control of Robot Diffusion Models
MOSAIC以无梯度推理时控制调节冻结机器人扩散模型,并在导航、灵巧抓取、运动规划和协作搬箱中验证。
MSC: Multi-Stage Caster-aware Control Framework with Uncertainty-Aware NMPC and RL-based Execution Layer
针对脚轮错位导致的规划执行偏差,MSC结合不确定性感知NMPC与RL执行层,并在Isaac Sim和真实机器人上验证。
PathLift: Depth-Conditioned Metric Lifting for Visual-Navigation Priors
针对视觉导航策略只给方向不定距离,PathLift用传感器级深度逐点生成度量路径,并在仿真和真实轮式机器人上验证。
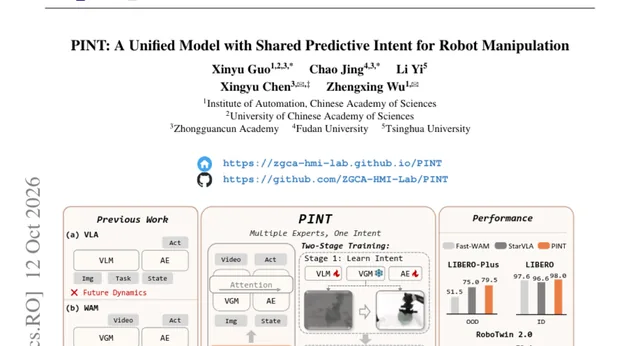
PINT: A Unified Model with Shared Predictive Intent for Robot Manipulation
PINT通过共享块级Predictive Intent协调语义推理、世界建模与动作生成,并在RoboTwin 2.0-Hard、LIBERO-Plus和真实双臂任务上验证。
ReForesight: Occlusion-Robust Re-Identification and Future Occupancy Forecasting for Dynamic Semantic Mapping
ReForesight为粒子式语义建图加入实例级未来占用与遮挡后重识别,并在CODa序列和户外清洁机器人上验证。
ViewStruct: View-Grounded Articulation and Connectivity Inference
ViewStruct基于视图锚定表示和适配的预训练视觉语言模型,从RGB、分割与深度联合推断连接和关节,并在真实视频与仿真操纵中验证。
X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
X-Ragent通过工具增强强化学习选择性获取辅助证据和有效测量,并在三个CXR基准上验证胸部X光证据支撑推理。
“Always Want to Use It for Everything”: Understanding Young Adults’ Perceptions of AI Dependence
为理解年轻人对通用 AI 聊天机器人依赖的看法,研究通过在线问卷收集18至25岁用户证言并分析其因素与影响。
1Step-WAM: Your World Action Model but Faster using 1-Step Action Generation
针对WAM迭代去噪与串行执行瓶颈,1Step-WAM用校准和受限解码实现一步生成,并在RoboTwin、LIBERO和真机上验证。
A Reinforcement Learning Framework for Safety-Aware Haptic Shared Control in Surgical Robotics
针对手术机器人触觉共享控制中的安全几何影响,提出多智能体强化学习框架,并在仿真与真实操作者输入中验证。
Learning Safety-Constrained Whole-Body Loco-Manipulation for Lunar Surface Operations
针对月面机器人自主安全移动操作,提出约束强化学习全身单策略,并在月球类比仿真多地形中验证。
Embodiment-Aware Inference-Time Search for Human Reaction Selection in Humanoid Retargeting
针对人形交互数据与专用反应模型训练成本高的问题,提出具身感知推理时搜索,并在不同人形具身形态的反应重定向中验证。
Shaping the Future of Generative AI for Black Communities: A Frame Analysis of Public Discourse and Empirical Scholarly Research
研究通过系统文献综述与媒体话语框架分析,考察 genAI 对 Black communities 的影响及话语错位。
Exploring the Limits of Combinatorial Generalization in Embodied Manipulation
针对长程具身操作技能重组难题,提出HSE、RoboCombine和PRTI,并在RoboCombine上验证有序成功率提升。
Imitation Learning via Discrete and Rhythmic Primitive Composition
针对长时程机器人操作的子任务组合问题,提出NDC用原始轨迹监督组合DMPs,并在2D handwriting和3D robotic tasks上验证。
Recovering Low-Bit Failures in Vision-Language-Action Policies via Quantization-Conditioned Reinforcement Learning
针对VLA量化导致任务完成下降,提出QCRL离线RL方法,并在真实世界试验与多种低比特设置上验证。
Sensing via whole-body interactions with complex terrains: physical insights from robotic models
本文探讨生物启发机器人物理模型如何识别复杂地形全身交互产生的机械信息,并以三个案例验证机制与行为益处。
Look Before You Move: Agent-Interface-Aligned Supervision for Open-World Mobile Manipulation
针对语言指令下的开放世界移动操作,提出AIDA数据对齐流程,并在OWMM、真机和导航子集上验证。
Geometry-Aware Predictive Control for Walk-to-Run Bipedal Obstacle Crossing
提出几何感知预测控制框架,结合相位化轨迹生成与约束MPC,在降阶仿真中验证步行和跑步越障。
A Hardware-Partitioned micro-ROS Mini-Vehicle for Operator-Supervised Neural Driving
面向嵌入式神经驾驶研究,提出硬件分区的低成本微型Ackermann车,并在真实闭环神经驾驶中验证。
Phase-Gated Constrained Reinforcement Learning for End-to-End Capture and Detumbling of Non-Cooperative Targets
针对非合作翻滚目标捕获与消旋,提出带平滑接近门的约束强化学习单策略,并在随机试验中验证。
Pessimistic Latent Task-aware Optimization for Robust Offline Meta-Reinforcement Learning
针对COMRL在参数外推任务中潜变量越出训练支持的问题,PLATO通过外推扰动潜变量并用悲观权重想象转移,在MuJoCo基准验证。
Kinematic Reward, Measured Effort: Hardware-Validated RL Morphology Optimization of a Planar 2R Manipulator
该工作用以 Yoshikawa 可操作度为核心奖励的 PPO 优化平面 2R 机械臂形态,并在仿真与硬件上验证关节负载降低。
Harnessing VLM in Embodied RL: From Reward Regressor to Success Detector via Exploration-Augmented Key-Observation Gating
针对从零开始具身RL奖励设计,VLMeg将VLM用作成功检测器,并在MetaWorld和真实实验中验证。
ADAPT: Audio-Depth Action Planning with Transition-Aware Rewards for Lights-Out Industrial Navigation
针对无可见照明工业导航,ADAPT结合空间音频与深度并用TARS强化学习,在DarkNav-Bench上验证。
CoLA: Multi-VLA Coordination via Learned Adapters
CoLA冻结各智能体VLA骨干,学习消息通道和扩散动作头,在三类多臂交接任务中验证显式通信何时必要。
Hand2Robot: Object-Centric 4D Hand Reconstruction from Human Demonstrations for Robotics
Hand2Robot从人类任务视频中以物体为中心重建4D手部,并经交互优化和重定向生成监督,在基准与真机任务上验证。
P-BFM: Perceptive Behavioral Foundation Models for Humanoid Control via Unsupervised Reinforcement Learning
P-BFM将人形控制分解为地形无关意图与地形条件实现,并在复杂地形和Unitree G1零样本迁移中验证。
PhySimCode: A Benchmark and Evaluation Method for Physics Video to Code Generation
提出PhySimCode,让模型从原始物理视频生成可运行Python仿真,并在程序生成样本上评估MLLM的视频到仿真能力。
ProWorld: Multi-View World Model with Proprioceptive Feedback for Closed-Loop Policy Evaluation
为降低机器人操作策略实机评估成本,ProWorld联合预测多视角视频与机器人状态,并在TriWorldBench和本地任务上验证。
REFLEX: A Learned On-Board Reflex for Robust Autonomous Collision Recovery of Soft Quadrotors
REFLEX在飞控上运行,用本体感知循环策略实现碰撞后恢复,并在仿真训练和硬件墙撞实验中验证。
RM-WAM: Reliable Memory-Augmented World Action Models for Long-Horizon Robot Manipulation
RM-WAM通过选择性利用短期视觉状态与潜在事件记忆,提升长时程机器人操作中的世界预测与动作决策,并在长时程任务实验中验证。
Beyond Fixed Visual History: Learning Motion-Adaptive Temporal Receptive Fields for Complex-Terrain Quadruped Locomotion
TempoLoco针对固定深度历史难适配运动状态的问题,以本体感知动态聚合多尺度视觉记忆,并在仿真与Unitree B2真机复杂地形上验证。
Successful but Unsafe: An Analytical Benchmark for Revealing Collisions in Vision-and-Language Navigation
针对VLN成功指标掩盖碰撞的问题,提出VLN-Safe双评估机制,并在R2R-CE六个已发表智能体上验证安全差距与碰撞防护。
Words to World: Benchmarking LLMs in Interactive Physical Environments
提出闭环物理交互基准,让 LLMs 控制连接真实组件的系统,并在代表性 LLMs 实验中评估其物理行动能力。
From Video to Vision: Learning Generalizable Humanoid Carrying from Human Motion
MOVER针对人形机器人搬运空间泛化差的问题,以视频重定向、多阶段RL与蒸馏训练,在仿真和真机搬运中验证。
Chunk-wise Model-based Policy Optimization
针对基于模型RL的误差累积、推理延迟与BPTT不稳,提出分块可微评估优化,并在HumanoidBench和真实四足行走验证。
Risk-Constrained MPPI Tuning with Update-Aware MA-ES Racing
将MPPI离线调参表述为机会约束黑盒优化,基于更新感知MA-ES并在三类车辆模型数值实验中验证。
Load-Aware Quadruped Navigation with Online Contact-based Geometry Estimation
提出两阶段载荷感知导航学习框架,结合LOADNav与CoGE,在杂乱环境不同载荷上验证四足机器人导航。
Scaling Latent Motor Adaptation to Coordinated Bimanual Manipulation
研究用基于交互历史的潜在条件化将RMA扩展到双臂操作,并在ManiSkill任务和双Franka真机举升中验证。
Flow-Support-Weighted Proposals for Test-Time Verified VLA Policies
针对VLA测试时采样候选冗余的proposal contraction,提出ADS以流支持加权校正训练,并在仿真和四个实体机器人任务验证。
Optoelectronically Enabled Simultaneous and Decoupled Navigation and Selective Pairing of Electrically Driven Janus Particles for Multi-Agent Microrobotics
提出基于可编程虚拟电极的光电子策略,在光导表面上验证多 Janus 粒子的独立导航、选择性配对与磁滚动操控。
Edge-Native Temporal--Graph Dual-Expert Inference for Dexterous Grasp Classification
针对多指接触不同步导致早接触手指过载,提出基于关节角和载荷反馈的DualExpert,并在离线、Flash部署和真机试验中验证。
Push the Limit: Learning High-Speed Sprinting and Aggressive Cornering on a Full-Scale Humanoid
提出学习框架,结合因果MHA、航向奖励和技能条件MAMP,在仿真与真机实现全尺寸双足人形高速冲刺和急转。
Scalable Multi-Human Cooperative Manipulation via Commander-Executor Coordination
针对角色相关、长时序顺序协作操作,提出分层 Commander-Executor 框架,并在多种物体操作任务上验证可扩展协作。
Persistent LLM Orchestration of Heterogeneous Robot Teams via Partial Delegation to Multi-Agent Protocols
针对动态且不终止任务中的异构机器人团队编排,提出状态摘要、部分委托与重提示机制,并在仿真城市场景验证。
Red-Teaming of Vision-Language-Action Models via Quality Diversity Environment Generation
针对VLA在轻微测试分布偏移下易失效,Q-DEG生成对抗环境并用成功轨迹微调,在仿真和sim-to-real中验证鲁棒性提升。
Global Optimality of Pose Graph Optimization
本文研究PGO非凸优化景观,提出噪声显式界下的全局最优充分条件,并在多种随机数值仿真中验证。
Compositional Average Velocity Modeling for Efficient Diffusion Offline Reinforcement Learning
提出InsQL以组合式平均速度建模实现单步生成策略,并在离线RL基准和真实机器人操作任务上验证效率与性能。
Barrier-Constrained Guidance For Real-time Asynchronous VLA Execution
针对异步VLA动作块边界错位,FreeBar以CBF启发约束进行免训练闭式校正,并在Kinetix、RoboCasa和真实机器人上验证。
Who to Trust in Multi-Robot Systems: Joint Robot and Object Hypothesis Trust Inference via Neural-Symbolic Cross-Validation
针对多机器人在部分可观测和潜在攻击下的信任推断,提出 NeST-Bayes,并在基准和 Webots 仓库中验证。
BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
BridgeWAM用32个LBQ在共享潜在空间桥接多模态先验与动作专家,并在LIBERO、LIBERO-Plus及真机延迟上验证执行、泛化与效率。
C2Flight: A Closed-Loop Co-Simulation Framework for Early-Stage Evaluation of Heterogeneous UAV Computing Systems
C2Flight用参数化数据流图和统一节点接口联仿异构UAV计算系统,并在机载与无线离板流水线上验证。
CAG-WAM: Causal Action-Gain World Action Models for Robot Manipulation
针对WAM候选动作未来评估受环境演化混淆的问题,CAG-WAM用因果动作增益指导训练与推理,并在多个基准验证有效性。
CFG-Policy: Unified Diffusion Policy Learning Framework via Classifier-free Guidance
针对扩散策略强化学习中性能提升与多样性保持的矛盾,CFG-Policy用双生成策略引导采样,并在MuJoCo和RoboTwin任务上验证。
DEFT-VLA: Stage-Localized Force Specialization for Contact-Rich Robotic Manipulation
针对接触丰富操作中的阶段性感知冲突,DEFT-VLA以双专家和接触局部力注意课程训练,在真机任务上验证提升表现。
DexCast: Learning Real-World Dexterous Control from Human Videos
DEXCAST通过联合HOI重建从单目RGB-D人类视频学习灵巧机械手控制,并在真实世界多样灵巧操作任务中验证。
Drive3R: Block-wise Streaming Geometric Foundation Models for Autonomous Driving
针对长时程驾驶序列稠密多视角3D重建难扩展,Drive3R以分块流式注意力和重锚定,在nuScenes、KITTI、Waymo验证。
EnactOpt: Diagnosis-Guided Harness Evolution for Embodied Agents
针对执行框架影响具身智能体决策的问题,EnactOpt用有限执行反馈联合演化文本技能与上下文构建代码,并在VLABench、ALFWorld和EAI上验证。
GG-Nav: Goal-oriented Grounding Chain-of-Thought Elicits Reasoning in Navigation Foundation Models
针对目标导向导航表现不足,GG-Nav以监督微调学习结构化CoT,并在多个基准和真机上验证。
HumanPhys: A Human-Centric Physical-World Perception Benchmark for Real-World Visual Reasoning
HumanPhys面向以人为中心的真实物理感知,程序化生成标签与训练语料,并在多种开闭源MLLM上验证六维能力挑战。
LETS: Low-Overhead External-Torque Sensing for Force-Feedback Bilateral Teleoperation
LETS针对双边遥操作外部扭矩估计问题,用物理引导学习降低传感器依赖,并在自由空间和接触遥操作中验证稳定力反馈。
PRISM: Precision Forcing for Generalist Vision-Language-Action Policies
针对VLA精密操作不可靠,PRISM按精度需求重加权监督并内化表征,在仿真和真机插接、拧紧任务验证。
SIMPLE: Simulation-Based Policy Learning and Evaluation for Humanoid Loco-manipulation
针对人形机器人全身移动操作评测难题,SIMPLE基准整合MuJoCo动力学与IsaacSim渲染,提供16项任务及千级资产。实验证实仿真策略可零样本迁移至真机,为具身智能研究提供可扩展验证基础。
StateSkill-Agent: An Effective and Efficient Embodied Agent via State-conditioned Skill
该工作面向具身MLLM智能体任务求解,提出StateSkill及演化优化机制,并在多种具身任务上验证。
Verify, Act, Distill: Turning Test-Time Compute into Test-Time Adaptation for Vision-Language-Action Models
该文针对VLA测试时计算收益需反复重算的问题,提出Verify, Act, Distill,将验证器聚合的成功执行监督蒸馏进LoRA,并在LIBERO任务上验证。
YOUDrive: Driving Style as a Composable Direction for End-to-End Autonomous Driving
YOUDrive用可缩放组合的风格方向控制端到端驾驶行为,并在NAVSIM navtest上验证。
Beyond Actions: Learning Future Operation Targets for Vision-Language-Action Models
针对VLA仅预测动作难表征结果的问题,AFCE学习未来Effect,并在DexJoCo上验证提升成功率。
Partitioning the magnetization raises the stability limit of ferromagnetic colloids
针对永久偶极导致胶体不可逆结合的问题,提出将固定磁矩分割为内部单元,并在57个样品和三种几何中验证稳定性提升。
Prediction-Informed Landing Window Planning for UAV Landing on USV in High Sea States
针对高海况下UAV在USV上自主降落,提出显式预测USV姿态的分层控制框架,并在真实海况数据驱动的MuJoCo实仿设置中验证。
Observation-Referenced Tissue Deformation Forecasting with Tool-Driven and Residual Dynamics
该研究用场景特定可微表面模型和观测参考形式,从未来器械运动预测组织变形,并在手术操作片段上回顾验证。
Dual-Stream Memory for Vision-Language-Action Policies
为记忆依赖操作,提出结合时间压缩与相关帧检索的双流记忆,并在RoboMME和真机任务上验证提升。
Composable Dynamics for Cooperative Humanoids: A RoboCompiler Extension
为物理连接类人机器人一致动力学,扩展 RoboCompiler 组装约化动力学,并在多构型状态与 MuJoCo 仿真中验证。
Low-Latency Mapless ESDF Queries for MAV Reactive Collision Avoidance
提出GPU加速无地图ESDF查询,直接处理带位姿深度图,并在仿真森林和机载森林飞行中验证MAV反应式避障。
Continuous-Time Cloth Dynamics with Physics-Informed Neural ODEs
ContinuousCloth用物理约束神经ODE求解连续时间布料动力学,并在仿真和真实序列验证插值、参数估计与加速效果。
Reinforcement Learning via Fixed-point Flow Matching
该文提出无数据的 FFM,用固定点迭代训练流策略,并在离线到在线和在线RL中验证。
Radar-Inertial Odometry With Online Spatio-Temporal Calibration via Continuous-Time IMU Modeling
针对RIO常假设已知外参且忽略时间错位,提出基于连续时间IMU建模的因子图在线时空联合标定框架。
Adaptive Whole-Body MPC with Optimal Posture Planning for Humanoid Robots under Unknown Payloads
针对人形机器人未知变负载搬运中的失衡问题,提出融合质心MPC、自适应模糊平衡与最优姿态规划的全身控制,并在仿真和硬件实验验证。
Noise Space Learning for VLA Adaptation
提出 NSL 在固定预训练 VLA 下学习上下文条件噪声分布,并在 LIBERO、RoboTwin 及四项真机操作任务上验证。
A Local Agentic AI Framework to Generate Edge Case Scenarios for Safety Assurance
提出在笔记本本地运行的 Agentic AI 框架,借助双 LM 循环生成并仿真评估自动系统边缘场景。
Refine Where It Matters: Contact-Adaptive Meshing for Deformable Object Manipulation
针对可变形物体接触局部建模与速度矛盾,提出接触自适应网格细化,并在真实操作序列中验证。
Tracking the Invisible: Self-Supervised Wheel Track Detection with Thermal-RGB Fusion
针对雪覆盖道路可行驶区域检测,提出RGB-I自监督车轮轨迹检测方法,并在恶劣白化路面实验验证有效性。
ATHLETE: Learning Reactive Humanoid Tennis via Trajectory-Guided Motion Matching
ATHLETE用通用运动数据和普通网球视频生成全身参考,并在真机人形机器人上验证反应式网球击球与多拍对打。
BT-Agent: Deploying Onboard Robot Agents with Behavior Trees and Multi-Fidelity Evaluation
BT-Agent将LLM任务决策与预定义行为树技能结合,在四足机器人和多保真基准上验证板载智能体部署。
Chronos Policy: Learning Robot Policies on Physical Time
Chronos Policy通过显式条件化观测与执行时间,解决时序变化下策略不稳,并在仿真和真实实验中验证。
EgoReveal: Learning Active Vision and Object Manipulation under Partial Occlusions from Egocentric Demonstrations
EgoReveal从自我中心人类演示学习视点重定位与操作,并在初始部分遮挡的物体操作实验中验证。
EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
提出EmbodiedCLBench,在具身仿真中以组合泛化评估自进化智能体的持续学习,并用多种智能体框架和学习方法验证。
Evo-RL: Iterative Robot Reinforcement Learning from Selective Experience
Evo-RL结合人工干预与优势引导的经验选择,在真实高精度操作任务上验证并提升机器人策略。
Evo-World: A Lightweight Vision-Language-Action Model with Future Motion Prediction via Optical-Flow Supervision
Evo-World用光流监督的未来运动预测增强轻量级VLA,并在仿真基准和AgileX真机操控上验证效果。
Grounded-Dreamer: Robot Learning from World Model Synthetic Data with Physical Grounding
针对机器人操作数据昂贵难扩展,Grounded-Dreamer结合视频世界模型与仿真物理生成带动作合成数据,并在真实世界任务验证。
Human2Dex: Dexterous Robot Learning from Wrist-Centric Human Demonstrations
Human2Dex用腕部中心人类示范接口,通过手表示、重定向和GPIR,在两种灵巧手六项真机任务验证跨手复用学习。
JANUS: Enhancing Long-Horizon Autonomous Research with Co-Evolving World Models
JANUS用共演化世界模型构建预测-验证-演化循环,缓解长时程自主研究执行反馈延迟,并在MLS-Bench-Lite和真实研究任务上验证。
JitterVLA: A Replay Benchmark for Motion Quality in VLA-Driven Human-Robot Manipulation
JitterVLA通过回放相同命令与到达轨迹隔离控制器影响,并在合成、人体轨迹、三种VLA流水线和UR3上验证运动质量。
JoyInside-VLM-Agent: Product-Conditioned Multimodal Policy Learning for Embodied Agents
提出JoyInside-VLM-Agent,通过产品条件化轨迹构建与分阶段策略学习,在机器人平台、智能硬件和公开基准上验证多模态动作生成。
LAPT-Scale: Scaling Embodied Policies with Latent Action Pre-Training on Human Videos
LAPT-Scale用人类第一视角视频的连续潜在动作预训练VLA策略,并在真机上验证成功率提升与视觉泛化。
MeshBind: Point-to-Mesh Binding for Non-Rigid Scene Flow Automatic Annotation
MeshBind用多视角网格重建与点到网格绑定自动标注非刚性目标场景流,并在SFB基准上验证效果。
OATH: Object-Agnostic Tracking for Dexterous Hands, Enabling Rapid Physics-based Retargeting
OATH用结构化接触误差信号的残差策略解决灵巧手物理重定向,并在仿真DexYCB轨迹上验证。
OGPO: Offline Goal-conditioned Policy Optimization for Recoverable Vision-Language-Action Models
针对VLA后训练难以从偏离演示轨迹中恢复的问题,OGPO用语义关键状态和目标条件奖励优化策略,并在多个基准上验证。
PATACON: GPU-Parallel Tangent-Bundle RRT-Connect for Constrained Motion Planning
PATACON针对约束全身运动规划开销高,采用GPU并行切空间双向规划,并在双臂闭链和人形全身约束任务上验证。
RARA: Robust Policy Fine-Tuning through Retrieval-Anchored Representation Alignment for Robotic Manipulation
RARA通过检索锚定表示对齐来适配少量示范,在仿真与真机操作任务上验证了微调成功率提升。
ReAT: Residual Action Tokenization for Autoregressive Robot Policies
ReAT通过用已解码重构反馈编码剩余动作误差,在仿真基准和真实场景的19个操作任务上验证自回归动作标记化。
RESCUE: Is This Alarm Worth Acting On? Counterfactual Evaluation of VLA Runtime Monitors
RESCUE通过恢复仿真器与策略检查点做反事实比较,评估VLA监控警报是否能在LIBERO任务上降低完成成本。
RoboFake: Are Deepfake Detectors Ready for Humanoid Face Robots?
提出RoboFake问题,测试六个FaceForensics++检测器在实体、合成与渲染机器人脸视频上的表现。
RSI-Anything: Unlocking Recursive Self-Improvement with World Models
提出基于JEPA-Anything的RSI-Anything,用预测世界模型指导行动与学习数据选择,并在多类计算和科学领域验证递归改进。
SADP: Subgoal-Aware Diffusion Policy for Long-Horizon Manipulation Learned From Foundation Model Generated Demonstrations
SADP利用基础模型生成子目标标注示教,训练扩散策略,并在RLBench仿真和UR5e真机评估。
SafeDiSTL: Decomposing Joint Constraints for Safe Multi-Agent Reinforcement Learning
SafeDiSTL针对共享约束下的多智能体安全信用分配,利用STL鲁棒性与可微敏感度分解违规成本,并在运输、导航和交通任务中验证。
SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
SimVTA用仿真渲染匹配视频补足候选轨迹监督,并在NAVSIM与HUGSIM上验证驾驶WAM后训练。
SmolWAM: A Latent World-Action Model for Robotic Manipulation on Edge Devices
SmolWAM通过重建Cosmos Policy推理接口,降低WAM边缘部署开销,并在400个LIBERO episodes上验证。
Sparse-TD-JEPA: Improving Zero-Shot Reinforcement Learning With Sparse Latent Task Representations
针对密集任务表示导致奖励弥散的问题,Sparse-TD-JEPA用l1稀疏惩罚改进TD-JEPA,并在DMC与OGBench验证。
Splat2Act: From Captured Scenes to Personalized VLA Manipulation
Splat2Act用手机扫描和物体图像生成仿真数据来个性化VLA拾取策略,并在101个扫描场景和真实Stretch 3上验证。
TAME-Nav: Temporal Asymmetric Mixture-of-Experts Distillation for Agile and Versatile Robot Navigation
TAME-Nav用时间Soft-MoE师生蒸馏提升复杂动态场景导航,并在仿真与真实四足机器人上验证。
VICAR: Video Imitation with Contact-Aware Retargeting for Humanoid Interactive Skills
VICAR从第三人称人类视频恢复运动与障碍,接触感知重定向后训练生成器,并在多种技能硬件部署验证。
What Visual Representations Do World Action Models Need?
针对WAM中VAE偏重重建而非操作的问题,研究比较视觉表征与集成机制,并在RoboCasa GR1 Tabletop和RoboTwin 2.0验证R²-WAM。
2DGS-Planner: Rasterization-based Path Planning in 2D Gaussian Splatting Map
提出2DGS-Planner,通过栅格化从2DGS地图读取几何信息,在地面机器人路径规划实验中优于测试基线。
What 30,000 Hours of Ego-centric Video Does Not Teach
通过扩展3万小时自我中心视频训练并改进视觉条件与监督,在离分布基准验证世界模型交互保真度,发现物体动态仍滞后。
From Solo to Ensemble: A Hierarchical Framework for Composable Multi-Agent Human-Object Interaction
针对单智能体人-物交互策略难以拓展至多智能体协作任务的问题,提出层级框架将单智能体策略转化为可复用技能,在多类HOI任务上验证了有效性。
From Asymptotic to Designer-Assigned-Time Control: A Review of Stability Notions, Design Mechanisms, and Controller Architectures
本文综述有限、固定、预定义和预设时间控制,区分时间性质、Lyapunov机制与控制器架构,并通过文献审计和标量基准比较验证。
Higher-Order Action Supervision Makes A Strong Policy Class
针对IL/RL仅监督动作标签导致的控制不稳定,提出零阶与一阶动作联合监督,并在OGBench、D4RL验证鲁棒性提升。
Acting from Belief, Looking When Needed: A Bayesian Spatial World Model for Navigation under Intermittent Perception
针对共享传感器间歇感知下的导航,ALONE以贝叶斯空间信念按需观测,并在仿真场景和真实室内飞行中验证。
Experience-Guided Initiation Search for Learned Skills in Skill Composition
EVIS针对新环境部署冻结已学习技能的起始配置搜索,结合历史经验与目标环境行为验证,并在单技能和两阶段操作任务上评估。
Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
提出COAP用代码从视觉和本体感知跟踪状态并决策,在RoboDojo双臂任务上验证无测试时模型的策略。
Towards Path-Creative Navigation: Robot Navigation through Embodied Interaction
提出PCN及无地图视觉-LiDAR-里程计框架,在仿真和两项真实任务验证交互式导航。
Toward Lunar Legged Robots: Field Deployment Lessons at LUNA
面向月面腿式机器人部署不确定性,论文通过2025年LUNA模拟测试,总结其在月壤模拟物与类陨坑地形上的行走和感知经验。
Control-Ready Uncertainty for Trajectory Diffusion
针对扩散轨迹模型不确定性提取开销高,提出 SCOPE 生成高斯管,并在预测、导航、控制与真机操作中验证。
Generative Neural Retargeting for Human-to-Robot Dexterous Manipulation
针对人类示教因具身差异难以直接用于机器人,GNR用流匹配采样可行轨迹,并在灵巧操作重定向与real-to-sim数据生成中验证。
Rendering-Free Lookahead for Question-Guided Active Vision
针对依赖视角的问答相机运动选择,RFL用离线特权视觉前瞻蒸馏免渲染策略,并在E3VS-Bench未见环境中验证。
Visual-Wi-Fi Navigation to Signal-Emitting Devices
研究机器人在未建图室内利用视觉与旁听Wi-Fi包寻找发射设备,提出WiFiSpaces与ViFiNav并在仿真和真机验证。
Assessing the Marginal Utility of Exocentric Head Views in UMI-Style Large-FoV Wrist-Camera Manipulation
该文比较双大视场腕部相机与额外头部视图策略,在真实双臂平台三项桌面任务中评估多视角收益。
Unleashing the Agility of Wheeled-Legged Robots for High-Dynamic Reflexive Obstacle Evasion
针对轮腿机器人快速反射规避难题,提出层次强化学习框架AWARE,并在仿真与M20真机上验证。
Non-Prehensile Multi-Object Placement with Mobile Robots via Diffusion-Based Trajectory Planning
针对移动机器人多物体精确非抓取放置,提出因果分解扩散规划,并在Push-T、多箱环境和TurtleBot 3上验证。
Unifying Policy Learning and State Prediction through Spatial Language Modeling
提出空间语言建模,用共享离散坐标与语义词元统一动作生成和状态预测,并在Push-T仿真与真实机器人上验证。
Recompose and Refine Latent Reasoning Flows for Vision-Language-Action Models
针对VLA每次查询重复重建潜在推理的问题,FLOWMEM复用成功潜在片段并精炼,在RoboMME和LIBERO-Plus验证。
Learning Language-Conditioned Traversability Representations for Adaptive Visual Navigation
LaTraNav学习语言条件化可通行性表征,结合慢速VLM与快速规划器,在多来源数据集上验证自适应视觉导航。
A Geometric Approach to Soft Actor-Critic with Zonotopes for Locomotion Learning
GeZo-SAC通过critic侧Zonotope几何宽度与分歧自适应悲观性,并在四个MuJoCo-v5运动基准上验证。
Q-Shaped Options for Hierarchical Reinforcement Learning
针对长时域目标条件任务中的动作抽象学习,QSO以层级Q函数塑造共享编码器,并在离线运动与操作环境验证。
A Minimal Optical-Flow Representation for Vision-Based Tactile Rotation Classification in Robotic Manipulation Across Gravity Domains
研究用模拟 GelSight Mini 的网格聚合稠密光流,在四种重力域下分类载荷诱发旋转。
Walking on Roofs: Exploring the Potential of Walking Robots for Construction Work on Roofs
研究首次系统评估四足机器人在屋顶环境的作业可行性。实验表明宇树Go2标配球足在25°斜坡即频繁失效,滑移量随倾角呈二次增长,验证了通用构型在建筑高空场景的局限性与专用化改进需求。
Leveraging Human-In-The-Loop Demonstrations in Reinforcement Learning for Digital Twin-Driven Robot Flexibility
提出结合数字孪生、强化学习与人类示范的在线训练框架,并在 Ufactory Xarm5 避障到达任务上验证适应性。
Rewiring Semantics, Dynamics, and Control: A Simple yet Effective Action-Centric Tri-Stream Transformer
针对 VLA 缺乏物理动力学先验的问题,ACT^3 以三流 Transformer 融合语义与动力学信息,并在仿真和真实机器人操作基准上验证。
ARC: A Reasoning Recipe for Robot Foundation Models
ARC框架通过因果推理轨迹与自动标注管线,无需新增数据即可增强RFM零样本能力。适配π0.5后真机任务成功率提升82.2个百分点,在RoboLab-Reasoning-50基准涨幅达50%,确立无需扩大训练规模的性能新SOTA。
Sim-to-Real RL for ASVs using SysID
针对水面机器人仿真训练痛点,提出基于系统辨识的RL框架。仅用CAD模型与少量实船轨迹即可逼近水动力参数,在BlueBoat上实现路径跟随与定点保持任务的零样本Sim-to-Real迁移,无需预知水动力及螺旋桨参数。
Being-M0.7: A Latent World-Action Model for Humanoid Robots
提出Being-M0.7潜空间世界动作模型,利用超1万小时混合模态人类数据预训练,通过三阶段迁移解决人形机器人演示稀缺难题。该模型在SIMPLE基准取得最高聚合成功率,并在Unitree G1实机移动操作任务中匹配最强基线性能。
BridgeGuard: Explicit Safety Drift for Diffusion-based Autonomous Driving
针对分布偏移下扩散驾驶规划可能不安全,BridgeGuard以渐强安全约束修正轨迹,并在Bench2Drive上验证提升。
CAPABLE: Capability-Aware Policy Adaptation via Behavioral Latent Encoding
针对VLA模型关节故障失效问题,提出CAPABLE框架。通过自监督能力推断与残差强化学习,无需故障标签即可在线修正动作。在LIBERO任务中成功率从24.8%升至59.3%,并在Franka Panda真机验证有效。
DaCe-DT: Data-Centric Offline Multi-Task Reinforcement Learning via Adaptive Prompts and Trajectory Correction for Heterogeneous Tasks
针对异构离线多任务强化学习的数据质量与分布问题,DaCe-DT通过自适应提示和轨迹校正,在Meta-World上验证了稳健学习效果。
DAMP: Humanoid Locomotion via Denoised Belief Learning and Adversarial Motion Priors
针对无外部感知条件下的人形机器人运动难题,DAMP框架利用RNN隐式推断特权信息并结合对抗运动先验,实现端到端Sim-to-Real迁移,在复杂地形验证了盲视状态下的鲁棒性与自然步态生成能力。
Dex-One2Many: Learning Dexterous Manipulation from a Single Human Demonstration
提出Dex-One2Many框架,利用时序场景图引导强化学习,解决单视频模仿学习中泛化与探索难题。该方法全仿真训练并零样本迁移至真实多指手,在未见配置下性能超越基线71%,显著降低灵巧操作数据采集成本。
EgoPhys: Estimating Peak Contact Force and Mechanical Work from Egocentric Manipulation Video
EgoPhys用RGB-only的CASA与TMTR,从自我中心操作视频估计峰值接触力和机械功,并在Hoi!测试集验证。
GLIO2: A GPU-Parallelized Tightly-Coupled LiDAR-Inertial-GNSS System for Robust and Real-Time Global Localization and Mapping
GLIO2通过GPU并行滑窗因子图紧耦合LiDAR、IMU与GNSS,在公开基准和自采数据上验证实时全局定位建图。
Residual Modeling Closes the Regression and Generative Policy Gap in Robot Learning
针对机器人模仿学习中回归与生成策略的性能鸿沟,提出异方差Student-t动作回归(HT-Policies)。该方法通过学习状态依赖的残差尺度抑制重尾噪声影响,在四个仿真基准及真机评测中达到与Flow-Matching相当的成功率,且训练推理速度显著优于生成式基线。
HWAM: Humanoid World Action Model With Joint State--Action Generation
针对人形机器人VLA策略执行偏差问题,HWAM模型将本体感知状态作为显式预测目标,通过三条互补条件路径联合生成参考动作与实现状态。在LimX OLI真机测试中,该模型糖果抓取任务成功率达70.6%,显著优于Fast-WAM基线。
Lamarck's Driving School: Discovering Autonomous Driving Training Strategies through Evolutionary Competition
针对自动驾驶训练场景分布价值难以由预设指标刻画的问题,提出Lamarckian进化框架,并在实验中验证。
LeWAM: End-to-End World and Action Modeling with JEPAs
LeWAM用联合潜在状态预测与动作流匹配端到端建模世界和动作,在视觉规划及仿真和真机行为克隆任务上验证。
Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
针对GUI智能体状态转换安全问题,提出无解码器世界模型LGWM。该模型在185万真实转换数据上训练,直接在表征空间预测下一屏幕向量。验证仅需向量比对,决策耗时17ms,AUC达0.987,较生成式模型快三个数量级且精度更高。
LiteNWM: Efficient Latent World Models for Onboard Visual Navigation in the Wild
LiteNWM通过共享视觉编码和潜在多时域预测选择轨迹,在离线数据集与未见室内外真机导航中验证。
ManiUnit: A Manipulation Skill Dataset and Benchmark for Long-Horizon Tasks
针对长程移动操作痛点,ManiUnit提供13.8万段技能数据与1260个测试实例。实测显示关节扰动致成功率降56%,技能策略局部成功率达78.7%,结合规划器使全任务成功率从4.0%升至18.0%。
MiniWAM: Learning Compact Future Targets for Efficient World-Action Modeling
针对 WAM 未来状态目标高维且训练成本高的问题,MiniWAM 用 PRISM 学习紧凑未来表示,并在多个仿真基准验证。
Tell Robot What Not to Do: A Negation Understanding Perspective
针对具身模型难以理解否定约束的痛点,NegaAlign通过插入式变换层与教师对齐机制,仅微调11.6M参数即赋予VLA否定指令遵循能力。在π0.5上实测成功率由2.6%跃升至88.45%,且保持肯定指令性能不变。
PanTact: Teaching Whole-Body Dexterity with a Wearable Contact Interface
为将人形机器人操作扩展到手以外,PanTact从无机器人真人示教学习全身接触,并在Unitree G1上验证。
PathTime-VLA: Path-Time Decoupling for Factorized Post-Training of Vision-Language-Action Policies
针对VLA策略时空耦合导致遥操作数据适配难问题,提出PathTime-VLA将运动解耦为几何路径与时间律。经三阶段后训练,该方法在三项任务中成功率达58/60,平均完成时间较固定速率基线缩短39%至52%。
PIER: An Evidence-Gated Execution Interface for Robotic Manipulation
为判断观测是否足以授权机器人动作执行,PIER分离证据检查与控制,并在阈值网格和合成轨迹上验证。
PLaW-VLA: Predictive Latent World Modeling for Vision-Language-Action Policies
提出PLaW-VLA架构,通过预测任务相关潜在状态替代像素重建,在RoboTwin Hard Horizon III任务成功率提升11.8pp,推理延迟降至生成式方法的1/19,验证了轻量化世界模型在VLA策略中的有效性。
PMTRM: Pseudo-Memory Temporal Re-encoding Module for Embodied Policy Learning
针对相位歧义导致的误动作,PMTRM将历史状态与动作重编码为潜序列,并在仿真和真机验证提升成功率。
PriMoRetarget: Humanoid Motion Transfer Through Prioritized Motion Retargeting
提出PriMoRetarget,以显式优先级层次替代权重调节,并在四类运动交互数据上验证重定向效果。
REACT: Rolling Denoising and Dual Decoupling for Reactive Robot Control with VLA Models
针对Flow-based VLA模型闭环控制中平滑性与反应性的权衡难题,提出REACT框架。通过滚动去噪维持动作缓冲与双解耦架构,在RoboTwin 2.0及真机双臂任务中显著提升成功率并降低延迟,实现高频流式控制。
Reflex: Visually Grounded Reactive Humanoid Control
Reflex 面向人形机器人接抛掷箱子,分三阶段学习视觉反应式全身控制,并在仿真和真实 Unitree G1 上验证。
REMM: Revisable Embodied Memory for Manipulation
REMM为冻结G0.5 VLA执行器加入可修订记忆层,在51次物理试验中提升干预恢复与序列回忆进度。
RESETTLE: Robotic Recovery through Disagreement-Triggered Retrieval and Efficient Corrective Control
RESETTLE针对机器人操作执行偏差恢复延迟,凭分歧触发检索与纠正控制,在仿真和真实任务中验证提升成功率并降低延迟。
RoboAware: Learning to Coordinate Embodied Skills from Counterfactual Outcomes
RoboAware针对具身技能组合中的策略族选择,借反事实分支结果学习状态条件协调器,并在100项单回合任务上验证。
RoboRSI: Stable, efficient, and reusable robot self-evolution in complex real-world environments
RoboRSI用Top-Down Skill Refinement组织执行经验,在移动操作机器人和多个仿真基准上验证机器人自我改进。
SafeInferCom: Safe Inference-Time Compute via Verifier-Guided Mid-Generation Intervention for Robotic Task Planning
针对LRLM机器人任务规划中有效中间计划被覆盖和约束未解问题,SafeInferCom用验证器引导生成中途干预,并在多模型、多规划域、VirtualHome及真机演示中验证。
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
针对大规模强化学习中均匀采样导致的算力浪费问题,提出Success Guided Sampling自适应采样器。在超百万并行环境中验证,成功解决复杂地形四足运动与接触丰富装配任务,并实现RGB策略真机零样本迁移。
SimVLA: Zero-Shot Sim-to-Real VLA Learning for Mobile Manipulation
SimVLA框架仅用合成数据训练移动操作VLA,无需遥操数据即实现零样本真机迁移。在补货、倒水等任务中性能超越50条真实演示策略,验证了多模态仿真监督对具身模型泛化的有效性。
SkillWeave: Weaving Heterogeneous Demonstrations into Long-Horizon Manipulation Skills
SkillWeave结合遥操作与动觉示教,并以掩码条件扩散策略和终端引导,在三项真实长时程任务验证灵巧操作。
SpatialHarness: Test-Time Spatial Scaffolding for Fine Robotic Manipulation
提出SpatialHarness,通过测试时同步仿真与虚拟视角增强空间可观测性,并在四个真机精细操作任务上验证。
STAG: A Sparse Traversability-Aware Graph Representation from Grid-Based Costmaps for Robotic Navigation
STAG将代价地图转为稀疏可通行图,在洞穴、矿井和DARPA CERBERUS地图上验证全局规划加速。
StereoEngine: Scaling Stereo Bimanual Robot Data without Stereo Cameras
为缓解真实双目机器人数据稀缺,StereoEngine用单目提升和仿真生成双目数据,并在双臂操作中验证。
SuperGrasp: Single-View Object Grasping via Superquadric Similarity Matching, Evaluation, and Refinement
SuperGrasp面向单视角平行夹爪抓取,通过超二次曲面相似匹配与E-RNet评估细化,在仿真和真实环境验证。
TACROSS: An Efficient and Low-Cost Scalable Human Touch System Across Heterogeneous Tactile Sensors for Dexterous Robot Learning
TACROSS通过接触事件级对齐异构触觉流,将低成本人类触觉手套数据迁移到机器人,并在四个接触丰富操作任务上验证。
Traceable World State: A Provenance-Aware State Representation and Deterministic Replay Framework for Robotic Systems
TWS针对长期任务世界状态难以溯源与复现的问题,提供语义表示和运行时,并在测试、任务定义与仿真轨迹上验证。
USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
提出USDCraft框架,利用预训练LLM编写可执行程序重建铰接3D资产。通过源几何分析与迭代校验机制,将残缺网格转为带物理属性的USD文件,直接适配Isaac Sim,在两项基准测试中实现领先铰接恢复并验证Sim-to-Real有效性。
VersaCamVLA: Camera-Configurable VLA Policies for Robotic Manipulation
提出VersaCamVLA框架解决VLA模型对固定相机配置的依赖,通过统一场景Token接口与腕部增强位姿采样,支持任意数量及位姿RGB输入。在RoboTwin、LIBERO及真机验证中性能优于现有基线,无需3D传感即可适应部署端相机变化。
VioLA: Learning Generalist Humanoid Control Policies from Human Data
VioLA通过预测身体与手部运动潜变量并由控制器执行,利用人类数据训练,在真机上验证零样本运动和操作。
VortexSynth: Profile-guided benchmark reconstruction for GPU architecture research
VortexSynth通过剖析选择热点内核并合成目标语言实现,在Vortex上以机器人应用评估GPU基准迁移。
WAM-Cache: Staleness-Bounded KV Reuse for Efficient World Action Models
针对WAM闭环控制中视频DiT预填充开销,WAM-Cache以陈旧度有界KV复用加速,并在仿真和真机验证。
WARP-VLA: Wrist-Camera Adaptation for View-Robust Policy Execution in Vision-Language-Action Models
针对VLA模型对腕部相机位姿敏感难题,WARP-VLA引入混合专家架构实现视图自适应。在LIBERO基准测试中,该方法将pi-0.5模型在腕部视角扰动下的平均成功率从39.2%提升至78.3%,且无需额外输入相机外参,仿真特征适配成功迁移至真机部署。
Lifelong small-object navigation in changing object layouts: a benchmark and method
本文提出LiSoNav-COL任务、LiSoNav-Eval基准和IVAM-Nav方法,并在室内场景小物体导航序列上验证效果。
Design of a Fully Actuated 4-DOF Robotic Finger With Joint-Specific Hybrid Remote Actuation
提出一种关节特异性混合远程驱动的全驱动4自由度机器人手指,并通过传动、指尖力和物体姿态实验验证。
Beyond Policy Support: Interaction Constrained Offline Reinforcement Learning for Autonomous Driving
针对自动驾驶离线强化学习中的交互分布偏移,提出ICDP,并在nuPlan、Interplan和真实卡车实验中验证。
Continual Graph Multi-Agent Reinforcement Learning
针对持续多智能体强化学习中的结构迁移与遗忘,提出CGMARL框架和FROG方法,并在GRAFO基准验证性能提升。
From Digital Human Interactions to Physics-Based Humanoid Skills: Physics-Grounded Post-Training of Interaction Generators
DIGHT将数字人交互生成器与人形跟踪策略协同适配,在仿真中用物理偏好后训练并验证交互执行。
When Listening Becomes Easier: Scrubbing Visual Cues for Shortcut-Free VLAs
针对VLA模型的视觉捷径学习问题,提出任务 scrubbing 域对抗训练方法,在仿真和真实环境中验证了方法的分布外鲁棒性提升效果。
Many Ways to Succeed: Diversity-Driven RL Fine-Tuning for VLA Generalization
针对VLA微调分布外泛化受限,DRIVE将成功行为多样性纳入RL目标,并在多个基准和真机上验证提升。
Energy-Efficient Gait Adaptation via Hierarchical Reinforcement Learning for Quadrupedal Locomotion Across Diverse Terrains
提出分层强化学习框架解耦运动执行与步态优化,基于Isaac三阶段训练实现零样本迁移。Unitree AlienGo实测验证了速度自适应步态切换,在多种地形下显著降低运输成本并提升跟踪精度。
Factorized Tactile Representation and Control for Sim-to-Real Manipulation
研究提出解耦触觉表征与控制框架,将接触响应分离为几何、力分布与时序变化。实测接触定位误差<1mm,力跟踪误差1.69N,真实世界对抗性插孔成功率较未解耦方案提升35%,验证了独立评估不同触觉表征迁移可靠性的有效性。
Borrowed Eyes: Markerless Nano-UAV Flight with an Active Quadruped Observer
针对GNSS拒止下nano-UAV自定位受限,利用四足机器人臂载相机外部定位,并在起降预定义轨迹飞行中验证。
Temporally Interpretable Differentiable Decision Trees
针对DDT单步树行为与人类多步规划不匹配,提出时间可解释性与动作分块方法,并在四个仿真环境验证。
Towards Accurate End-Effector Localization for UMI-Style Robotic Manipulation Teaching
针对近距操作遮挡下末端定位,提出MILD数据集与AprilVINS,并在真实记录和MILD-Sim回放中验证。
Event-Aligned Visual Action Reasoning for World Action Models
提出按交互事件组织视觉预测的框架,用于WAM动作生成,并在DOMINO和RoboTwin 2.0上验证。
A Scoping Review and Experimental Study on Reinforcement Learning from Human Feedback for Human-Robot Collaboration
针对HRC中RLHF的安全与反馈挑战,论文综述相关方法,并以VR实验验证反馈发起方式对安全感知的影响。
Learning-Based Data-Assisted Port-Hamiltonian Control for Free-Floating Space Manipulators
提出port-Hamiltonian框架下的数据辅助控制,用学习补偿未建模效应,并在自由漂浮空间机械臂姿态控制案例中验证鲁棒跟踪。
Precise SE(3) End-Effector Tracking in Whole-Body Humanoid Control
针对人形全身运动中的末端位姿精确跟踪,ResGAC结合几何导纳控制与残差强化学习,并在真实Unitree G1上验证。
Q-Learning with Scalar Adjoint Matching
针对流策略离策略RL微调中逐步伴随计算昂贵的问题,SQAM用标量伴随和值惩罚,在OGBench和真实双臂机器人上验证。
Enhanced INS/GNSS State Estimation using GNSS-Based Acceleration Measurements
针对低动态下标准 INS/GNSS 可观性受限,利用历史 GNSS 与运动模型提取加速度,并在真实无人地面车数据上验证。
Do Vision-Language-Action Models Understand Instructions? A Mechanistic Interpretability Study on Language Grounding
研究VLA动作生成是否依赖语言指令,用激活与归因 patching 分析两模型,并在 LIBERO 样本上验证。
Speaking the Navigator's Language: Trajectory-Grounded Instruction Translation for Frozen Aerial VLN Agents
针对空中VLN用户短指令与训练命令不匹配,TGIT从轨迹结果学习翻译,并在OpenFly、人类指令及CityNav/AirVLN上验证。
Controllable Crowd Generation through World-Model Planning
Ctrl-CWM用想象未来的World-Model规划整合人群生成与运行时控制,并在行人视频学习及避让、吸引场景中验证。
Enhancing Robotic Perception and Adaptability through Sensor Fusion and Origami-Inspired Designs
针对载荷和成本受限的移动机器人几何感知,利用折纸轮调节LiDAR视角并融合IMU/RGB-D,在室内外验证深度覆盖提升。
Robotic Boomerang Throwing via Model-Based Release Design
针对升力物体投掷中回旋镖返航难题,提出以释放状态为核心的模型框架,并在6-DoF机械臂上验证返航。
Contact-Aware Imitation Learning Through Contact Factorization
FACE将力分解为接触相对表示并估计法向与摩擦,在真实机器人接触丰富操作中验证跨接触条件泛化。
On-Demand Robotic Assembly via Differentiable Geometric Part Repair
针对数字设计到机器人装配需人工调参的问题,提出生成式AI与可微几何修复流水线,并在木质结构和双UR5e实物装配中验证。
Do My Samples Help? Compute Budget Allocation for Real-World Sampling-Based MPC in Contact-Rich Manipulation
研究接触丰富操作中SMPC固定计算预算分配,提出BAMPC,并在仿真与真机三项任务验证。
Terrain Traversal Without Motion Priors: Expert-Routed Humanoid Locomotion at Deployment Fidelity
该系统以地形分类路由五专家并用模型规划细化落脚点,在部署保真仿真中验证人形机器人复杂地形穿越。
Same Action, Different Outcome: Variability in Dynamic Cloth Manipulation
论文通过重复执行同一轨迹并设计变异性指标,系统评估动态布料操作在真实布料和模拟器中的结果差异。
Constrained Diffusion for Data-Scarce Orbital Monte Carlo in Constellation Tasking
该文针对参考轨迹稀缺下星座任务策略评估的轨道群体增强,采用力条件约束扩散并在传播样本和 GoDSAT 兼容活动中验证。
Temporal Visuo-Tactile Learning for Dexterous Grasp Stability
针对灵巧手抓取稳定性预测,训练时序视觉-触觉多模态模型,并在真实多指机器人重抓中验证。
World-Model Policy Arbiter for Goal-Conditioned Reinforcement Learning
WMPA针对离线GCRL中单一策略难以通用的问题,借助状态空间世界模型在OGBench上选择冻结策略并提升成功率。
Targeted Modality Dropout for Real-Robot Manipulation Robust to Intermittent Vision Loss
针对多模态模仿学习过度依赖视觉的问题,提出基于注意力选择丢弃主导模态的 TMD,并在双臂真机上验证。
Predicted Futures Are Not Enough: Learning Executable Goals for Robot Manipulation
该文针对世界模型预测难以直接用于控制的问题,提出Entity-Level Goal Readout,并在五个操作任务和Franka真机上验证。
Diagnosing and Recovering from Observation-Space Shift at Long-Horizon Skill Seams
研究长时程操作技能串联中的OSS,提出检测-恢复-继续系统,并在BOSS-44和真实Franka上验证。
Agentic RSR: Real-to-Sim-to-Real through Scene Reconstruction and Execution-Grounded Robot Policies
提出Agentic RSR框架,通过统一接口链接场景重建、策略生成与真机执行。18个场景四视图深度MAE为0.0808m,真机任务成功率保留仿真性能的80%,代码与数据将开源。
CMP-IRRT*: A Perception-Assisted Height-Adaptive Planner for Quadruped Robots
针对低矮障碍可通行而2D规划效率受限的问题,提出感知辅助的CMP-IRRT*高度自适应框架,并在2D基准、构造场景和Unitree Go2演示中验证。
Co${}^{2}$Skill: Whole-Body Control via Skill Composition for Long-Horizon Human-Environment Interaction
Co²Skill通过统一策略整合场景交互与灵巧操作,并在坐站攀爬、楼梯通行、目标操作及室内技能组合中验证。
COOL: Curiosity-Driven Object Ownership Learning for Personalized Robotic Assistance
COOL通过日常观察自主学习物体所有权并维护长期空间记忆,在离线与真实世界评估中验证个性化辅助。
ECHO: Embodied Camera Observations of Human Object Carrying
为预测搬运中物体目的地,提出情境物体放置任务与ECHO合成数据集,并在其上用探针和端到端基线评估。
EmbodiedRSI: Active Continual Robot Learning Through Hypothesis-Guided Co-Evolution
提出EmbodiedRSI,自主选择物理实验并将交互转化为代码和技能改进,在RoboCasa365、LIBERO-Pro及真实机器人验证。
FoldBack: Self-Correcting Masked Generative Policy for Long-Horizon Garment Folding
FoldBack面向长程服装折叠中的失误延续问题,以推理时自校正掩码生成策略在真实服装上验证。
Higher-Order Morphology Priors for Quadruped Reinforcement Learning Under Actuator Degradation
研究提出基于Hodge消息传递的高阶形态图策略,在Unitree Go1执行器退化场景下实现最高回报与更低速度跟踪误差,验证拓扑归纳偏置对全身补偿的有效性。
HuMBLE: Human Motion-Driven Behavior Learning for Embodied Locomotion
提出HuMBLE学习框架,通过教师-学生蒸馏与多任务RL微调,解决人形机器人仿生步态与指令跟踪冲突。在Atlas R1/D1及Unitree G1上验证,实现仅凭本体感知和躯干速度指令的实时可控仿生运动。
iAm.md: Robot Skill Self-Assessment through Agentic Introspection for Unknown Open-Vocabulary Domains
针对具身任务中的 grounding failure,iAm.md 用 Markdown 标准结合部署证据与开放词汇语义映射,在模拟 TIAGo 导航操纵任务上验证。
IcFuzz: Fuzzing Isaac Sim with Semantic Stage Guidance and Multi-level Mutation
IcFuzz面向Isaac Sim可靠性问题,采用语义Stage引导与多级变异进行模糊测试,以发现可能影响仿真的软件缺陷。
Informationally Decoupled Trajectory Design for Sim-to-Real System Identification
针对仿真到真机迁移中参数耦合难题,提出信息解耦轨迹设计框架IDTD。基于Fisher信息矩阵Schur补构建探索策略,在Go2、G1及K1人形机器人等平台上验证,平均参数辨识误差较最优基线降低39.6%,显著提升下游策略迁移效果。
Immiscible Diffusion Policy: Preserving Multimodal Robot Actions through Label-Free Noise Assignment
针对扩散策略动作模态坍缩,提出无标签动作-噪声分配,并在仿真与真实人形操作任务中验证。
Kuration SDK: Addressing the Virtual2Real Gap via Data Curation
论文针对动作条件世界模型的 Virtual2Real 差距,提出用数据策展与诊断属性度量,并在 CounterStrike 游戏数据上验证 Kuration SDK。
LACE-CRAFT: Robot Co-Design with Actor Inheritance and Blackboard Collaboration
LACE-CRAFT面向形态搜索与策略学习耦合中的经验丢失,通过策略继承和黑板协作,在五个运动基准和原型上验证。
LLA-MPPI: Rapidly Adaptive Whole-body Control of Legged Robots with GPU-Accelerated Parallel Simulations
LLA-MPPI通过选择GPU批量接触仿真器实现腿式机器人全身自适应控制,并在仿真任务和Unitree Go2上验证。
LLM-Enabled UAV Dispatch: A System-Level Survey and Taxonomy
该综述面向LLM赋能的UAV调度,通过统一表征和四类范式梳理文献,连接语义意图、符号决策与物理执行。
MESSENGER: Memory-Enhanced Sequential Scene Flow Estimation via Autoregressive Next-Frame Forecasting
MESSENGER用记忆缓冲与自回归下一帧预测解决序列场景流长时依赖和外推问题,并在nuScenes、Argoverse 2验证。
MultiFly: A Real-World Multimodal Aerial Dataset with Annotation-Efficient Label Transfer and Cross-Modal Semantic Consistency
MultiFly面向低空UAV多模态语义感知,通过几何标签迁移生成一致标注,并在RGB、热成像、LiDAR和雷达上验证。
NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime
NavGPT-3通过OS级运行时融合推理与动作策略,在RxR-CE基准成功率达90.43%追平人类,路径保真度78.47 nDTW。其8B VLA模型经1928万样本训练,将系统反应时间从秒级压缩至0.5-1s,代码与模型将开源。
OmniHOI: Dexterous Hand-Object Interaction from Monocular Human Video
OmniHOI将RGB手物交互视频转为灵巧手轨迹,并在动捕、单目视频和真实双臂机器人任务上验证。
OpenViTac: Learning and Benchmarking Visuo-Tactile Policies in a Unified Sim-and-Real Framework
针对视触觉操作缺乏统一评测痛点,发布OpenViTac仿真-真机配对基准及OpenVTLA增强框架。覆盖四类接触任务,系统评估VLA/WAM/VTLA策略,解析触觉表征与Sim-Real协同训练机制,填补具身触觉评测空白。
RoboPace: Contact-Aware Time-Optimal Retiming for Action-Chunk Policies
RoboPace面向VLA继承人类时序难迁移问题,在线接触感知重定时动作路径,并在双臂机器人接触任务验证。
RoboPrompt: Intuitive Robot Policy Steering with Sparse Human Input
RoboPrompt将稀疏人类指引转为动作草稿,并由基础策略细化,在多种策略和任务上验证可提升成功率。
RoboRender: Robot-Oriented Video Generation for Visual Sim-to-Real Transfer
RoboRender将仿真轨迹生成逼真RGB视频用于策略学习,并在视频测试集和真实机器人任务中验证零样本迁移。
RobotAPO: Adversarial Physics Preference Optimization for Robotic Manipulation Video Generation
针对操作视频物理一致性不足,RobotAPO用对抗物理偏好优化生成视频,并在AgiBot条件和真机回放验证。
RobotWorld: Benchmarking Multimodal Agents for Robot Use Across Diverse Tasks and Embodiments
RobotWorld在仿真中将指令和观测转为机器人接口执行,用84项任务评测多模态智能体能力与缺口。
SearchWorld: Spatial Value-Grounded Imagination for UAV Object Search via World Models
SearchWorld用连接显式空间记忆与价值引导想象的世界模型,提升UAV-ON上的无人机目标搜索。
TacHair: Tactile Contact-Distribution Guided Online Correction for Robotic Hair Stroking and Perception
TacHair用触觉接触分布引导在线校正,在真实机器人头发抚摸试验中提升接触保持与成功率。
TAPNAV: Humanoid Navigation through Tactile Active Perception
针对人形机器人在无视觉环境下定位漂移难题,提出TAPNAV触觉主动感知框架。该方案融合里程计、IMU与触觉观测,通过不确定性感知全局规划与信息增益驱动局部探测,在Unitree G1实机验证中显著降低状态估计误差并提升任务完成率。
TMT: Runtime Backdoor Detection for Vision-Language-Action Policies on Unseen Tasks
TMT用令牌流形与潜在转移建模检测VLA策略运行时后门,并在未见任务上验证。
TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
针对视频缺少接触与压力监督,TouchScale以统一可穿戴设备采集500小时人类视觉触觉数据,并在感知与机器人操作上验证收益。
Video Prediction Policy 2: Predict Better, Act Better
VPP2面向开放式操作中WAM预测错误问题,通过操作视频预训练、蒸馏与MoT动作模块,在视频预测、真机和基准任务上验证。
YUBI-STAG: Contact and Semantic-Rich Alignment for VLAs via Automated Video-Language Grounding
YUBI-STAG通过自动视频-语言grounding为操作演示生成交互语义,在YUBI-STAG-Bench和双手实验中对齐VLA细粒度指令。
ΔWAM: Distilling Action Tangent Fields into World Action Models
针对WAM监督易受外观持久性主导的问题,ΔWAM以Action Tangent Fields引导去噪监督,并在多个机器人基准上验证鲁棒性。
Beyond Retargeting: Low-Latency and Robust Humanoid Whole-Body Teleoperation with Learned Atomic Motion Primitives
提出无需重定向的策略与全身运动基元码本,将原始人体运动映射为关节命令,并在Unitree G1仿真和硬件上验证。
Beyond Reconstruction: What Matters in Action Tokenization for Robot Policies?
针对动作标记化不只依赖重建的问题,ProAct联合提升可预测性与鲁棒性,并在多个基准、VLA和真机操作中验证。
Learning Grasp Targeting from Point Clouds for Log Pile Clearing on a Hydraulic Crane
该文用未分割点云学习抓取位置、深度和姿态策略,并在仿真与拖车式液压林业起重机清垛中验证。
From Wearable Interfaces to Dexterous Policies: Contact Shifts and Tactile Representations
研究两版 DexUMI-family 外骨骼界面几何对触觉记录与灵巧策略学习的影响,并在四项操作任务上验证。
From Legs to Wheels: Embodiment-Aware Human Motion Retargeting for Mobile-Base Humanoids
针对轮式移动底座人形机器人与人体运动不匹配,提出任务条件重定向框架,并在任务空间比较、仿真回放和真机定性执行中评估。
A Continuous High Precision Localization Method for AGVs Based on Interferometric FBG Array Sensing and Hybrid Deep Learning
针对AGV连续高精度定位,结合干涉式FBG阵列传感与混合深度学习,在复杂工业条件实验中验证有效性。
Fast Non-Parametric Heteroscedastic Imitation Learning With Geometric Priors
提出结合几何先验的非参数概率模仿学习方法,面向数据稀缺与异方差不确定性,并在玩具示例和真实机器人操作任务中验证。
Teaching a Robot Dog New Tricks: Diverse Quadruped Skills via Combined Reinforcement and Imitation Learning with Adversarial Task Selection
面向多任务四足技能学习,提出三阶段多教师蒸馏,结合RL/IL和对抗式任务选择,并在22项任务及Unitree B1上验证。
Seeing the Invisible: Physics-Guided Visual Prompting for Temperature- and Radiation-Aware VLA Navigation
PG-VP通过物理引导动态视觉提示,让冻结VLA绕开温度和辐射隐患,并在OmniNav和真实机器人上验证。
Move Fast and Mend Things: Keeping Up with Evolving AI Harms Using Social Media Commentary
提出 LLM 辅助主题分析流程,从大规模 Reddit 数据动态检测、分类和追踪新兴 AI 危害。
Communication-Free Obstacle Localization from Aggregate Wrench Measurements in Leader--Follower Cooperative Transport
针对无显式通信的刚性载荷协同运输,设计跟随者控制律,使领导者由聚合力/力矩测量定位障碍,并在仿真验证。
Towards Efficient Robotic Manipulation Models with Self-Recursive Pruning
提出免训练的LCAM非结构化剪枝,通过自递归粗到细校准,在LIBERO、OpenVLA和真实乒乓中验证机器人操作策略压缩。
Towards an Extensible Benchmark for Spoken Dialogue with Social Robots
提出社交机器人口语对话基准,并以 Retico 支持实时通信,面向人机语音对话能力探索。
Micro Neural Policies for Safe Real-Time Robotic Control
针对受限嵌入式设备上的安全实时控制,结合ES与SMC验证搜索MNP,并在Cartpole、Quadrotor及物理系统上验证。
Localized Thermal Management of Induction-Heated Microrobots for Hyperthermia Applications
本文针对感应加热微机器人线圈寄生发热,比较外置水冷铜块与中空线圈内冷,并以100 s多点热电偶验证局部控温。
Variance-Averse $n$-Step Offline Reinforcement Learning for Sparse Long-Horizon Environments
针对异质离线数据中生成式策略易选高方差动作的问题,VAN-Flow用方差规避分布式评价与流匹配actor在D4RL和OGBench任务上验证。
Reactive Exploration of Unknown Environments for Redundant Robots using Virtual Model Control
针对受限遮挡未知空间探索,方法以目标体素评分结合VMC控制冗余机械臂,并在仿真与真机受限/开放环境验证。
Safe Multi-Robot Collaborative Transport Using Density Functions
提出分层密度MPC,使多台四足机器人仅凭初始与目标位姿在MuJoCo中安全推送共享物体。
Shared-Roadmap Generation and Evaluator for Multi-Agent Path Planning Using Heterogeneous Graph Neural Network
针对连续环境MAPP路线图取舍问题,提出异构GNN自动生成与评估共享路线图,并在多智能体取送任务上验证。
World Models Dream of Success: Diagnosing and Repairing Failure Insensitivity in Robot World Models
针对机器人世界模型难区分成功与失败的问题,CureWM用执行验证的反事实失败微调,并在LIBERO与实体机械臂上验证。
Feeling Through the Load: Compliant Quadruped Locomotion under Payload Interactions
研究提出力感知运动框架,解决四足机器人搬运无约束负载时的人机交互难题。通过解耦力估计与柔顺策略训练,仅利用本体测量即可区分负载运动与外部意图,实现稳定搬运、柔顺响应及基于推断力的人机协作轨迹引导。
Post-Grasp Kinematic Repair for Robotic Insertion via Object-in-Gripper Reorientation
针对抓取后插入路径可能运动学不可行的问题,提出夹爪内物体重定向修复,并在UR5e仿真和真机实验验证。
Modeling Latent Disturbances for Robust Decision-Making in World Models
研究世界模型潜空间鲁棒决策,通过构造并校准潜在动力学扰动,在仿真和Franka真机策略引导中验证。
Belief-Informed Hybrid Control with Almost-Sure Target-Set Convergence
针对参数不确定下混合系统到达目标集,提出信念信息双控制算法,并在平面调节和仿真双臂装配中验证。
Commit While Futures Agree: Consequence-Aware Adaptive Action Chunking for Robot Manipulation
针对动作块应执行多长再重规划的问题,CA^3C用世界模型想象后果,并在仿真与真机操作中验证。
Adapting Vision-Language-Action Models to Unknown Visual Disruptions During Execution
针对执行中未知视觉扰动,SALT用剩余轨迹自监督测试时适应,并在LIBERO-10和真机上验证。
Systemization of Knowledge (SoK): Human-Centered AI Safety for Youth
该研究系统综述100项HCI实证研究,用风险与缓解分类法梳理青少年AI安全风险、对策及其评估情况。
Revisiting Temporal Regularization for Smooth Control in Deep Reinforcement Learning
针对深度强化学习动作振荡,提出结合时间惩罚与线性渐增的CATS,并在仿真和真实世界验证平滑控制。
AutodidactWAM: Cross-Modal Self-Distillation from Generated Video to Robot Actions
针对WAM迁移到未见机器人时动作偏靶,AutodidactWAM从生成视频恢复动作并自蒸馏,在Unitree G1真机任务上验证。
BiGym 2.0: Benchmarking Learned and Agent-Developed Policies for Humanoid Household Manipulation
BiGym 2.0面向人形家庭操作,统一全身控制器,比较多类策略,并在Unitree G1的20项家务任务上验证。
CAP: Codebook-Aligned Prediction for Tokenized Robot Policies
针对动作令牌化策略忽视码本结构的问题,CAP复用量化器码向量作类别原型,并在仿真基准和真机任务验证提升成功率。
CUSP: CUSUM-Governed Survival Hazard Alarms at the Perception Onset for Off-Road Navigation
面向越野导航运行时危险报警缺失,CUSP从干预终止日志学习感知起点并用CUSUM报警,在五个未见场地验证。
DIVA: Dual-Space Intent-Aware Visual Attenuation for Vision-Language-Action Policies
DIVA通过意图感知的双空间视觉衰减调控视觉token影响,并在LIBERO和真实世界实验中验证提升。
EigenDEXplore: Structured Exploration for Dexterous Manipulation with Human Priors
提出EigenDEXplore,用人手先验特征向量结构化关节空间探索,并在多种灵巧手与操作任务中验证。
EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
提出EmbodiedSmith框架,通过递归自改进飞轮统一资产、场景与任务生成。支持人形及灵巧手操作流体与软体,实验证实数据多样性显著提升下游策略泛化能力。
ExoBridge: Learning a Bare Hand to Hand-Worn Exoskeleton Mapping through Human Limb Coupling
ExoBridge利用双手肢体耦合,从裸手视频预测外骨骼运动与触觉状态,并在四个操作任务演示上验证。
FlashNeRD: Performance-First Contact-Rich Neural Robot Dynamics
FlashNeRD用并行流式架构、任意接触编码和双向耦合,改进NeRD并在五个机器人实验中验证加速与精度。
geodex: A Library for Motion Planning on Riemannian Manifolds
为解决现有库不以配置相关黎曼度量驱动避障规划的问题,geodex以可互换组件实现采样式运动规划。
Humanoid Horizon: Extending Task Horizon in Whole-Body Loco-Manipulation via Parallel Training, Dynamic Starting, and Reward Gating
针对人形机器人长程任务中的奖励偏差与灾难性遗忘难题,提出Humanoid Horizon统一策略框架。通过并行训练、动态起始及奖励门控机制,在LHM-Humanoid基准双物体任务中实现单阶段成功率超80%,显著优于基线方法。
IdeaAnchor: Teaching LLMs to Turn Literature into Research Ideas
提出 IdeaAnchor,用结构化规格监督 LLM 从相关论文综合研究想法,并在研究构思实验中验证质量提升。
iGPC: Generative Motion Priors for Object-Aware Humanoid Interaction
提出iGPC框架将生成式预训练控制器扩展至人形物体交互,通过场景功能线索微调专家策略并蒸馏至感知学生网络,验证了大规模人体运动先验在接触丰富真实环境中学习可部署交互策略的有效性。
IronMan: Information-Constrained Video-Action Learning for Robot Manipulation
针对VAM中过多视觉细节削弱泛化的问题,IronMan用信息瓶颈约束视频特征,并在仿真和真实实验中验证。
LASER: Latent Space Adjoint Matching for Support-Constrained Entropy-Regularized Offline RL
LASER针对离线RL的OOD动作风险,在受限潜在空间引入伴随匹配与熵正则,并在40个OGBench任务上验证。
MIM-VLA: Learning Physical Interaction Representations from Gripper Motor Feedback
MIM-VLA将夹爪电机反馈编码为交互token,在真实物体阻力比较、真假辨别和易碎物抓取中验证。
OntoPlan: An Ontology-Grounded Scene Representation and Agentic Framework for Scalable Robot Task Planning
针对大环境长程任务中LLM规划退化,OntoPlan以本体场景表示检索相关信息并生成可执行计划,在室内任务上验证。
OpenSplatGraph: From Dense Semantic Maps to Structured Scene Graphs for Open-Vocabulary Robot Perception
OpenSplatGraph从在线Gaussian开放词汇语义地图构建持久3D场景图,并在标准基准和真实机器人实验中验证。
OpenWAM: An Open Framework for Composable World-Action Models
OPENWAM用因果机器人视频预训练与可配置视频-动作交互构建WAM,并在LIBERO套件和真实双臂任务上验证。
PACE: Stage-Consistent Long-Horizon Robot Manipulation via Progress-Aligned Context for Execution
PACE针对长时程操作中的阶段混淆,通过进度对齐上下文重解读演示,并在LIBERO-Gen与Block Routing任务上验证提升。
PEARS: Physical-Prior-Guided Efficient Adaptation via Failure Reasoning and Diffusion Steering for Tactile Manipulation
PEARS面向预训练策略在OOD触觉操作中的退化,结合物理先验失败诊断、力位控制与扩散引导RL,并在仿真和真实任务验证。
PhoneBot: A Low-Cost Open Humanoid Robot Platform Reusing Smartphones
面向教育与科研的开源人形机器人PhoneBot发布,复用消费级智能手机集成IMU、相机与算力单元。本体采用13个低成本执行器驱动模块化下肢,支持稳定行走、视觉跟随及移动遥操作,硬件与软件全开源以加速低成本具身智能原型验证。
PhysTacGen: Physics-Aware Visual-Tactile Sensor Image Generation
PhysTacGen结合材料描述与几何条件生成光学触觉图像,并在整理的SSVTP数据和下游代理任务上验证。
Plug-and-Play Dramaturge: A Divide-and-Conquer Approach for Iterative Narrative Script Refinement via Collaborative LLM Agents
针对长篇叙事剧本单次生成质量不足,Dramaturge 以分层多 LLM Agents 迭代审阅与协同修订,并在综合实验中验证效果。
QF3: Fast Flow RL with Filtered Q-Gradients
QF3用流匹配结合过滤的critic动作梯度训练流策略,并在人形运动、运动跟踪及操作微调任务上验证。
RIWANav: Recursive World-Action Models with Self-Improvement for Urban Navigation
针对长程城市导航误差累积,RIWANAV递归联合改进世界模型与策略,并在实验和真实世界试验中验证。
RLDISCOVER: LLM-driven co-evolution of reinforcement learning algorithms
RLDiscover用LLM驱动的渐进协同进化与概率评估,自演化无模型深度RL算法,并在SAC、PPO、DQN四个基准套件验证提升。
RobResilience: Implementing and Evaluating a Resilience Framework for Cyber-Physical Embodied Systems
RobResilience针对攻击下安全退化判定缺口,以运行时谓词与缓解策略在Webots中用PR2和ROS2验证。
StairVLA: Stage-Aware Hierarchical Action Generation for Vision-Language-Action Models
StairVLA针对VLA动作头均匀去噪的问题,以阶段感知分层生成在仿真基准和真机任务上验证降本保性能。
TacZero: Training-Free Peg Insertion Using a General-Purpose Vision-Language Model with Tactile Feedback
TacZero用预训练通用VLM结合视觉、机器人状态与触觉反馈,在真实圆柱销插入任务中免训练选择动作。
TAP: Efficient Long-Horizon Agent Pruning via Trajectory-Anchored Recovery
TAP面向长时程智能体推理成本,结合结构剪枝与轨迹锚定在线恢复,并在ALFWorld和WebShop上验证压缩效果。
ViDAL: A Visual Dynamics-Grounded Action Latent Space for Vision-Language-Action Models
ViDAL通过将连续动作潜变量与未来场景视觉动态对齐,改进VLA动作表示,并在LIBERO、RoboTwin 2.0和真实机器人上验证。
VLA-ACL: Action-Consistent Visual Token Pruning for Efficient Vision-Language-Action Models
针对VLA实时部署中长token计算开销,VLA-ACL以动作一致性学习轻量视觉token剪枝,并在LIBERO和真实操作任务验证。
VOMMI: Collecting and Leveraging Portable Demonstrations for Mobile Manipulation
VOMMI通过离线轨迹重建和在线视觉运动条件,将便携RGB示范用于VLA后训练,并在三项真机任务验证。
WareFly-VLA: A Vision-Language-Action Framework for UAV Navigation and Human Tracking in Smart Warehouses
提出WareFly-VLA框架与数据集,用语言引导无人机搜索、定位和跟踪仓库人员,并在Isaac Sim仿真数据上评测开源VLA。
Workhorse: Learning Robust Whole-Body Humanoid Loco-Manipulation from Human Data
Workhorse利用纯人类演示数据训练Unitree G1全身操作,无需重定向。视觉规划器预测五连杆目标,RL跟踪器执行动作,通过交叉误差增强提升鲁棒性。实测完成搬运、接物及攀爬,仿真搬运成功率77%,抗40N.s扰动达64%。
Learning Coordinated Visuomotor Box-Pushing from Solo Demonstrations
研究用遥操作单机器人数据学习多机器人协调箱体推动,系统考察数据构建与轻量策略,并在最多40机器人实验中验证。
What the Elevation Map Cannot See: Semantic-Aware Locomotion and Execution-Aware Navigation for Humanoid Robot
针对人形导航中高程图难辨隐患与执行偏差,提出基准和闭环VLN+运动控制框架,并在仿真与Unitree G1上验证。
When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
针对VLA长动作块在子技能切换处不可靠的问题,RACE预测切换时机并条件生成动作,在仿真基准和真实机器人上验证。
Wiring Matters: Injection Topology and Initialization of Affordance Heads in Vision-Language-Action Policies
研究VLA中可供性头损害指令遵循的问题,提出stop-gradient读取与桥接重注入,并在LIBERO验证性能。
Towards Quadruped-Provided Localization and Active Tracking for Micro-UAVs
该研究将 micro-UAV 定位转移到带机械臂的四足机器人上,并在实验室飞行中验证外部位姿支持自主飞行。
Dataset-Free Compliant Humanoid Loco-Manipulation with Dynamic Online Posture
OCLO无需人类运动数据,用在线姿态生成与顺应性学习实现人形移动操作,并在仿真和Unitree G1上验证。
Demonstration Calibrated Port-Hamiltonian Retuning for Manipulation Policies
针对部署控制器增益选择问题,PHRetune从演示学习Port-Hamiltonian模型,离线推导增益,并在LIBERO与真实任务验证。
Towards Decentralized Formation of Minimum-Length Communication Networks Using Robot Swarms
提出仅依靠局部交互的全去中心化框架,在具身仿真和实体多机器人实验中构建并维护近似最短的通信网络。
Toward Trustworthy Physical AI for Human Interaction
面向机器人进入人类空间后的信任判定问题,论文提出融合安全性、行为可理解性与感知对齐的可信Physical AI框架。
Physics Residual Dynamics and Reduced Order Whole-Body Planning for Obstacle Aware Human Robot Cloth CoTransportation
针对可变形布料协同搬运避障,提出结合p-cRVAE布料预测与降阶全身模型的层级规划,并在四场景两速度验证避碰效果。
Benchmarking Generative Trajectory Models for Active-Inference Control
提出GenAIF用单一生成轨迹模型从演示和动作干预学习,并在MuJoCo多物理条件操控任务中基准比较多类模型。
Analysis of SWIR Imaging Detection Performance Under Adverse Environmental Conditions for Autonomous Driving Systems
研究在 RASMD 上系统比较 RGB 与 SWIR 目标检测,提出传感器优势挖掘,验证 SWIR 在少数困难场景的互补价值。
Embedded Bare-Metal Radar-Inertial Odometry
面向低算力平台的鲁棒状态估计,提出单核微控制器上的雷达-惯性估计器,并在飞行实验中验证。
How (and How Not) to Use Data Augmentation in VLA Post-Training
系统研究图像增强用于VLA强化学习后训练,验证其在LIBERO-Plus分布外泛化上的效果。
Monocular Navigation Relative to Unknown Spacecraft Using a Transformer-Aided Kalman Filter
提出结合Transformer网络与MSCKF的单目位姿估计管线,并在SPE3R合成航天器渲染轨迹上验证未知目标导航。
Ultrasound Operator Guidance Using World Modeling and Retrieval Based Action Planning
面向超声操作者引导,提出基于 V-JEPA 2.1 的检索诱导世界模型,并在颈动脉超声回顾与前瞻实验中验证。
Arm-wise Compositional Generalization in Dual-Arm Vision-Language-Action Models
提出 ACG-Bench 并基于 π0.5 比较数据增强与架构策略,在仿真和 SO101 真机验证双臂技能重组泛化。
Robust Nonprehensile Object Transport with Quadruped Robots
提出面向四足机器人的鲁棒非抓取运输框架,结合不确定性感知轨迹优化、耦合凸MPC和全身QP,并在仿真与实物实验中验证。
Conditional Trajectory Peaks: Single-Pass Multimodal Policies over Action Chunks
CTP面向多模态模仿学习,用单次前向预测动作块候选、概率质量与尺度,并在多个基准和真实双臂任务上验证。
The Unexpired Plan: A Free Monitor for Accelerated Diffusion Policies
针对无训练扩散策略加速的可靠门控,提出读取未过期计划的监视器,并在114种配置和多个策略家族上验证。
Encoded but Not in Control: Revealing the Grounding Gap in Vision-Language Robot Policies
为辨别机器人是否真正遵循指令,论文用场景不变指令干预分析VLA与WAM,并在仿真和真实实验中验证语言接地缺口。
Robotizing Human Videos with Physically Consistent Interactions
该方法将人类操作视频转为物理一致的机器人兼容视频,并在RoboTwin任务与真实部署中验证共训练效果。
Controllable and Photorealistic Pedestrian Risky Motion Generation for End-to-End Driving Safety Evaluation
ControlPed结合冲突轨迹合成与3DGS生成可控照片级安全关键场景,并在88个渲染场景中评估端到端驾驶模型。
Adaptive Expert Guidance for Efficient On-Policy Reinforcement Learning
提出在训练回合内让学习器与专家交替控制并联合优化专家占比,在34个任务上提升on-policy强化学习样本效率。
Task-Space Imitation Guidance for Efficient Reinforcement Learning
TIGER面向稀疏奖励桌面机器人操作,用任务空间模仿引导构造奖励与预训练,并在仿真和真机实验中验证。
Hierarchical Reinforcement Learning for Collision-Free Locomotion of an Underactuated Biped
面向欠驱动双足避障与平衡耦合,提出SAC联合训练的HRL,并在随机PyBullet静态与动态环境中验证。
Execution-Aligned Progressive Noise for Consistent Asynchronous Replanning in Generative Robot Policies
针对异步重规划中动作块续接不一致问题,EAPN通过执行对齐噪声建模,在仿真基准和真实操作任务上验证。
BRACE: Adapting Whole-Body References for Force and Terrain Aware Humanoid Motion Tracking
BRACE将地形与手部力纳入全身参考适配,用本体感知策略在Unitree-G1仿真和真机上验证斜坡与负载跟踪。
CIRRA: Dual-Level Continual Instruction Reconciliation with Ongoing Execution for Embodied Robot Agents in Interactive Household Tasks
针对家庭机器人执行任务时接收新指令易出现规划歧义等问题,提出双层框架CIRRA,在基准数据集和Unitree G1人形机器人上验证了性能优势。
FreeSpeed: Training-Free Speed Control for Generative Robot Policies
FreeSpeed通过后处理预训练策略的动作块,免训练实现在线执行速度控制,并在仿真与真实操作任务中验证。
GAMBIT: Learning to Plan Continuous Multi-Robot Trajectories
GAMBIT面向多机器人连续轨迹执行,结合模仿学习、强化学习和安全回滚,在连续域实验中验证协调规划能力。
I-BFM: Reward-Conditioned Robust Humanoid Interaction via Unsupervised Reinforcement Learning
I-BFM用前向-后向表征与无监督强化学习学习人形-物体接触动力学,在多种交互任务和Unitree G1真机上验证。
Inspect Robots: Evaluating the Capabilities and Safety of Embodied AI
提出开源模块化框架 Inspect Robots,用于具身智能体能力与安全评估,并在六种前沿语言模型策略上演示。
KineWorld: Action-Induced Transport Fields for Embodied World Modeling
KineWorld用机器人运动构建传输场并重加权生成监督,在双臂操作数据上验证动作后果预测。
MobileVISTA: Generative Data Augmentation for Pose Generalization in Mobile Manipulation
针对移动机器人单点位姿训练策略脆弱问题,提出MobileVISTA数据增强框架。通过联合增强自中心视觉与重定向动作补偿基座偏差,在Galaxea R1 Pro实机验证中显著提升测试时分布外位姿鲁棒性,无需额外采集或生成模型。
MoonGS: High-quality Representation of the Lunar Surface via Gaussian Splatting Using Robust Depth Features from Image Pairs
MoonGS面向稀疏月球车图像重建,利用两图像前馈预测3D Gaussian,并在月表基准、合成数据和嫦娥影像上验证。
MRPilot: Supervising and Intervening LLM-Based Multi-Robot Teams through Mixed Reality
为解决基于LLM的多机器人系统难以检查和修改,MRPilot用混合现实监督干预,并在VR模拟家庭中验证。
Mulligan: Performance-Guided Data Collection for Efficient On-Robot Learning
Mulligan将初始状态分布作为决策,并结合价值函数,在真实和仿真高精度操作任务上提升监督部署数据效率。
P3: Persistent Particle Planning for Constrained Diffusion Control
P3以序贯蒙特卡洛复用候选轨迹,在多种测试时约束和迷宫导航任务上验证了更快且更成功。
RACER: Residual-Adaptive Closed-Loop Estimation for Sampling-Based Planning in Wheeled-Quadruped Racing
RACER面向轮式四足竞速,将MPPI、残差动力学与RL速度跟踪结合,并在仿真中验证性能收益。
RealtimeWAM: One-Step Asynchronous World Action Models
RealtimeWAM针对WAM推理低效,结合TACD一步动作生成与CEWP异步推理,在多个机器人基准和模型变体上验证。
ReDex: Repairing Sim-to-Real Dexterous Policies by Finger-Level Compliant Interaction
ReDex通过真人在真机rollout中柔顺纠正单指接触并利用指尖力反馈,适配仿真训练的灵巧策略,并在两项真机任务上验证。
SharedKV-BT: Node-Local Typed Decisions for Behavior-Tree Agents
SharedKV-BT用行为树节点局部字段与Shared-KV并行评分,缓解互依决策延迟,并在操作、导航和电脑使用任务验证。
SimForcing: Distilling Simulation Motion Priors into Real-Domain Robot World Models
SimForcing通过仿真运动蒸馏与仿真条件引导,生成真实域机器人视频,并在Bridge等数据集验证。
StageVLN: Spatial and Trajectory Auxiliary Guidance for Efficient Vision-Language Navigation
StageVLN通过训练期空间与轨迹辅助引导塑造VLN表征,并在R2R-CE和RxR-CE上验证无需推理期几何编码器。
TAPDreamer: Transferable Adversarial Patches for World Action Models
针对世界动作模型视觉输入易被局部扰动破坏的问题,TAPDreamer仅用公共编码器构造可迁移补丁,并在闭环基准上验证攻击效果。
TeleHairing: A Teleoperation Baseline for Robotic Haircutting
提出TeleHairing闭环遥操作架构,在假人机器人理发评估中量化部署、执行与中断影响。
A Safe Action Is Not Enough: Feasible-Future Decoding for Vision-Language-Action Policies
针对VLA策略可能选择无可行安全后续的动作,提出免训练VICS-G重排序器,并在六个Safety-CHORES设置验证。
Beyond LLM Serving: Characterizing Vision-Language-Action Workloads for Embodied AI System Design
本文针对VLA控制周期推理期限问题,通过批1性能剖析和闭环实验,在边缘GPU服务器与机载SoC上表征工作负载。
How Long, Not How Close: A Learned Temporal Metric for Planning in Latent World Models
针对远距离目标下潜在距离排序失效,TEMPO学习时间距离代价,并在十一种仿真环境与LeWM、PLDM上验证。
Educating future engineers about LLMs: A scalable workshop
提出可扩展游戏化工作坊,让工程硕士生通过网页提示 LLM 完成网格导航,并以问卷和 Spot 演示验证。
Robust 2D Traversability Mapping for Construction AMRs via Failure-Mode-Aware Fusion of LiDAR Geometry and Monocular Semantics
针对施工AMR的可通行性误判,提出LiDAR几何与单目语义的实时故障模式感知融合,并在自定义AMR施工场地数据上验证。
Tackling Sim-to-Real Mismatch Through Sampling-Based Disturbance Observers: From Analytical Models to Learned World Models
该文针对物理部署偏离标称模型的问题,提出 SDOB,并在仿真和真机实验中验证其补偿 Sim-to-Real 不匹配。
Nudge Before You Push: Physics-Aware Navigation via Tactile Probing
TANav通过短促触碰估计推阻,在站点边界下决定是否推开容器,并在仿真和四足机械臂上验证。
Optimal Control with Learned Critics under Unmodeled State Dependencies
针对难建模状态依赖限制MPC的问题,提出结合残差动力学与动作价值critic的学习型MPC,并在有偏和不完整建模控制任务中验证性能提升。
Now You Feel It, Now You See Me: Digital-Twin-based Teleoperation Interface for Dexterous Manipulation
针对裸手跟踪遥操作缺少力反馈和遮挡视觉反馈的问题,提出数字孪生AR界面,并在两项用户研究任务中评估。
Task Inference Beyond Least Squares in Behavioral Foundation Models
针对BFM用OLS推断任务向量导致零样本策略次优,提出BLS,并在运动、操作和人形控制基准上验证。
CoDance: Learning Reactive and Compliant Human-Humanoid Interaction from Video
CoDance从双人舞视频学习反应式柔顺人形互动,并在仿真与物理人形机器人上验证双手接触舞蹈。
EvoMem-VLA: State-Evolution Memory for Long-Horizon Robot Manipulation
EvoMem-VLA通过显式编码历史状态变化构建状态演化记忆,并在仿真基准和真实长程操作任务上验证性能。
FLEX-WAM: Flexible Block-Causal World-Action Models for Long-Horizon Imagination and Planning
FLEX-WAM用块因果可缓存世界-动作模型解决长时域高效稳定想象与规划,并在仿真、真实数据和机器人上验证。
PreAct-Nav: Agentic Reasoning Before Action for Urban Navigation
为解决远目标难以转为局部决策,PreAct-Nav用记忆与预测推理增强冻结策略,并在城市导航评估中验证。
RMMBench: A Comprehensive Benchmark for Robotic Mobile Manipulation
提出RMMBench评估VLM在连续空间中理解指令并执行导航-操作长程任务的具身能力。
TacGELLO: Tactile Contact Feedback for a 3D-Printed Teleoperation Leader
TacGELLO为无反馈被动主端加入夹爪触觉和关节负载提示,并在六次UR3会话中验证跟踪、时延与闭合量。
TUCO: Curating Simulation Demonstrations for Sim-to-Real Robot Policy Co-Training
针对真实数据稀缺下的策略协同训练,TUCO用影响函数筛选仿真示范,并在RoboMimic和OmniReset验证。
VAMPS: Visual and Motor Policies from Sampling-Based Planning
VAMPS用MPPI无人工示教生成监督,训练本体感知和视觉运动策略,并在仿真迁移与真机任务上验证。
Vela: Scaling Vision-Language-Action Models with Adaptive Action Curve Parametrization
针对VLA模型固定动作块导致的时序分辨率僵化问题,Vela提出基于样条的连续轨迹表征与运动依赖时间支撑机制。该模型在LIBERO-X、EBench及煎蛋饼、土豆丝等真实长程任务中验证了连续动作表征对提升操作精度的有效性。
VICON: Visual-Inertial-Contact based Hand-Object Tracking for Manipulation Datasets
VICON用视觉惯性手套、RGB-D与接触传感联合跟踪手物体运动和接触,并在40次动捕会话中验证。
Continual Humanoid Motion Learning
研究人形全身运动的持续学习,提出 Similarity-guided LoRA-PNN,并在六类序列技能与真机上验证。
A Bird's-Eye View of Iterative Reward Design
提出BIRD统一基准,用匹配反馈与训练预算比较迭代奖励设计方法,并在MuJoCo等环境验证简单设计选择可提升性能。
A Survey of Robotic Navigation and Manipulation with Physics Simulators in the Era of Embodied AI
本文综述物理仿真器如何缓解机器人导航与操作的 Sim-to-Real 差距,并分析任务特性、硬件需求与相关资源。
Humanoid Rickshaw Pulling: Whole-Body Locomotion under Coupled Wheeled Loads
提出人形机器人拉人力车全身控制框架,以教师-学生蒸馏和强化学习,在对比实验与硬件上验证重载运输。
Action-Consequence Alignment for Reliable Planning and Self-Improving in Latent World Models
本文针对潜在世界模型预测误差低但规划不可靠的问题,提出ACA训练目标,并在多种环境与评估设置中验证其效果。
Score-Calibrated Flow for Sampling from Unnormalized Densities with Applications to Generative Online Reinforcement Learning
针对在线RL中生成式策略难以从未归一化Boltzmann密度训练的问题,SCF用自一致流训练,并在RL基准验证。
Attention-Based Surface Representation Learning for Robot State Prediction and Open-Ended Surface Classification
针对户外地面机器人地形类别固定问题,提出结合下一状态预测与注意力块的方法,并在两个数据集上验证分类。
Exploiting Hierarchical Controller Structure in Contextual Parameter Learning for Humanoid Loco-Manipulation
针对分层控制跨层参数耦合难调问题,提出上下文贝叶斯优化,并在变质量物理推箱的类人移动操作中验证。
AgenticTactileVLA: Contact-Guided Execution-Time Supervision for Generalizable Dexterous Manipulation without VLA Retraining
提出AgenticTactileVLA,用本体接触反馈监督固定VLA执行,并在真机留出物体操作中验证提升。
EnvDreamer: Large-Scale Multimodal-to-Environment Generation for Embodied AI
提出EnvDreamer,利用语言与视觉语言模型生成UE5环境,并在导航、重排和操作基准上验证策略训练效果。
FoSeRL: Formal Sequential Robustness Certification for Reinforcement Learning Policies
FoSeRL无需改动策略,利用可重置仿真器认证随机环境中稀疏动作攻击下的回报损失,并在连续控制环境验证。
ROMA: LLM System for Real-World Object-Centric Multi-Sensory Active Perception
ROMA用LLM构建多感官推理-交互-反馈闭环,并在真实世界数据与ROMA Bench上验证主动感知能力。
ROOT: Discovering Rewards for User-Specified Embodied Behaviors
ROOT通过可观察树和视频语言模型引导奖励搜索,使策略对齐用户指定具身行为,并在仿真与真实Unitree Go2等任务上验证。
Terrain-Dependent Intra-Cycle Leg Timing for Effective Locomotion on Granular Slopes
针对足式机器人在颗粒斜坡上运动困难,基于阻力测量建立机器人-地形模型,并在可倾颗粒床六足机器人实验中验证。
Lightweight and Resource-Efficient Perception for Robotic Guide Dogs
面向机器人导盲犬的人本导引,融合360相机与2D LiDAR并结合VLM,在深度验证和GuideDogQA上验证端侧实时感知。
Reinforcement Learning from Real-Robot Interaction without High-Quality State Estimates
针对真实机器人RL中机载状态估计不准的问题,提出RSSM-RLPD,并在NAO带球射门真机与仿真中验证。
GOTT: Object-centric Dexterous Manipulation with a Reusable Cross-Embodiment Primitive
针对多指机器人难以复用地建立接触的问题,GOTT以跨具身接触获取原语构建reach-acquire-move框架,并在仿真和真实实验中验证。
MobiAgent: Dual-Loop Recursive Policy Self-Improvement for Long-Horizon Mobile Manipulation
MobiAgent面向长程移动操作,用双循环框架结合原子技能规划与自主学习,并在仿真和真实任务上验证。
RATE: Risk-Aware Tactile Encoding for Contact-rich Robotic Manipulation
RATE针对富接触操作中的触觉歧义,学习任务条件风险表征,并在仿真和真实世界实验中验证成功率提升。
TACET: Context-Appropriate Acoustic-Social Navigation for Quadrupeds
TACET针对四足机器人噪声社交导航,用视觉语言推理与反应控制协同,在真实四足机器人场景中验证。
Multi-Fidelity Policy Gradients Stabilize Data-Scarce Reinforcement Learning
针对目标域数据稀缺导致的on-policy RL不稳定,提出MFPG-PPO,并在仿真机器人运动和实体Franka臂上验证。
Watch, Infer, Coordinate: Inferring Robot Partner Constraints for Zero-Shot Coordination
研究机器人从协作观察中推断伙伴物理约束,并用联合行为评分方法在三个物理耦合操作设置验证零样本协调。
Continue, Abort, or Fall: Viability-Aware Policy Selection (VAPS) for Safe Humanoid Acrobatics
VAPS用短时域可行性预测在跟踪、中止和保护性跌倒策略间选择,并在仿真及LimX Oli侧空翻上验证安全杂技。
Experience-Based Feasibility-Aware Generative Adversarial Imitation from Observation under Embodiment Mismatch
针对人机具身与动力学差异导致示范不可行,EF-GAIfO用机器人自身经验估计可行性,并在仿真行走和真机四足物体到达与抓取任务验证。
A Semantic Autonomy Framework for VLM-Integrated Indoor Mobile Robots: Hybrid Deterministic Reasoning and Cross-Robot Adaptive Memory
针对语义室内导航中的指令目的地关联与经验保留,SAS以确定性优先级联结合VLM,在室内物理机器人配置上验证。
Filter-Aware Fine-Tuning for Safe Humanoid Whole-Body Tracking
针对人形机器人安全全身跟踪,提出滤波器感知微调CoFiT,并在多约束场景与Unitree G1真机上验证。
Replanning human–robot collaborative tasks with vision–language models via semantic and physical dual–correction
面向人机协作装配中的模糊纠正指令,提出结合内外纠正、6-DoF抓取与无碰撞规划的VLM重规划框架,并在仿真和真机验证。
Learning Multiple Timescales for Goal-Conditioned Reinforcement Learning
针对离线GCRL长时程任务信号不足,GITA以k条件化价值函数聚合多尺度监督,并在OGBench验证提升。
Model-Based and Neural-Aided Approaches for Dog Dead Reckoning
提出仅用惯性传感器的DDR三种算法,并在犬类与机器狗数据集上验证神经辅助方法优于模型方法。
Reusing Past Samples in Proximal Policy Optimization: When and How Does It Help?
本文研究PPO样本复用,提出多重重要性加权下的wPPO-U/BH,并在连续控制任务上验证其对效率与性能的影响。
FERPO: Forward Entropy-Regularized Policy Optimization
提出FERPO,用无需动作求导的前向KL拟合目标动作分布,在MuJoCo Playground和ManiSkill验证性能与样本效率。
GlassGuard: Verified Glass Plane Mapping for Robot Navigation
GlassGuard面向玻璃导致的LiDAR建图缺失,融合视觉与LiDAR证据重建平面玻璃,并在真实楼宇机器人行驶中验证。
GrandTour: A legged robotics dataset in the wild for multi-modal perception and state estimation
GrandTour解决缺少大规模公开真实腿式机器人数据集的问题,通过ANYmal-D多传感器采集,覆盖复杂室内外环境。
HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution
提出HumanoidToolBench和ToolBook,评测人形机器人从工具选择到移动执行的工具使用,并在仿真和真实Unitree G1上验证。
Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models
针对机器人基础模型多步流匹配推理慢痛点,提出Kinematic MeanFlow单步策略。通过运动学恒等式解耦速度场动态,使GR00T-N1.6动作头延迟降低67.5%~74.4%,端到端延迟减少30.3%~54.9%,代码已开源。
NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
针对跨具身数据复用难题,提出NarrativeFlow模型,将机器人轨迹建模为语言条件连续速度场。该方法在标准数据集及真实操作任务中成功率均优于基线,实现具身无关的运动表征学习。
ReCo: Response-Consistent Locomotion with Policy-Aware MPC for Legged Manipulation
ReCo通过响应整形与闭环响应模型结合MPC,实现行走中末端跟踪,并在仿真基准和真实实验验证。
SoTa: Soft Tactile Skins for Dexterous Manipulation
SoTa用共享布局的低成本全手触觉皮肤缓解视触觉数据稀缺,并在人机示范共训练和三项操作任务中验证。
World Motion Models: Flexible Sequence Modeling of SE(3) Trajectories
提出WMM,以稀疏SE(3)位姿轨迹和流匹配建模动态3D世界,并在6类3D视觉与机器人应用中验证。
Beyond Policy Alignment: Closing the Planning-Learning Loop for Robot Control with Learned World Models
PL-MPC通过改进评论器监督、终端价值估计与动作蒸馏,处理规划-学习闭环,并在HumanoidBench、DMControl及KUKA真机任务上验证。
Tactile Curiosity Drives Robot Interaction
针对RL操作探索样本低效,TacEx将触觉纳入不确定性好奇心,在抓取、取放和VLA后训练中验证。
Learning Goal-Reaching Quasimetric Geometry From Finite-Time Reachability
针对GCRL中拟度量约束需体现有限时域控制组合与环境可行性,ReQRL以有限时域可达性约束critic梯度,并在OGBench验证。
Reactive Humanoid Multi-Contact Using Learned Stability Models
针对低稳定场景下足接触易跌倒,方法学习冲击后CoP区域规划手部支撑,并在仿真和真机站立、行走推搡测试中验证。
Reward as Observation: Learning Reward-Based Policies for Rapid Adaptation
针对观测空间完全不同环境间迁移,提出仅以奖励和动作为条件的策略,并在三类环境及Habitat-Sim导航中验证零样本适应。
Toward Humanoid Robots in Construction: A Teleoperation Feasibility Study
针对建筑劳动力短缺、危险工况与自主难题,提出XR上身控制结合踏板行走的遥操作系统,并在两项施工任务上验证。
Experience-Driven Continual Learning of Terrain Traversability for Quadruped Robots
针对陌生地形安全高效导航,提出用运动经验从接触前图像持续学习交互结果,并在仿真与真机导航测试中验证。
Towards a General Humanoid Loco-Manipulation Model via Egocentric Whole-Body Human Data Pretraining
论文提出HumanVerse-500与λ0三阶段训练,学习人类经验迁移,并在SIMPLE和4个真实移动操作任务验证。
Game-Guided Skill Discovery through Self-Play for Playable Agent Control
GGSD用竞技游戏自博弈为具身智能体发现人类可玩的离散运动技能,并在Ant、Franka-arm和Unitree G1环境验证。
Concurrent Semantic Search and Mission Execution for LTL Missions in Unknown Environments
针对未知环境中的 LTLf 任务规划,提出交织语义搜索与任务执行的自适应高层规划,并在逼真室内环境验证。
Getting Out and Getting Back: World and Behavior Grounding in Real2Sim2Real Co-Training
研究用 Real2Sim2Real 分离世界与行为 grounding 生成协同训练数据,并在动态灵巧抓取分拣任务上验证性能提升。
BatSLAM 2.0: Sequence-Verified Sonar Place Recognition in a Robust Pose Graph
针对声呐地点识别歧义导致错误闭环和地图坍塌,BatSLAM 2.0结合声学前端、序列验证器与因子图位姿图,并在仿真和真实记录中验证。
CEER2: Directional and Tunable End-Effector and Root Compliance for Humanoid Loco-Manipulation
针对人形机器人接触中兼顾受力响应与任务运动的问题,CEER2以分层强化学习调制全身跟踪策略,并在仿真和真机人形机器人上验证。
DITTO-X: Forward and Reverse Teleoperation for Dexterous Manipulation and Human Intervention
DITTO-X通过力与接触反馈及反向遥操作,改进灵巧手示教和部署干预,并在接触丰富操作任务中验证。
ECHO-G: Embodied Co-speech Humanoid mOtion Generation
ECHO-G用音频与定时转录联合条件的扩散Transformer生成全身共语音人形机器人动作,并在数据集、基准和实体机器人上验证。
OccluDex: Hierarchical 3D Visuo-Tactile Representation Learning for Egocentric Dexterous Manipulation under Self-Occlusion
OccluDex融合多尺度3D几何与触觉接触表征,在仿真和Shadow Hand实机上验证自遮挡下灵巧操作。
StreamRig: Exploiting Intra-Rig Geometry for Streaming Multi-Camera Odometry
StreamRig在冻结多视角3D基础模型上构建因果流式里程计,利用标定多相机几何,在四个数据集上验证低漂移与低推理成本。
Geometry-Preserving Human-to-Robot Upper-Body Motion Retargeting from Monocular Video
提出保持几何的人到机器人上身动作重定向框架,从单目视频重建并映射动作,在16段视频、仿真和代表性真机演示中验证。
Planning Oriented 3D Scene Completion via Coupled TUDF Occupancy Representation Learning from Partial Observations
针对部分可观测下导航规划受限,提出联合预测 TUDF 与占据的 3D 场景补全,并在未见环境验证重建和规划提升。
Observability Analysis and Online Calibration of Visual-Inertial-Wheel Odometry for 4WIS4WID Mobile Robots
本文提出带在线标定的VIWO框架,基于四轮滚动与侧向无滑约束建模,并在仿真和真实4WIS4WID移动机器人上验证。
Dense Temporal Motion Retargeting for Legged Robots
针对形态差异下的动态动作重定向,DTMR联合优化每步时序与控制,并在四种人形机器人和真机迁移中验证。
Degeneracy-Orthogonal Geometric Constraints for LiDAR SLAM
针对长隧道和管道中LiDAR里程计纵向漂移,提出DeCOD横截面地标描述子,并在公开基准和现场实验验证。
Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
为评估GPT-6 Astra作为通用具身策略,论文在六个领域测试直接控制、与学习策略协作及反馈适应。
A robust single-sensing-element tactile sensor for concurrent pressure and tackiness detection with real-time signal decoupling capability
针对多模态触觉信号解耦与稳定性问题,提出霍尔传感器结合软磁复合材料的表面柔软触觉传感器。
Kinematic Nonlinear Spatio-Temporal Trajectory Warping for Contact-Rich Dexterous Manipulation Demonstrations
针对复用接触丰富灵巧操作示范,提出基于接触分布的非线性时空轨迹变形,并在公开人手运动数据上验证。
DispFlow-GS: Displacement Flow Supervision with Motion Disentangling for Monocular Deformable 3D Gaussian Splatting
针对单目可变形 3DGS 运动监督域差,提出位移流与运动解耦框架,在动态场景基准验证运动定位和一致性提升。
EgoAlign: Bridging the Human-Humanoid Gap for Long-Range Loco-Manipulation
EgoAlign将第一视角人类示教转为人形机器人全身控制监督,并通过微调视觉-语言-动作模型在物理人形机器人上验证。
EgoHumanoid-V2: Human-to-Humanoid Transfer of Coordinated Whole-Body Skills for Loco-Manipulation
EgoHumanoid-V2通过粗到细动作对齐与视觉适配,将人类全身移动操作技能迁移到人形机器人,并在四个真实任务上验证。
EquivDP3: A SIM(3)-Invariant Point-Cloud Encoder for Data-Efficient Humanoid Loco-Manipulation
针对人形机器人少演示视觉运动泛化,EquivDP3以SIM(3)等变VNN点云编码器构建分层扩散策略,并在模拟IsaacLab基准验证数据效率。
FP2: Equipping Robotic Foundation Models with Force Control
针对机器人基础模型在接触丰富场景中物理交互不可靠的问题,提出FP2轻量级下游接口。该框架采用动作-调节解耦架构,在4种RFM骨干与4项真实任务中验证,显著提升力调节质量与新物体泛化效率。
GlassFormer: Learning Real-time Glass Segmentation using Radar-Depth Fusion
针对透明表面易被光学感知误判为空闲空间的问题,GlassFormer融合毫米波雷达与RGB-D,在混合和低光测试划分验证实时分割。
HACo: Learning Haptic Active Compliance for Force-Aware Dexterous Manipulation
HACo通过触觉与关节力矩反馈学习主动顺应动作,并在真实多接触灵巧操作基准上验证力调节能力。
InsightMap: Structured Spatial Modeling for Embodied Multimodal Reasoning
InsightMap以俯视地图作显式空间记忆和动作条件预测目标,在导航、问答、推理、3D定位及Unitree Go2上验证。
NIDAR: NIR-Guided Intrinsic Decomposition for Scalable Scene-Agnostic LiDAR Intensity Reconstruction
NIDAR用伪NIR、本征分解与几何调制,从RGB和仿真几何合成LiDAR强度,并在Waymo、nuScenes及仿真SLAM中验证。
OTRetarget: Joint Robot and Object Motion Retargeting via Optimal Transport
该方法面向人类示范到人形机器人的运动迁移,用熵正则最优传输联合重定向机器人与多物体运动,并在OMOMO和真实G1上验证。
ProAct-VLM: Pre-Failure Vision-Language Task Replanning with Continuous Perception Feedback
ProAct-VLM通过实时感知反馈将VLM嵌入任务规划,在动态长程操作任务中提前重规划并验证成功率与效率提升。
Rho: A Foundation for Efficiently Adaptable VLA Models
Rho面向双臂操作,用开放权重VLA与具身中期训练提升少数据适应,并在仿真和实体机器人上验证。
Learning Expressive and Compositional Motion Representation via Spectral Skills
研究提出Spectral Skills潜在表征,通过预测式学习紧凑编码短运动片段。在29自由度宇树G1上验证,控制器全局跟踪误差较SOTA降低62%,支持技能链式组合与正交叠加生成新行为,并实现语言规划器硬件部署。
TaRL: Learning General and Physical Rewards from Tactile Demonstrations
TaRL从触觉变形图演示学习任务进度奖励,在仿真和真实操作任务中提升强化学习效率与成功率。
Video2STL: Grounding VLM-Generated Temporal Specifications for Robot Learning
提出Video2STL框架,将纯观察视频转为参数化信号时序逻辑规范用于机器人学习。在4项操作任务中平均成功率达85.8%,四足 locomotion 全速段100%成功,显著优于Text2Reward与原生PPO基线。
Wrench-ACT: Enhancing Robot Policies for Contact Rich Behavior Using Direct Wrench Control
提出仅输出力/力矩并由纯力控制器执行的模仿学习策略,在五个接触丰富操作任务上验证并匹配或超过位置基线。
Action Chunking Proximal Policy Optimization with Feedback Correction
面向高维机器人控制中的动作分块学习与反馈不足,提出ACPPO及在线校正器,并在25个仿真任务验证。
World model for robot learning: A comprehensive survey
该综述针对机器人学习中世界模型文献分散的问题,从机器人学习视角梳理其架构、功能角色与具身应用。
Assessing the Impact of Fleet Size on Crowdsourced Mapping Using a Dissimilarity Measure
本文用含GOSPAM差异度量的仿真框架评估车队规模对众包交通标志维护质量的影响,并在实验车数据生成的轨迹上验证。
Unified Visual-Tactile-Action Modeling from Human Demonstrations for Dexterous Manipulation
针对灵巧操作触觉示教难扩展,提出统一视觉-触觉-动作模型,利用人类触觉示教,并在五项真机任务验证。
Design and Validation of an Antagonistic Tendon-Driven Dexterous Robotic Hand with Bidirectional Operation
针对仿人灵巧手单侧抓取受限,提出双向拮抗腱路由手,并通过传动、力、重复性和抓取实验验证。
Embodied Semantic Communication for Collective Autonomous Agents: A Tutorial on Representation, Wireless Delivery, and Closed-Loop Coordination
本文提出具身语义通信范式,将信息传输转为面向行动的语义交互,并梳理其概念、技术路径与开放挑战。
Graph-Based Simultaneous Path and Foothold Planning for Multi-Limbed Intra-Vehicular Robots in Space Stations
针对空间站多肢舱内机器人抓附位置离散受限问题,提出基于图论的路径与落足点同步规划,并在ISS舱内3D模型仿真验证。
Simulation for Planetary Robotic Perception and Autonomy: A Concise Survey of Recent Capabilities and Gaps
针对行星机器人开发验证困难且仿真文献分散,论文按四个实践轴线综述感知与自主仿真工作。
Humanoid Loco-Manipulation With Discrete VLA Model
Holo-M面向人形机器人高维异构全身动作空间,采用统一动作分词与分组离散扩散解码,在SIMPLE基准验证并取得最高成功率。
Terrain-Aware Autonomous Planetary Exploration for Exteroceptive-Proprioceptive Mapping with Quadruped Scouts
提出融合RGB-D高程图与本体感知线索的四足地形感知探索框架,在Isaac Sim月球类环境中验证。
Proprioceptive Force Estimation for Quadruped Locomotion and Human-Robot Interaction
研究提出基于本体感知的三维力估计框架,联合训练估计器与运动策略。仿真中力估计RMSE为1.44-2.83N,速度跟踪误差降低21.6%,存活率升至94.6%。Unitree Go1实测验证8.5kg超载运动及同一接口牵引引导能力。
Sufficiency of Zeroth-Order Reward Shaping for Policy Gradient in Stabilization Control
研究稳定控制中奖励需包含的信息,证明策略梯度用零阶塑形即可求解,并在稳定任务上理论与经验验证。
Brain-Conditioned Action Policies for Neural Motor Decoding
BrainVLA通过语言对齐将神经活动接入预训练VLA策略,在两个神经运动数据集上验证运动解码。
Diffusion Subgoal Planning for Long-Horizon Offline Goal-Conditioned Reinforcement Learning
针对长时程离线GCRL价值引导不稳定问题,DSP用扩散式子目标生成进行分层规划,并在离线GCRL基准验证。
Behavioral Foundation Models for Quality Diversity
该工作用BFM紧凑潜在空间进行QD搜索,在连续控制基准上发现多样且高性能策略。
Predictive Semantic Safety: From Visual Physical Reasoning to Safety-Critical Control
PSS用VLM预测未来物理事件或位移,并结合备份安全过滤,在MuJoCo的Unitree Go1场景中验证。
Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
提出 Physical Coding 将任务状态与执行表示为代码,构建 HexaAnything,并在 RoboCasa365、PhyBench 和双臂 AgileX 机器人上验证。
ChronoSRL: Temporal Geometry for Self-Supervised Reinforcement Learning
ChronoSRL为critic嵌入引入时间几何,并在七个运动与导航基准及四足机器人仿真到现实任务中验证。
CollisionSplatting: Collision-Aware Motion Planning in 3DGS Scenes with Image-Conditioned Objectives and Adjustable Conservatism
CollisionSplatting在3DGS场景上用可调距离度量结合图像条件奖励,实现碰撞感知视觉规划并在真机导航与操作中验证。
DexRoam: Learning Mobile Bimanual Dexterous Manipulation from Egocentric Whole-Body Human Demonstrations
DexRoam通过无追踪采集与三阶段对齐,从第一视角全身人类演示学习移动双臂灵巧操作,并在真实世界VLA实验中验证。
ForVis: An In-Field Dataset and Benchmark for VIO Using Under-Canopy UAV Flights in Forests
ForVis面向森林UAV飞行中VI-SLAM评估,提供实地数据集与基准,并在七个开源系统上验证。
HOI-Retarget: Contact-Centric Retargeting for Human-Object Interaction
HOI-Retarget用接触中心重定向将人-物交互迁移到人形机器人,用于大规模运动数据生成。
KPI: A Promptable Kernel for Physical Interaction on Humanoids
KPI通过由轨迹源发送交互契约,自适应调整手臂控制,在人形机器人绞盘、开门、搬箱等任务上验证。
MagNav: A Dual-Core Magnetic Track Guidance Framework for Lighting-Invariant Navigation in Two-Wheeled Robots
针对TWIP机器人光照敏感的自主循线问题,提出磁轨引导级联PID框架,并在强光跟踪测试中验证。
MarsLab: A Martian Rover Simulator for Planetary Rover Autonomous Navigation
MarsLab面向火星车自主导航研究,基于ROS2与Isaac Sim构建可控火星环境,并在SLAM和VPR基准中验证。
Uni-VLaT: Whole-Body Tactile Adaptation of VLA Policies for Humanoid Loco-Manipulation
针对接触丰富的人形移动操作中视觉和本体感知不足,Uni-VLaT以全身触觉预测扩展VLA,并在五项真机任务验证。
WB-WAM: Heterogeneous Body-Hand Pre-training for Humanoid Loco-Manipulation
WB-WAM通过全身动作监督的生成式视频预训练,解决类人移动操作协同问题,并在仿真和真实任务上验证。
X-Reset: Scaling Object-Centric Reinforcement Learning via Cross-Embodiment Resets
X-Reset用人手-物体演示生成RL重置,缓解通用灵巧操作探索难题,并在20个物体、三种具身及Sim-to-Real上验证。
Beyond State-as-Action: Exploiting Command-State Discrepancy for Robot Imitation Learning
针对受约束交互中运动难以反映控制需求的问题,提出CSDW利用命令-状态差异加权监督,并在三项真机任务上验证。
Beyond Tasks: A Vision for Reproducing an Animal-like Behavioral Substrate Using Modern Robot Learning Techniques
提出以动物行为基底为视角,探讨现代机器人学习如何在机器人动物伴侣中研究持续交互与适应。
Multi-Terrain Mastery: A Comprehensive Controller for Bipedal Locomotion
提出单一多地形控制器,结合新冲击映射与实时控制结构,并在Cassie双足机器人上验证。
Estimate, Don't Imitate: Reusing Differentiable State-Based Policies for Visuomotor Control
本文通过训练带动作一致性损失的视觉状态估计器复用状态专家,并在五个操作任务和真实Panda上验证。
Learning with Object-centric Representations of Tactile Interactive Perception for Robot Manipulation
针对视觉难以推断的物体属性,提出触觉探索学习物体中心表征,并在三类视觉歧义操作任务上验证提升。
Humanoids for Robot-Assisted Surgery: Bimanual Base Placement and Tool-Mount Optimization via Capability Maps
针对人形机器人腹腔镜手术运动学需求,提出能力图设置优化,并在三类普外科手术中验证。
CompliantWBC: Whole-Body Compliance for Heavy Humanoids via Force Latent Estimation and Residual Impedance Targets
针对重型人形机器人任意部位受扰的全身柔顺控制,CompliantWBC结合RL基策略、力编码器与残差阻抗目标,并在仿真和真机任务中验证。
DAOCP: a dual active set solver for optimal control problems
DAOCP面向带逐阶段等式与不等式约束的线性二次最优控制,结合对偶主动集与结构递归计算,并在机器人基准上验证加速。
DexTaG: Tactile-as-Guidance in Reinforcement Learning for Dexterous Manipulation
DexTaG用手套触觉信号引导强化学习重定向人手示教,并在马克笔、锤子操作和OakInk2上验证。
Fiatlux: A Long-Horizon Benchmark for Humanoid Ladder Climbing and Light-Bulb Replacement
针对垂直移动与易碎载荷灵巧操作缺少统一评测,Fiatlux在Isaac Lab构建Unitree G1换灯泡基准并提供基线。
FoLD: Force-Informed Learning for Dexterous Articulated Object Manipulation
FoLD通过由人类示范和机器人交互状态计算力先验,学习残差策略,并在关节物体操作基准与真实灵巧机器人上验证。
VIDEAS: Distilling Explicit Action Semantics from Demonstration Videos for World Models via Prior-Guided Simulation
VIDEAS将演示视频蒸馏为显式动作语义,经先验引导仿真验证,用于训练并评测语言世界模型VIDEAS-WM。
Think Fast, Plan Selectively: Adaptive Deliberation for Efficient Data-Driven MPC
针对数据驱动MPC逐步规划开销高,Fast-TD-MPC自适应切换策略执行与测试时规划,并在103个连续控制任务验证。
Action Shaping: Policies Absorb What They Can Express
针对训练加动作偏移、部署移除无保证的问题,提出action shaping条件,用门控线性头促使策略吸收可表达偏移,并在20个任务上验证。
FutureRay: Control-Aligned Future Range for Agile Quadruped Navigation
FutureRay预测未来方向距离和遭遇风险,结合局部规划,在动静态仿真场景和实体四足定性试验中验证避障。
GAUGE: Planner-Conditioned Active Calibration of Opaque Quadruped Velocity Interfaces
GAUGE针对商业四足速度命令与实际运动偏差,基于贝叶斯模型主动选试验,并在受控响应族和Isaac Sim导航地图验证。
GlowTact: Simple and Compact Vision-Based Tactile Sensing with High Sensitivity and Spatial Resolution
GlowTact用压响应视觉机制直接呈现接触压力,在触觉传感实验中验证高灵敏度与丰富空间细节。
Learning Vision-Based Agile Gap Traversal: Differentiable Simulation with a Warm-Started Critic
提出两阶段强化学习框架,用可微仿真QPG与预热critic训练自中心视觉四旋翼穿缝策略,并在真实实验验证。
Bridging Body and Brain: Gene-Driven Morphology--Control Co-Design
针对形态与控制缺乏显式高层协调,提出Morphogene与GeCode,并在2D和3D协同设计任务中验证。
Grasp2Twist: Learning Bimanual Dexterous Jar Opening by Reinforcement Learning
Grasp2Twist用强化学习学习统一的双手抓握到旋拧策略,并在物理系统的六种家用容器上零样本验证。
HIRE: History-Conditioned Interaction Reasoning and High-Rate Execution for Visually Aliased Precision Manipulation
HIRE通过历史条件交互状态推理与高频执行,解决接触关键精密操作的视觉歧义,并在真实机器人表面、插入和旋转交互中验证。
PanoPed: Beyond Bounding Boxes for Sim-to-Real Panoramic Pedestrian Tracking
PanoPed提出全球面行人跟踪基准与Sextant角定位头,在合成与真实全景视频上验证提升跟踪效果。
Praxis: Distilling Physical Interaction Priors from Egocentric Videos for Generalizable Whole-Body Manipulation
Praxis从单次第一视角视频提取交互先验,结合姿态校准与在线感知,在五个长时程操控任务中验证泛化。
SeA-RVINS: Semantic-Aware Tightly Coupled RTK-Visual-Inertial System with Correlation-Preserving Robust Estimation for Urban Navigation
针对城市绝对位姿估计受异常值和错误关联影响,SeA-RVINS结合语义立体前端与保相关RTK鲁棒因子图,并在TEX-CUP路线验证。
TACTIC: Understanding Tactile Encoders and Conditioning for Contact-rich Robot Manipulation Policies
研究触觉编码器与融合策略对接触丰富操作策略的影响,并在真实实验中统一评估验证。
TRACKGRAPH: Online Open-Vocabulary 3D Scene Graphs via Image-Space Tracking
TRACKGRAPH通过图像空间跟踪减少逐帧分割与VL推理,在多个数据集、四足机器人和无人机数据上验证在线开放词汇3D场景图。
VisTacAlign: Co-Training Dexterous Policies on Tactile Human and Robot Demonstrations using Visual-Tactile Alignment
VisTacAlign通过视觉与触觉对齐,将人类和机器人演示共同用于3D视觉触觉灵巧策略训练,并在三项真实任务上验证。
Fly, Drive, Reconfigure: A Modular Reconfigurable Aerial-Ground Platform for Field Operations
HARP通过可独立部署的空中机器人模块自主重构能力,并在野外实验和格陵兰冰盖模块测试中验证。
Contact as a Decision Variable: Capability-Tradeoff Contact Selection for Legged Loco-Manipulation
该文针对腿式移动操作中的支撑接触与全身构型联合选择,提出CTCS并在仿真和真机实验中验证。
Echo in the Steps: Learning Perceptive Humanoid Parkour with Gated Memory
面向高度不连续地形中的人形敏捷越障,提出基于显著性引导时序感知与门控记忆的方法,并在仿真和真实世界验证。
Memory-Aware Multi-Sensor Perception for Efficient and Safe Navigation in Dynamic Environments
提出融合LiDAR与RGB感知、在线距离场表示学习和阶段自适应MCBF-QP的导航框架,并在复杂室内外环境验证。
Privacy-Preserving Prompted Policy Search for Robotic Control
PP-ProPS通过客户端秘密变换编码策略与奖励,在多类连续和离散控制问题上验证隐私保护的LLM引导策略搜索。
An Automated Georeferencing Technique for Multi-Temporal Stope Point Clouds for Downstream Geotechnical Analysis
针对地下矿山多时相采场点云需手工地理配准的问题,提出3D-TARGeT并在四次采场扫描上验证。
Simple Torque-Observation Alignment for Zero-Shot Sim-to-Real Grasping with a Direct-Drive Gripper
针对仿真与实测力矩不匹配,提出力矩观测对齐方法,并在多指直驱夹爪零样本抓取中验证。
Real-Time Force Regulation for Whole-Hand Dexterous Grasping
提出基于跟踪物体模型和本体感知的实时全手接触力调节,并在无重力仿真和27自由度臂手系统上验证。
Online Sim-to-Real Adaptation via Closed-Loop System Modeling
OSRAM通过闭环系统建模调整现有控制器参考命令,并在仿真与硬件的双足速度跟踪和loco-manipulation中验证。
Tactile Sensing Array for Multi-Phalanx Sensing in Humanoid Hands
针对仿人手全手指触觉缺失,提出Velostat与导电胶带低成本阵列,并在加载、按压释放和抓握接触中验证。
Self-Supervised Anchoring of Fingertip Sensing to Proprioception and Proactive Actions for Robot Imitation Learning
研究将指尖触觉与接近传感融入模仿学习,提出PROPRA预训练,并在真实操作任务上验证提升成功率。
Self-Adaptive VLA for Robust Robot Deployment
针对VLA在部署时硬件偏移下易失效的问题,Self-Adaptive VLA用自身轨迹上下文调制策略,并在四个精密操作任务上验证。
AdaHVLA: Adaptive Harnesses for Long-Horizon Vision-Language-Action Execution
AdaHVLA通过机器人经验自适应修订代码化协调策略,在仿真与真机部署中提升长程VLA执行。
CrossSafe: Towards Cross-Embodiment Latent Safety Filters
CrossSafe用形态感知潜表示在潜空间进行Hamilton-Jacobi可达性安全过滤,并在五种双臂形态和五个操作任务上验证。
DA-GRD: Decision-Aware Grasp-Relevant Disambiguation for tactile recovery under perception-to-execution mismatches
针对视觉抓取因物体移动而失效的问题,DA-GRD用稀疏触觉探测维护平面信念,并在MuJoCo和真实物体上验证。
DAWN: Noise-Robust Quadruped Parkour via Depth-Denoising World Models
为提升视觉腿足运动的深度噪声鲁棒性,DAWN将去噪与对比对齐融入世界模型,并在Unitree Go1跑酷上验证。
HuGo: LLMs as Whole-Body Policy Code Designers for Humanoid Loco-Manipulation
HuGo用LLM在冻结低层全身策略上生成并迭代高层代码,面向人形移动操作,在仿真任务与硬件迁移中验证。
OREN-X: Octree Residual Network for Real-Time Multi-Modal Mapping
OREN-X用八叉树共享多模态场,统一几何、辐射与视觉语言在线建图,并在Replica上验证实时性与精度提升。
PolyUMI: Accessible Visual-Tactile-Audio Data Collection for Object Inference and Manipulation
PolyUMI通过开源无线手持夹爪采集同步视觉、触觉、音频与本体数据,并用VisTA在物体推断、滑移控制和富接触操作中验证。
Sim-to-Real Aware End-to-End Learning Environment for Micromobility
针对微出行车辆仿真器难捕捉特定运动学的问题,构建面向WHILL Model CR的Sim-to-Real端到端学习环境,并在仿真避障与真机走廊中验证。
TactileStep: Sole Tactile Learning for Regulating Foot-Terrain Interaction in Humanoid Locomotion
TactileStep通过对齐足底压力仿真与真实鞋垫并用阶段感知奖励,在仿真和Unitree G1多地形上改善落脚与支撑。
Underwater C3-JEPA: An Object-Centric Cross-View World Model for ROV Salvage
面向无接触传感器的近场重载 ROV 打捞,提出多视角预测世界模型,并在实验和真实水下视频上验证。
Safety-Filtered Distributed Koopman-MPC
针对DMPC丢包会同时丢失预测与避碰约束的问题,提出Koopman-MPC与局部感知QP安全投影分离的方法,并在仓储多机器人仿真等测试中验证。
Uncertainty-Gated Exploration Noise Suppresses Task Collapse in Online RL Fine-Tuning of a Flow-Matching Vision-Language-Action Policy
研究SmolVLA在LIBERO-10在线PPO微调中的任务坍塌,提出不确定性门控探索噪声并对比验证。
From LiDAR Maps to Visual Localization: Unified Visual Association for Robust Point-Line-Plane Pose Estimation
提出将LiDAR地图渲染为准图像的统一定位框架,在EuRoC MAV和自采真实序列验证全局定位与6-DoF跟踪。
Automotive mmWave Spinning Radar Place Recognition with Spatially Gated Feature-Correlation Representation
针对旋转雷达地点识别中的航向变化与特征关系丢失,SGCA-Net用空间门控相关聚合,在MulRan和HeRCULES上验证。
Generalizable Robotic Insertion with World Models
该框架用结合本体感知与腕部相机视觉的世界模型解决多零件插入泛化,并在多种插入任务和未知几何物体上验证。
An Analysis of Streaming Deep Reinforcement Learning for Adaptive Continual Learning in Robotics
研究证实流式深度强化学习可使机器人在预训练后通过实时数据流适应本体、环境及目标变化。四足运动任务成功率较预训练策略提升90%,优于批次在线方法;机械臂操作验证了该框架跨形态迁移潜力,但存在稳定性局限。
Safety-Critical Control for Smoothed Implicit Contact Dynamics
针对平滑隐式接触动力学中安全滤波设计困难,提出基于离散时间CBF、κ筛选与鲁棒收紧的框架,并在四个富接触系统仿真验证。
Spatial and Semantic Reasoning for LLM-Driven Robot Navigation via MCP
针对LLM接入ROS导航的表示与复用难题,提出经MCP暴露的导航表示层,并在模拟室内三类任务中验证。
Omnidirectional Amphibious Locomotion via Internal Mass Actuation
提出MARBLE,通过三轴内部滑块重分配质量与姿态感知控制,在陆地、水面和陆水过渡中验证全向两栖运动。
A Sample-Based Approach for Hierarchical Information-Theoretic Compression of Probabilistic Occupancy Grids
针对大规模概率占据栅格压缩计算开销高,提出受 MCTS 启发的采样式分层多分辨率表示,并在真实大规模栅格上验证。
A Quasi-Direct-Drive Underactuated Asymmetric Hand for Dexterous and Efficient Grasping and Manipulation
提出 Berkeley QUAD Hand,通过 QDD 与非对称欠驱设计,在硬件评估中验证灵巧高效抓取与操作。
Motoneuron-Inspired Sampling for Model Predictive Path Integral Control
针对 MPPI 有限 rollout 下采样分布影响性能的问题,提出运动神经元启发的 Spike-MPPI,并在 MuJoCo Ant 模型上验证。
Amplify: A Lightweight Library for Reproducible Nonlinear Programming Problems in Robotics
提出轻量级非线性规划库 Amplify,用于机器人轨迹优化可复现,并在多领域基准优化问题上比较验证。
Behaviora - A Conceptual Architecture for External and Internal Behavior of Robots and Agents
Behaviora用可寻址行为片段、风格与经验配置表示机器人和智能体内外行为,并在原始触碰手臂模型中展示。
DAVIO: Dense Monocular-Inertial SLAM with Feed-Forward Initialization and Pose-Conditioned Mapping
DAVIO面向单目-惯性度量定位与稠密建图,借助Depth Anything 3完成启动和位姿条件建图,并在EuRoC与ORI序列验证。
EBRL: Asynchronous Embodied RL by Multi-Grained Resource Management
EBRL面向具身RL训练资源浪费问题,以异步流水调度和细粒度资源管理提升仿真基准上的训练效率。
FlyCNS: Connectome-Grounded Information Organization for Communication-Constrained Embodied Control
FlyCNS借鉴果蝇脑—神经索连接组组织局部计算与选择性通信,并在Unitree Go1仿真中验证受限通信下的全身协调控制。
ForgetMimic: Motion Unlearning for Reinforcement Learning Humanoid Control
针对人形机器人策略中特定动作难以移除的问题,ForgetMimic以运动级遗忘方法在Unitree G1和H2的12种动作上验证。
GLoTouch: Global-to-Local Haptic Perception Using a Parallel Gripper for Object Search, Recognition, and Grasping Without External Vision
GLoTouch用平行夹爪的全局到局部触觉框架,在仿真和真机中验证无外部视觉的目标搜索、识别与抓取。
InternW0: A Foundational Physical World Model for Efficient Real-World Interactions
InternW0通过全模态接口、异步多频处理和局部物理建模,联合学习视觉动态与机器人控制,并在仿真基准和真实科学任务中验证。
Kairos: Grounded Forecasting of Presence and Directional Flow in 4D Scene Graphs
Kairos用预测性方向流记忆扩展3DSG为4DSG,在三类真实行人环境和规划任务中预测人在未来时刻的存在与运动方向。
LiMA: Bridging Long-term Imagination to Real-time Dexterous Manipulation via Asynchronous Diffusion
LiMA通过异步双系统生成框架解耦意图规划与反应执行,在六个双手灵巧操作任务上验证降低延迟并提升成功率。
RegenHarness: A Robot Agent Harness with Evidence-Gated Recursive Self-Improvement
RegenHarness通过证据门控执行架构连接任务规划与异构技能,并在真实四足仓库任务和独立回路中验证。
Talk2Escape: Conversational Grounding for Vision-and-Language Navigation
为解决VLN开环易累积偏差失效,Talk2Escape以监测运动触发对话纠错,在仿真与真机上验证。
TANDEM: Task and Motion Planning with As-Needed Demonstrations for Efficient Vision-Language-Action Model Fine-tuning
针对长程操作数据采集瓶颈,TANDEM框架结合任务运动规划与按需遥操作,利用VLM动态扩展规划域。同等人工干预下数据量提升2.9倍,仅20条演示即把π_{0.5}-DROID模型在五类任务平均成功率从0%提至60%。
Humanoid Locomotion with a Fly-Inspired Recurrent Controller
研究用果蝇启发循环控制器驱动仿真Unitree G1,在多地形、速度和初始偏航条件下验证其行走行为。
Layered Safety: Enhancing Autonomous Collision Avoidance via Multistage CBF Safety Filters
提出基于局部感知点云、PSF与多阶段CBF安全滤波的动态避碰框架,并在多个足式机器人平台的真实动态场景中验证。
Affordance-based robot manipulation with flow matching
提出基于可供性与flow matching的辅助机器人操作框架,并在含10个任务的真实世界数据集上验证。
Visual swarm navigation via deep reinforcement learning and evolutionary hybrid design
提出结合多智能体强化学习与神经进化的混合方法,在高保真仿真中合成并验证单目视觉群体导航控制器。
Predict Before You Step: Auditable Occupancy Forecasting for Dynamic Obstacle Avoidance under Sparse Guidance
面向稀疏路标引导下的动态避障,LOOP用递归占用预测连接引导与运动控制,并在Isaac Lab和Unitree Go2上验证。
Relative Contact Velocity-Controlled Hand-Object Mechanism for Dexterous Tool Manipulation
该工作将手与工具建模为统一HOM,以相对接触速度进行规划和估计,并在仿真遥操作五种机器人手完成工具操作流程。
Generalists Act, Specialists Intervene: Modular Stage-Selective Reinforcement Learning for Vision-Language-Action Manipulation
针对多阶段操作精密阶段VLA表现不足,RouteRLT用阶段感知协调对接VLA与RL专家,并在LIBERO系列和真实连接器任务验证。
Deploying Foundation Models for Embodied Navigation
针对基础模型具身导航中的个性化不足与上下文受限,提出TAP和MemCtrl,并在实验室真机及多种具身任务中验证。
CableVLA: Simulation-Privileged Global-Local Representation Learning for Cable Routing
针对线缆布线的全局拓扑与局部接触协同控制,CableVLA用仿真特权监督学习拓扑和触觉表征,并在MuJoCo等评估中验证。
The Cartesian Hand: In-Hand Manipulation with All-Linear Fingers
提出Cartesian Hand,以全线性7自由度末端执行器实现手内操作,并在35个跨场景物体及人形机器人上验证。
Dr-LiSA: Direct Radar-Lidar Scan Alignment for SE(3) Localization
Dr-LiSA用学习前向模型从激光雷达子图预测雷达观测,实现2D旋转雷达在3D激光雷达地图中的SE(3)定位,并在道路数据上验证。
PLAT: Sparse Timed Keyframe Motion Tracking for Humanoid Control via Privileged Latent Transition Learning
针对稠密逐帧参考限制人形高层控制的问题,PLAT用特权潜变量转移学习稀疏定时关键帧跟踪,并在仿真和Unitree G1上验证。
SG-CPG: Severity-Gated Central Pattern Generators for Adaptive Quadruped Locomotion under Continuous Actuator Degradation
针对执行器连续退化问题,SG-CPG通过残差与幅值双门控机制重构健康CPG策略。Unitree Go2实测显示,该算法在93%小腿扭矩损失下完成28/29次运动试验,仿真中95%强度损失时指令跟踪误差低于8%。
VisForce: Visual Grounding of Current and Desired Forces for Goal-Conditioned Dexterous Manipulation
针对灵巧手中力与视觉位置难对应的问题,VisForce以视觉力提示和目标条件交叉注意生成动作,并在真机多任务上验证。
Brace Yourself: Task-Conditioned Environmental Bracing for Forceful Humanoid Manipulation
针对人形机器人强力操作易扰动平衡,SHS用单手环境支撑引导双强化学习策略,并在Unitree G1上验证。
When Does Touch Matter? Charting the Vision-Interaction Gap in Cluttered Dexterous Grasping
在LEAP Hand真实桌面杂乱抓取中,控制比较视觉、wrench与taxel模仿学习扩散策略,验证交互感知的作用。
Learning tactile perception from high-bandwidth single-point sensing
SpectRobot将单点触觉信号转为时频谱图并接入视觉学习管线,在机器人遮挡操控及多类触觉技术上验证。
Phrase-Level Robotic Guqin Performance: Bimanual Motion Planning and Audio-Tactile Interaction Monitoring
提出异构双臂机器人古琴短语级演奏系统,用层级规划与音触觉反馈在实体古琴上验证。
A latency-aware framework for visuomotor policy learning on industrial robots
针对工业机械臂观测—执行延迟导致的部署问题,提出延迟感知系统框架,并在接触丰富装配任务上验证。
Smoothness as a Constraint for Stable Humanoid Locomotion
针对人形机器人全身控制平滑性与任务响应冲突,DeCap以分组物理约束实现平滑控制,并在真机全身控制任务上验证。
Odometry-Aided Real-Time Mapping for Underwater Robots Using Forward-Looking Sonar
面向水下低能见度中的FLS实时建图难题,提出级联特征重建与姿态感知投影,在3 m×5 m水池验证2.5D局部建图。
Steerable and Reactive Grasping Through Modular Design with a Three-Point Interface
该框架用三点接口连接几何推理、反应式控制与RL局部反馈,在仿真和硬件演示中验证灵巧抓取。
Dexterous Robot Manipulation from Human Demonstrations via Contact-Anchored Retargeting and Residual Policy Learning
针对人类示教缺少接触力的数据瓶颈,提出接触锚定重定向与残差策略学习,并在仿真重建、机器人手迁移和真机双手任务上验证。
DexTacWAM: A Visuo-Tactile World-Action Model for Dexterous Manipulation
DexTacWAM将指尖触觉潜变量注入视频扩散世界模型,在六个接触丰富的灵巧操作任务上验证并优于基线。
GraspTune: Tactile-Driven Execution Refinement for Robust Grasping
GraspTune用触觉驱动的有界残差TCP运动细化视觉抓取提案,并在仿真和UR5e真机上验证稳抓提升。
LIBERO-VPro: Benchmarking Closed-Loop Visual Robustness of Robotic Foundation Models
针对机器人基础模型视觉鲁棒性评估缺失,LIBERO-VPro构建含4维度12类挑战的基准。经19.6万次仿真及200次Franka Research 3真机验证,揭示模型在交互线索中断或空间先验违背时性能骤降,为VLA与WAM架构提供差异化诊断框架。
MimicAgent: Quadruped Skills via Prompt-to-Trajectory Generation
MimicAgent将技能提示转为四足参考轨迹,用示例引导RL训练动态技能策略,并在仿真与真实世界部署验证。
PredActor: Predictive Action Diffusion for Steerable Onboard Humanoid Control
PredActor用本体感知联合预测动作与内部未来状态,实现可引导人形闭环控制,并在仿真和Unitree G1硬件上验证。
TACIT: Tactile Contact Supervision for Spatial Attention in Dexterous Manipulation
TACIT利用遥操作示教中的触觉接触监督空间注意力,并在真实机器人球放置和插销插入等基准上验证少样本操作表现。
Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Tactile-JEPA利用传感器连接图进行拓扑感知自监督预训练,并在三个触觉数据集上验证下游效果。
Touch2Robot: Robot Touch in the Human Demonstration Loop
Touch2Robot将目标机器人手接触可视化纳入人类示教,并在四个真实世界任务上验证提升灵巧数据采集质量与效率。
ZVeC: A Zero-Shot Framework for Instance-Level Vehicle Extraction and Generative Point Cloud Completion
ZVeC将地下场景点云补全分解为车辆实例重建,用条件扩散模型零样本补全,并在真实地下停车LiDAR基准验证。
From Biological Precursors to Artificial Cognition: Consciousness, Embodiment, and the MEM Architecture
文章探讨AI意识归因条件,比较LLM、h-LLM、VLA和具身智能与MEM,提出可在人类、无脊椎动物和人工系统中检验的框架。
Receding-Horizon Pushing with Composable Object-Centric Policies
针对任意形状3D物体长时域推动,提出物体中心分层反馈策略,并在仿真与真机上验证。
Manipulation Feasible Navigation Among Movable Obstacles with Discrete Contact Pushing
提出分层NAMO框架,结合重定位规划、LLM依赖推断与离散接触推动,在仿真和真机验证大型不可抓障碍交互导航。
BiView-Touch: Learning Bimanual Tactile Representations by Cross-Hand Completion
BiView-Touch用跨手潜变量补全学习双手触觉表征,并在HumanTouch与BVT-20上验证低标注和迁移表现。
ContactDP: Contact-Guided Diffusion Policy for Tight Insertion Tasks
针对高精度连接器插入中的接触不确定性,ContactDP融合视觉、触觉与力矩信息,并在工业级连接器任务上验证。
Grounded Action Model: 3D Grounding as a Foundation for Robotics
提出Grounded Action Model(GAM)范式,通过3D接地构建物体中心表征解决VLA隐式学习痛点。在RoboTwin 2.0及LIBERO-PRO刷新SOTA,真机双机械臂视觉偏移下成功率达85%,结合Molmo2规划器实现64.7%长程任务完成率。
HapticWAM: Distilling Imagined Touch into a World-Action Model without Inference-Time Tactile Sensing
HapticWAM通过异构触觉编码、结构化接触预测与师生蒸馏,解决部署时无指尖触觉的富接触操作,并在真实三项拾放任务验证。
RopeFormer: Cross-Trial Adaptation from Interaction History for Dynamic Rope Manipulation
RopeFormer用跨试次交互历史作为控制上下文,在仿真绳索任务和Unitree H1-2真机未知绳索上验证动态绳索操控。
STRIDER: Stepping-Enabled Multi-Gait Hierarchical 3D Loco-Manipulation Framework for Humanoid Robots
STRIDER面向人形移动操作中足点调控与全身操作融合问题,以分层多步态与LD-PPO蒸馏方法在仿真和TianGong Omni真机验证。
UniPoint: Unified Point-Level Sensor Fusion for Humanoid Locomotion Across Challenging Terrains
UniPoint通过多源点级融合LiDAR与深度相机,训练单一全身运动策略,并在DR02真实多地形上验证。
Distributed ISAC-Enabled Multimodal Recovery of Missing 2-D LiDAR Measurements
针对二维LiDAR扫描缺失区域恢复,提出分布式ISAC框架融合60-GHz波束训练与LiDAR,并在室内测量中验证。
Tip Manipulation in Soft Everting Robots via Wall Retraction and Deployable Fingers
针对软体外翻机器人尖端工具难重定位的问题,提出壁面回缩与充气手指方案,并在抓取、堆叠、检查和投送中验证。
A Reconfigurable Dual-Opposition Architecture for Single-Hand Assembly and Manipulation
提出可重构双对向手部架构,通过两组虚拟指对向与可重构掌部,在仿真和硬件中验证单手装配与操作。
StateMem: Single-State Residual Memory with Adaptive Inference for Vision-Language-Action Policies
StateMem通过单状态残差记忆和自适应前缀路由提升VLA历史信息保留,并在LIBERO、RoboMemArena及真机操作中验证。
Whole-Body UMI: Transferring UMI Manipulation Skills to Humanoid Whole-Body Manipulation via Real-Time Motion Generation
提出 WB-UMI,以端执行器条件实时运动生成,将 UMI 技能迁移到 G1 全身操作并在四项真机任务验证。
Beyond Kinematics: Benchmarking Simulation Fidelity for Muscle-Driven Imitation Learning
比较SCONE/HyFyDy与MuJoCo/MyoSim两条MIRL流水线,在人类动捕和EMG上评估运动学与肌肉激活保真度。
Learning Distance-Conditioned Object Transport for Humanoid Loco-Manipulation from a Single Motion Clip
针对单一参考难控制运输终止距离,提出DCRR重组监督,并在四类交互、仿真迁移和硬件上验证。
From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
针对长时程操作中预训练策略卡在关键子任务的问题,PARTS用真实世界子任务RL微调,并在双臂YAM和单臂Franka任务上验证。
Visual Navigation Transformer with Pose Attention
为复用早期遍历经验,VNT-PA以相机位姿索引深度关键帧并用位姿差注意力,在HM3D点目标导航验证。
Think Locally, Refine Globally for Memory-Efficient 3D Reconstruction
LoG-VGGT面向长序列3D重建,结合跨窗口注意力与全局相机一致性优化,在多个长序列基准上验证深度与位姿表现。
Robust Structureless Monocular Visual Inertial Initialization Exploiting Line Features and Vanishing Points
SLIM-init利用二维线特征与消失点约束单目VIO初始化,并在公开基准和退化运动序列上验证。
Potential-Field Action Representation for Reinforcement Learning in Contact-Rich Manipulation
PA-RL用人工势场动作表示减轻富接触操作强化学习的低层运动负担,并在仿真与真机插孔中验证。
Learning Terrain-Aware Whole-Body Control for Perceptive Legged Loco-Manipulation
针对全身控制缺乏地形外感知的问题,提出TA-WBC强化学习统一策略,并在仿真和真实实验中验证。
Whisker-based tactile flight for tiny drones
为增强微型无人机受限感知,提出轻量触须触觉装置,并在刚性与柔性环境中验证自主避障、贴面与狭窄空间探索。
Anti-Gravity Walking by a Flying Humanoid Robot via Thrust-Rate Input Whole-Body Model Predictive Control
针对反重力环境行走中的接触切换不稳定,提出推力率输入全身MPC,并在仿真和硬件实验中验证。
Layered e-skin for Shear Sensing
面向机器人指尖剪切感知,提出双层FSR阵列结合物理模型与CNN-GRU,并在机器人操作实验中验证三轴力、接触运动和滑移检测。
AtomEgo: Exploring Ego-Robot Integration for Embodied Foundation Model Pretraining
针对机器人示范规模与多样性受限,AtomEgo通过自我中心数据与机器人协同预训练,在多任务真机和跨具身表征分析中验证。
Civil: causal and intuitive visual imitation learning
提出CIVIL,让人类用标记和语言说明任务相关特征,在仿真与真实实验中改进视觉模仿学习。
FootQuery: Future-Touchdown-Guided Retrieval from Depth History for Perceptive Humanoid Locomotion
FootQuery按预测足端触地点检索历史深度并融合视觉记忆,在仿真复杂地形和Unitree G1真实路线验证人形感知运动。
FRAMES: Failure Recovery And Monitoring of Embodied Skills for Humanoid Loco-Manipulation
FRAMES面向人形移动操作执行失败,用VLM监控与恢复监督技能,并在MuJoCo五任务试验验证监控模块。
GEM-MPC: Balancing Exploration and Exploitation through Expert-Guided Planning
GEM-MPC针对高维连续控制探索难题,结合MPPI规划、克隆规划器策略与KL正则探索策略,并在连续控制基准上验证优于规划式基线。
HumanoidTTT: Test-Time Capability Reuse for Efficient Humanoid Control
HumanoidTTT面向持续人形控制,测试时复用经验证完整动作,并在实验中验证效率与安全性。
ME-Dex 1.0: Bringing Heterogeneous Tactile Sensing into World Action Modeling
ME-Dex-1.0将异构触觉与视觉、动作联合建模,基于Mixture-of-Transformers和数据引擎,在仿真与真机操纵中验证。
NaViRrator: Robot Navigation from Human-Readable Maps through a Learned Visual Route
NaViRRator将人类可读地图上的起终点转为VLN指令,借学习路线脚手架连接地图与自视角观测,并在真实世界实验验证。
NeuRIO: A Streaming Neural Estimator for Zero-Shot Sim-to-Real Multi-Robot Relative Inertial Odometry
NeuRIO用图网络融合机器人间方位、距离和IMU,实现无锚6-DoF相对惯性里程计,并在真实序列和仿真规模测试中验证。
RAYA: Learning Where and When to Intervene for Robot Recovery
RAYA将学习的有限时域可恢复性裕度和权重调度嵌入最优控制器,并在四旋翼与自动车仿真及Crazyflie真机上验证。
SABER: Learning Attention-based Semantic Affordance for Legged Locomotion
SABER针对腿式机器人不当接触风险,用地形可供性图和语义偏置注意力在Unitree B2上验证。
SFVO: Decoupled Confidence-Guided Stereo-Flow Visual Odometry with Bidirectional PnP
SFVO利用预训练立体匹配与光流,将对应关系转为几何约束,在室内外数据集验证稳健准确位姿估计。
Touvigation: Embodied Adaptive Object Acquisition for Blind and Low-Vision Users in Unfamiliar Indoor Environments
Touvigation结合视觉语言理解与持续局部空间建模,为陌生室内物体获取提供低延迟身体相对引导,并在用户实验中验证。
Learning Scene-Aware Humanoid Locomotion through 3D Clutter from Immersive Human Demonstrations
MTC通过VR示范采集与场景感知重定向学习人形机器人避障运动,并在Unitree G1和MTC-Challenge上验证。
Visual Sim-to-Real Learning for Robotic Insertion under Geometric Variations: Application to Rebar Installation
针对几何变化下钢筋插入需反复采集真机数据的问题,RebarSim全仿真训练并在真机零样本验证。
Towards Effective Visual-Inertial SLAM with Passive-Only Sensors for Low-Cost Autonomous Underwater Vehicles
面向低成本AUV水下VI-SLAM,评估现成SLAM并优化传感器融合,在非受限6-DOF水下环境验证。
Learning Slope-Adaptive Whole-Body Locomotion for Humanoid Robots in Roofing Construction
针对坡屋面施工中的全身运动学习,提出任务语义、场景锚定框架,并在Unitree G1的跟踪、跨任务和实物实验中验证。
Execution-Aware Pre-Execution Ranking for Grasp-Conditioned Robotic Placement
该工作将放置建模为预执行排序,结合点云与位姿描述符,在30物体、1235场景数据和xArm7/MoveIt迁移上验证。
General Collaborative Intelligence: Architecting Cognition for Resilient Multi-Agent Ecosystems
针对现有综述割裂问题,本文用五维分类和三项认知协同条件统一梳理多智能体无人系统协作智能。
Same World, Different Knowledge: When Isolated Audits Misjudge World-Model Repairs
论文提出信息接口审计来评估世界模型修复选择,并在仿真四旋翼模型预测控制中验证共享故障信息会改变修复优劣。
Accelerating Visual Policy Learning with Sampling-Based Model Predictive Control
针对视觉运动与操作策略学习开销大且易陷入非预期接触的问题,SGPS结合采样式MPC与一阶策略优化,并在仿真和真实Go2上验证。
Vision-Force Admittance Learning for Peg Insertion Into a Movable Hole
针对动态环境下插孔装配精度与不确定性冲突,VFAL融合视觉与力导纳模型,并在真实实验验证。
ASGARD: Action-Space Guard for UAV Resilience via Reinforcement Learning
ASGARD用教师-学生管线防御RL式UAV控制中的动作空间攻击,并在多种攻击场景中验证韧性。
DexTouch-WM: Learning Action-Conditioned Tactile World Models from Human Touch for Dexterous Robot Manipulation
DexTouch-WM用可迁移的人类触摸学习动作条件世界模型,并在人到机器人扩展和真机策略学习中验证。
ForeTac-VLA: A Forecasting-Based Tactile-Vision-Language-Action Model for Contact-Rich Robotic Manipulation
ForeTac-VLA通过预测未来触觉状态融合触觉、视觉与语言,在真实接触密集操作任务上提升动作生成鲁棒性。
GR2PO: Group Relative Return Policy Optimization for Continuous Robot Control
提出无Critic的GR2PO,通过轨迹折扣回报与组归一化优化策略,并在机器人控制仿真和边缘设备上验证。
MAPLE-RF: Efficient Probabilistic RF Source Localization in Partially Explored Environments
研究部分地图上的单快照RF发射源定位,提出MAPLE-RF以U-Net一次性评分,并在室内射线追踪仿真中验证。
OmniMimic: Dynamics-completed Motion Augmentation for Multi-style Omnidirectional Quadruped Locomotion
针对动物演示数据方向覆盖窄的痛点,OmniMimic通过动力学补全与残差专家网络,将受限演示转化为全向多步态策略。仿真显示其速度跟踪RMSE较APEX基线降低63.1%,有效解决非前向运动风格一致性问题。
REFINEPPO: Learning Continuous Control Policies by Iterative Action Refinement
该文针对连续控制策略一次性决策难以再修正的问题,提出IAR并结合PPO,在14个基准控制任务上验证。
SLAMSqueezeBench: Comparing SLAM Systems under Resource Constraints
针对SLAM基准缺少现实资源约束的问题,提出SLAMSqueezeBench,并在边缘硬件上比较九种SLAM系统。
TacSushi: Tactile-Grounded World-Action Modeling for Dexterous Sushi Manipulation
TacSushi用触觉融合与训练期未来后果预测学习寿司灵巧操作,并在真实机器人试验中验证。
TouchSight: Bare-Handed Tactile Prediction from Egocentric Video via Generative Visual Augmentation
TouchSight用单目第一视角视频与生成式裸手增强预测全手密集接触力,并在OakInk2和未见自然裸手视频上验证。
Benchmarking Visual-Inertial Odometry in Subterranean Environments Under Sensor Degradation, Miscalibration, and Dynamic Occlusion
该工作面向地下环境VIO部署失效,基于CERBERUS数据集构建压力测试基准并评测代表性系统。
From Gameplay to Policy: Towards Scalable Robot Data Collection via Gamified Robot-Free Interaction
提出VR游戏化Project Kitchen收集无硬件绑定操作数据,并用Game2Policy迁移到仿真和真机少样本策略验证。
Feedback-Modulated Harmonic Policies for Quadruped Locomotion
研究提出反馈调制谐波策略,将关节轨迹表示为指令条件傅里叶级数并在线修正。Unitree Go2实测峰值速度达3.67m/s,负载5.883kg,验证了显式频率结构在四足高速 locomotion 中的有效性。
Nonlinear spectral modeling and control of soft-robotic muscles from data
针对电液软人工肌肉非线性、记忆与滞后难控问题,基于谱子流形从受迫响应学习降阶模型,并在对抗式电液离合关节实时控制中验证。
Active perception for robotic harvesting: 3D reconstruction and localisation of tomatoes hidden within clusters in a Mediterranean greenhouse
针对温室簇生番茄遮挡难题,提出基于NBV主动感知的3D重建与定位流程,并在经真实条件验证的仿真中评估。
Learning Holistic Whole-Body Loco-Manipulation with a Bipedal Mobile Manipulator
该工作用强化学习训练统一全身控制器,将6-DoF末端目标映射为臂腿协同动作,并在真机多种命令来源下验证。
Grasping by interconnection: robust closing motions from coarse object templates
面向仅有近似形状、尺寸和位姿的物体,提出基于粗模板与顺应滑动接触的闭合规划器,并在Shadow Dexterous Hand上验证。
Gated Residual Body-Hand Coordination for Whole-Body Humanoid Teleoperation
针对人形遥操作中身体与手部命令失配,提出门控残差协调,在仿真GRAB与AMASS动作上验证。
ElastiQP: An Always-Feasible QP Solver for Constrained Robot Control
ElastiQP通过带精确逐约束l1惩罚的改进对偶主动集QP求解器,解决约束冲突下控制无解问题,并在机器人控制基准上验证。
KINO: A Keyframe Interface for VLM Planning and Whole-Body Control in Humanoid Loco-Manipulation
提出以运动关键帧连接 VLM 规划与 RL 全身控制,并在仿真和 Unitree G1 上验证物体操作任务。
LUMO: Designing Luminous Contact Morphology for Repeatable Whole-Finger Contact Observation
LUMO用LED照明可变形硅胶垫观测手指接触位置,结合仿真优化,并在压入与双指抓取中验证。
ReRadar: Robust Radar Global Localization via Rotation-Equivariant Descriptor Learning
ReRadar针对扫描毫米波雷达全局定位,学习旋转等变特征与不变描述子,并在多个数据库-查询评测上验证。
SEAM: Submap-Anchored Evidence for Lifelong LiDAR Mapping under Trajectory Deformation
SEAM用子地图级锚点优化轨迹生成证据,进行动态物体移除和变化检测,并在真实施工现场与长期多会话数据集验证。
TacBPM: A Tactile-conditioned Behavior Prior Model for Dexterous Reorientation
TacBPM用触觉条件行为先验复用潜在控制,在灵巧重定向、轴旋转和臂手任务中验证加速训练与稳定性。
WeaveRL: Weaving Reconstruction into Scene-Aware Fabrics for Perceptive Reinforcement Learning
WeaveRL用GPU并行在线重建surfel场景,使策略基于传感几何学习,并在碰撞密集操纵任务上验证。
WholeBodyWAM: Learning Whole-Body World Action Models with Scalable Motion Priors
WholeBodyWAM利用异构大规模运动预训练全身运动先验,并在真实世界类人操作中验证可提升预测、任务表现和数据效率。
Artificial Intelligence-Enabled Space Robot Operations: Technologies, Challenges and Prospects
本文综述AI赋能空间机器人操作,构建三层技术框架,并围绕场景、约束、能力形成与部署演化展开分析。
Fingers as Legs: Learning Self-Supported Locomotion and Manipulation with an Anthropomorphic Hand
该研究用强化学习让仿人手以手指同时支撑、移动和交互,并在仿真与硬件上验证。
Online Geometric Change Detection via Scene Decomposition
提出CDSD框架,用场景分解与子地图比较实现LiDAR或RGB-D在线几何变化检测,并在自采和开源数据集上验证。
Calibrate Once, Fly Any Team: Residual-Grounded Low-Fidelity Training for Cooperative Drone Swarms
针对高保真多无人机强化学习代价高的问题,提出残差校正低保真训练,并在多项协作无人机仿真任务上验证。
Residual Fault Adaptation for Dexterous In-Hand Manipulation Under Runtime Joint Faults
针对运行时关节故障扰乱灵巧手手内操作,提出RFA残差自适应框架,并在仿真和真机软件注入故障中验证。
Embedding Physics Priors in Robot Learning: A Survey
本文针对物理嵌入机器人学习文献碎片化问题,提出统一分类并综述多类先验、应用、模型及开源生态。
GeoLAM: Learning Geometry-Grounded Latent Actions from Unlabeled Human Videos
GeoLAM用冻结几何特征层级和训练期4D几何教师,从无动作标签人类视频学习潜动作,并在基准与机器人操作任务上验证。
HuMemSLAM: Efficient Human-Inspired Semantic Place Recognition for Robust Visual SLAM
面向视觉SLAM地点识别的鲁棒与低延迟需求,提出受人类记忆启发的HuMem-VPR并集成ORB-SLAM3,在真实图像、CARLA和在线实验中验证。
IL-ACT: Imitation Learning with Adaptive Cartesian Tracking Control for a 30-ton Excavator
面向受耦合运动学、执行滞后和不确定性影响的自主挖掘机控制,提出IL-ACT并在Simscape中验证。
Intrinsic Robot Rewarding: Reusing VLA Representations for Autonomous Evaluation and Policy Improvement
IRR面向机器人自主评估与策略改进,复用VLA视觉编码器和成功示范终点形成奖励,并以COMAU Racer 3实验室演示器为基础。
LEAP: Learning Emergent Active Perception for Quadruped Navigation
LEAP针对危险地形中需视觉发现目标的导航,通过自我中心信念地图学习主动感知,并在留出场景和物理仿真四足运动中验证。
LiLi: Lie Theory Based 3D LiDAR Scan Alignment Degeneracy Detection
LiLi用李理论识别SE(3)中的退化变换,在合成数据和真实退化数据上提升3D LiDAR配准与里程计定位。
NeuroSymbEAD: A Large Scale Neuro-Symbolic Caption Dataset for Omni-Directional Embodied Autonomous Driving
NeuroSymbEAD在KITTI-360上以自车知识图生成多层文本标注,验证交通场景解释与3D推理基准。
ProxiDex: Learning Dynamics-Guided Proximity Policy for Dexterous Manipulation
ProxiDex将手物接近性作为交互状态,通过动力学引导策略,在仿真和真实灵巧操作中提升成功率与鲁棒性。
TIO-Former: Ultra-Lightweight 6-Directional ToF-Inertial Odometry for Nano-UAVs via a Streaming Causal Transformer
TIO-FORMER面向SWaP-C受限的nano-UAV自运动估计,融合六向ToF与IMU,并在真实飞行和边缘RISC-V上验证。
UniDex-ViTac: Learning Unified Visuo-Tactile Dexterous Manipulation Policy from Human Video Data
UniDex-ViTac用人类视频引导仿真生成带触觉观测的机器人示范,并在仿真和真机物体操作中验证统一策略。
Weave: Learning Whole-Body Dexterous Loco-Manipulation from Human-Object Interactions
Weave通过接触感知重定向、接近运动补全和几何感知策略,从捕获的人-物交互学习全身灵巧类人交互,并在九个物体上验证。
Collision-Aware Humanoid Whole-Body Control under Imperfect Tracking Targets
针对不完美目标可能导致碰撞的问题,提出RECAL以场景几何增强盲WBC,并在仿真和真实Digit V3上验证。
Understanding User Preferences of a Slope-Aware Variable-Admittance Filter for a Robot Guide Dog
研究坡度感知可变导纳滤波器参数如何影响机器人导盲犬力交互中的用户偏好,并在仿真和人体实验中验证。
Bench2Dex: Benchmarking Visuo-Tactile Bimanual Dexterous Manipulation Across Dexterous Hands
Bench2Dex用统一仿真触觉接口,在12种灵巧手的26个双手任务上评测视觉-触觉学习方法。
HydroMap: Probabilistic Water Surface Elevation Mapping for Semantic Scene Representation in Inland Waterways
HydroMap用立体视觉重建并融合水面高程,在内河数据集上验证可补全LiDAR地图缺失的水面表示。
PredTac: Learning Contact-Rich Manipulation with Predicted Touch
PredTac从因果视觉与机器人状态预测触觉,用作策略接口,并在仿真和真机三项富接触任务中验证。
SlipSense: Multimodal Tactile Learning for Low-Latency and Generalized Slip Detection
SlipSense用压阻阵列与加速度计多模态融合,实现低延迟滑移检测,并在37物体数据集和跨平台迁移中验证。
SURE-Map: Self-Correcting Streaming Geometric Foundation Models
SURE-Map通过跨视角几何不确定性与多时间尺度自校正,解决流式重建误差累积,并在长时程基准验证。
Touch2Trace: Tactile-Driven Imitation Learning for Dexterous Cable Tracing
Touch2Trace用触觉编码器与轻量Transformer模仿学习解决灵巧线缆追踪,并在Tesollo DG-5F真手上验证。
XRoboToolKit-T: Teleoperation with High Stability and Precision with Tactile Sensing for Contact-rich Manipulation
提出XRoboToolKit-T,通过触觉感知力控制与触觉辅助实现高频稳定遥操作,并在接触密集操作任务上验证。
Beyond Dead Reckoning: A Point of View on Camera--DAS--GNSS Continuity in Road Tunnels
针对道路隧道卫星不可见下的连续定位需求,提出相机-DAS-GNSS跨模态轨迹连续思路,并面向隧道定位连续性制定验证议程。
Skill Composition for Legged Robot Reinforcement Learning
本文聚焦腿式机器人强化学习中专用技能间脆弱切换,主张研究独立子策略的可靠组合,摘要未报告实验验证。
Embracing Flow Unsteadiness: A High-Throughput Learning Platform Enables Vortex-Exploiting Bioinspired Propulsion
REEF结合高通量真实流固交互平台与分阶段学习算法,在三类推进器和自由运动机器人上验证非定常涡利用。
World-Action Models for Robot Learning and Control: A Survey
本文综述面向机器人的 WAM,将未来世界预测与可执行动作生成结合,并在操作、导航和自动驾驶应用中梳理评测。
NavPatch: Evidence-Guided Object-Level Costmap Correction with Vision-Language Models
针对几何地图障碍表示与导航需求不匹配,NavPatch 用 VLM 进行对象级代价地图校正,并在五种布局的真机试验中验证。
VGFM: Expressive Robot Policies via Dense Value Guidance in Flow Matching
VGFM在基于Flow Matching的离线RL策略中加入稠密价值引导,并在OGBench运动和操作任务上验证长时程目标控制。
VLBiMan++: Expanding the Generalization Boundary of Vision-Language Anchored One-Shot Bimanual Manipulation
VLBiMan++从单次人类示范分解并自适应迁移技能,在真实双臂操作中验证跨任务、物体、场景、平台与部署条件的泛化。
Learning In-Hand Object Reaching to General 6D Poses
针对手内操作需同时控制位置与姿态,提出 POISE 仿真到现实强化学习框架,并在仿真和真机上验证。
JumpStart Your Policy Learning with Lessons from 160,000 Training Runs
为提升离线策略学习可靠性,研究通过16万余次策略训练系统分析算法、调参与基准影响,并在114个数据集上验证。
GIFT: Glove-Inferred Force Transfer: Force-Aware Human-to-Robot Skill Transfer from a Wearable Sensing Glove to a Robot Hand Without Tactile Sensors
GIFT用手套测力与机器人电流残差估力,在杯子抓握保持任务上验证无触觉机器人手的力感知技能迁移。
From Transportation to Manipulation: Enabling Grasping in Magnetic Robotics
为拓展MagLev系统从运输到抓取操作,提出带1-DoF夹爪的低成本并联6-DoF Gripper MagBot,并在仿真和真机取放中验证。
Parameter Sensitivity Analysis for Aerial LiDAR-Inertial Odometries in low-altitude flights
针对低空无人机LIO参数调优困难,本文用网格搜索、相关性与随机森林分析,在多LiDAR低至中等高度飞行数据集上验证。
Global Path Planner with Multi-Model Switching
该工作面向复杂地形全局路径规划,结合可通行性图、Heading-Aware A*与多模型Pure Pursuit,并在仿真平台上验证。
Understanding Whole-Body Robot Teleoperation Strategies Under Diverse Task Objectives and Constraints
研究全身机器人遥操作控制策略,提出混合控制框架,并在TIAGo用户研究中验证不同任务约束下的效果。
Constraint-Grounded Reinforcement Learning for Variable Impedance Control in Contact-Rich Robotic Insertion
为免除不确定接触插入中的手动重调,CG-RL按力限和接触反馈在线调增益,并在仿真斜插入中验证。
World Models for Embodied Intelligence: From Plausible to Controllable to Actionable
本文针对具身智能世界模型如何改善行为的问题,提出三级能力框架和3x4分析矩阵,并在多类具身任务文献中梳理。
Online Material Estimation for Conditioned Diffusion Policy in Shaping Deformable Linear Objects
针对DLO成形中材料差异导致的策略泛化问题,提出在线材料估计条件Diffusion Policy,并在真实机器人示教上验证。
Spectral Consistency-Guided Multiview Point Cloud Registration for Low-Overlap Scenes
针对低重叠多视角点云配准,GMPCR以谱一致性筛选对应与扫描对,并在多个数据集验证精度、鲁棒性和效率。
Robust Underwater Grasping of Sloped Objects with a Waterproof Passive Adaptive Gripper
针对湿润或水下斜面物体易滚动滑移的问题,提出防水被动自适应夹爪,并在干燥和水下抓取实验中验证。
ArtManip: Category-Level Articulated In-Hand Manipulation
ArtManip面向类别级铰接物体灵巧手内操作,结合自动构型生成与两阶段策略训练,在仿真和真实物体上验证泛化。
DWMP: Leveraging Dual World Models for Humanoid Obstacle Traversal
针对人形机器人依靠本体与视觉穿越杂乱障碍场的问题,DWMP融合双世界模型表征,并在仿真和Unitree G1真机验证。
SCQ: Stabilizing Conservative Q-Learning with Sigmoid-Bounded Entropy
SCQ用正的sigmoid有界熵稳定离线到在线强化学习,并在D4RL、仿真与真实视觉任务验证。
STAR: Sparse Tactile Representation Learning in Vision-Tactile-Language-Action Models for Dexterous Manipulation
为解决灵巧操作中稀疏触觉表示难题,STAR用联合预训练和稀疏触觉预测,在自建数据与真实任务上验证。
Lightweight LiDAR-Based Cone Detection Framework Using Random Forest for Formula Student Driverless
提出面向CPU的LiDAR-only轻量感知流水线,并在真实FSD赛事采集的标注簇上验证低延迟锥桶检测。
Visual-SLAM for the detection of hidden tomatoes in greenhouses by Hierarchical Localization and GLOMAP for robotized harvesting
该工作用单目相机 Visual-SLAM 结合 GLOMAP 与 Hierarchical Localization,在真实温室番茄串上验证低成本三维建图与遮挡果实识别。
Gait-Dependent Effects on Quadruped Locomotion for Load-Carrying using Passive Mechanism
研究被动臂刚度阻尼在不同步态和载荷下对四足载荷搬运的影响,并在平地仿真中比较阻尼与欠阻尼配置。
Quadruped Obstacle Avoidance and Footstep Planning With Distributed Low-Cost Time-of-Flight Sensors
研究用分布式低成本 ToF 传感器替代深度相机进行近场地形映射,并在 ANYmal 四足上验证避障与落足规划。
Rapid Learning of Dexterous In-Hand Pen Writing through Real-Time Jacobian Estimation
该研究针对仿人手手内操作建模与数据需求高的问题,提出物理机器人实时任务雅可比估计控制,并在一台真机和两套仿真手上验证握笔书写。
AnchorVLN: Geometry-Anchored Vision-Language Grounding Reasoning for Open-Vocabulary Navigation
AnchorVLN以VLM提出语义、几何决定度量,通过MCP工具在CMU VLN Challenge 2026两类任务上验证开放词汇导航。
GeoTrussRover: Morphological Computation with Contact-Semantic Control Primitives
GeoTrussRover用接触语义形态规划与控制,将一次台阶穿越提取为基元,并在高度可行性分析和电动原型上验证复用。
RodForesight: A World Model Enhanced Diffusion Policy for Slender Rod Insertion
针对细长杆插入中杆体弯曲导致的对准控制难题,RodForesight结合视觉伺服、扩散策略与动作条件世界模型,并在插入实验中验证提升成功率。
ScaRF-SLAM: Scale-Consistent Reconstruction with Feed-Forward Models and Classical Visual SLAM
针对GFM辅助SLAM中预测误差影响位姿的问题,ScaRF-SLAM解耦跟踪与建图,并在室内建筑级和室外大规模数据上验证。
SwarmNxt: Open-source Software-Hardware Platform for Fast and Agile Aerial Swarms
针对敏捷视觉集群飞行平台受限问题,SwarmNxt基于OmniNxt和ROS 2提供开源工具链,并在室内真机多无人机实验中验证。
Expressive Robotic Pianist: Mastering Complex Piano Repertoire with Graph-Mimic and Musical Dynamics
该研究用强化学习、图优化和声学模型控制灵巧手,在多风格钢琴曲目上实现富有表现力的演奏。
Grounding Generated Video Plans in Simulation Towards Versatile Dexterous Controllers
将生成HOI视频与仿真落地结合,训练多物体多轨迹跟踪器,并在仿真和真实闭环操控中验证。
Show-Harness: Just a VLM Agent Can Play Robots
Show-Harness用紧凑语义接口连接意图与动作,并在跨任务、具身和环境实验中验证VLM机器人控制。
Model Predictive Control of Tensegrity Robots via Contact-Aware Graph Neural Dynamics Model
针对张拉整体机器人在接触丰富环境中难建模难控制问题,提出基于接触感知GNN动力学模型的MPPI控制器,并在MuJoCo五类导航任务中验证。
A Decade of Bayesian Optimization for Controller Tuning and Robot Learning: Tutorial, Review, and Future Prospects
本文面向自动控制器调参与机器人学习,综述贝叶斯优化方法、应用与挑战,并提出控制与机器人轻量级基准。
AURORA: Active Uncertainty-Driven Re-Orientation for In-Hand Reconstruction
AURORA用Ray-GPIS将在线物体重建与手内重定向闭环,在手内三维重建实验中提升质量和信息获取效率。
BIDETA: Brain-Inspired Data-Efficient Tactile Adaptation for Unseen Sensors
BIDETA用冻结触觉编码器和少量目标标注,无梯度适配未知触觉传感器,并在SITR等数据集验证。
TacClip: a clip-on sensor measures dynamic contact forces without covering the fingerpads
TacClip用嵌入指甲夹扣的FBG记录指尖形变,在不遮挡指腹的情况下测量动态接触,并在按压、布料和胶带测试中验证。
From LLM-Generated Specifications to Learned Quadruped Locomotion
研究用LLM生成PSTL规格并转为平滑奖励,在MJX中训练并评估四足运动策略。
Boreas road trip: A multi-sensor autonomous driving dataset on challenging roads
Boreas-RT扩展Boreas到多样挑战道路,用多传感器真实行驶数据评测里程计与度量定位算法。
Dex-X: Learning Visual-Tactile Dexterous Manipulation From Human Videos with Simulated Interaction
DEX-X将单目人类演示重建到仿真中补全触觉监督,训练视觉-触觉策略,并在仿真与真机灵巧手臂任务上验证。
MAC-I$^2$: Learned Metrics-Aware Covariance for Robust Visual-Inertial Fusion in Initialization and Calibration
针对预设不确定性导致的VI融合鲁棒性不足,MAC-I$^2$学习视觉与IMU度量感知协方差,并在EuRoC和VBR初始化标定中验证。
P$^2$Calib: Utilizing Pattern Priors for LiDAR-Camera Extrinsic Calibration
P^2Calib利用标定板CAD模式先验改进四孔流程,并在仿真与真实数据集上验证外参标定精度提升。
SPOT: Spatial Perception-Oriented Long-Horizon Humanoid Teleoperation
SPOT通过宽视场立体显示、自由视角与视觉稳定扩展操作者感知范围,并在多类感知关键人形数据采集任务上验证。
WM-Craftnet: World Synesthesia Model for Generalizable and Robust Dexterous In-Hand Manipulation
针对噪声观测下手内操作鲁棒性下降,WM-Craftnet学习多模态动作条件世界模型,并在多物体旋转、扰动恢复和Sim-to-Real上验证。
SHIFT: Surface-aware High-speed Integration For TSDFs
针对实时3D建图中距离场计算开销瓶颈,SHIFT利用3D深度几何压缩平坦区域并优化ESDF布局,在多种RGB-D和LiDAR序列上验证。
Adaptive Cost-Sensitive Machine Learning for Autonomous Robot Navigation Failure Prediction: When Not All Errors Are Equal
将导航失败预测重构为后果敏感预测,结合严重度与状态风险加权,并在仿真及UCI SCITOS G5上验证。
MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control
MobileVLA-R1 2.0用监督CoT对齐与强化学习耦合具身推理和控制,并在导航、四足控制和人形移动操作上验证。
NSFlow: End-to-End Differentiable Neuro-Symbolic Optical Flow for Visual Odometry
提出CNN特征与可微LK优化结合的神经符号光流,用于VO/VIO前端,并在嵌入式平台和VIO系统中验证。
Adaptation Needs in Robotic Systems: Assessing Behavior Trees and Their Enhancement
论文通过文献研究与经验验证,评估 Behavior Trees 应对机器人适应需求的能力及增强方法。
Physics filtering favors the generalization of robot learning
论文提出PhyFilter,用物理滤波反馈残差在有限数据下校正学习输出,并在四类机器人系统上验证泛化。
Dressing in Motion: A Human Motion-Aware Diffusion Policy for Robot-Assisted Dressing
该文面向用户手臂运动下的机器人辅助穿衣,提出基于点云与PDE扩散表征的Diffusion Policy,并在仿真和真人研究中验证。
TacPAC: Tactile Prediction and Real-Time Action Correction in World-Action Models for Contact-Rich Manipulation
TacPAC将触觉预测转为实时动作校正,在五个真机接触丰富操作任务上提升视觉基模型表现。
Air-Ground Collaborative Vision-and-Language Navigation via Shared Bird's-Eye Maps
提出免训练基线AGC-VLN,通过共享鸟瞰地图协同UAV与UGV,并在CARLA-Air Town10HD闭环任务中验证。
Deep learning-based robust autonomous navigation of aerial robots in dense forests
针对密林中空中机器人自主导航,提出融合语义深度编码与神经运动基元评估的框架,并在三处北方森林用定制四旋翼验证。
A comparative study on the accuracy & repeatability of mobile robotic platforms for the delivery of precision NDE measurement
研究用激光跟踪仪统一评估五种商用移动平台在大型航空结构 NDE 中的静态与轨迹定位精度。
AquaBEV: Monocular Underwater BEV Occupancy with 3D Sonar Supervision
AquaBEV用训练时配对3D成像声呐监督单目RGB图像预测局部水下BEV占用,并在受控基准验证。
MulDP: Multimodal Diffusion Policy for Autonomous Quadruped Parkour Navigation across Complex Terrains
针对四足跑酷导航依赖人工高层规划的问题,MulDP融合视觉、本体感知与目标信息,在仿真和真实实验中验证复杂地形自主导航。
R2S-Eval: Robot Evaluation with Real-to-Sim Calibration via Vision-Language Models
R2S-Eval用Real-to-Sim校准生成仿真视频,并由VLM偏好评估,在仿真与真实设置中验证机器人策略评估。
RoughSense: Lightweight Terrain-Induced Rover Vibration Prediction Using Point Clouds and IMU Feedback
面向空间自主导航地形评估,RoughSense 结合 LiDAR 点云几何与 IMU 反馈,在线校正振动通行性地图,并在月面类比、户外和地下矿井评估。
Physics-Informed Sliding-Window Particle Filtering for Tactile-Only In-Hand 6-DoF Object Pose Refinement
针对视觉不可用或遮挡下的手内物体位姿精修,提出物理信息滑动窗口粒子滤波,并在Allegro Hand V5五个物体上验证。
Seeing Less Is Not Seeing Safely: Privacy Leakage from Task-Scoped Robot Perception Exports
针对家用机器人结构化感知导出的隐私泄露,提出TFPD按任务评估导出,并在AI2-THOR与ProcTHOR任务中验证。
Odometer-Agnostic Drift Correction Using OpenStreetMap Lane Geometry
针对大规模或无闭环环境中的长期漂移,提出将短轨迹片段与 OSM 车道中心线直接对齐的轻量开源方法,并在 LiDAR 和视觉里程计后端验证。
DevGRU: Depth-Guided Visual Navigation Using a Collision-Aware Recurrent Model
DevGRU面向复杂室内导航碰撞问题,结合深度图、点目标与碰撞感知循环模型,在九个场景中验证性能。
FlexWorm: Primitive-Augmented Hybrid Contact-Motion Planning for Suction-Based Multi-Segment Deformable Robots
针对多段吸附软机器人依赖手工步态的问题,提出结合IKHS与学习运动基元的混合规划,并在仿真和硬件实验验证。
HINT: Human-Intent Inception for Long-Horizon Robot Manipulation
HINT面向长程操作中视觉捷径压过语义意图的问题,在模式转换时推理并跟踪意图,于长程任务和分布外变体上验证。
RoboTok: A Scalable Data Engine for Internet Demonstration Video Retrieval and Dexterous Manipulation Learning
RoboTok用查询人类操作视频检索互联网演示,学习灵巧机器人策略,并在检索、下游策略和真机实验中验证。
One Print, Many Moves: Monolithic Origami-inspired Folding Actuator for Composable Soft Multi-DoF Systems
针对软执行器变形难控且难扩展问题,MONORIGAMI以空间编程刚度各向异性实现可组合折叠,并在三类3D打印软多自由度系统中验证。
Non-Prehensile Throwing: A Reinforcement Learning Perspective
提出强化学习非抓取投掷方法,直接优化关节轨迹,并在仿真和UR5e真机零样本部署中验证。
Provably Safe Sim-to-Real Transfer
将安全 Sim-to-Real 迁移表述为无奖励安全 RL,提出结合可靠仿真与安全采样的算法,并通过理论分析给出可行近优保证。
Scalable Rao-Blackwellized Online Planning for High-Dimensional POMDPs
针对高维部分可观测环境中的在线规划,提出混合连续-离散信念的 RB-POMDP,并在机器人搜救任务中验证。
Selective Field Transmission: Bandwidth Efficient Communication Under Standardized Message Schemas
提出SFT中间件,在发布-订阅系统中按接收方需求传输标准消息字段,并评估其带宽与延迟效果。
Vision-Language Model Reasoning for Contextual Semantic Mapping in Intralogistics
面向内物流机器人缺乏物体语义与上下文属性的问题,提出结合SLAM、SAM、聚类与VLM多视角推理的语义建图流程,并在语义分类和可移动性估计上验证。
HiBerNAC: Hierarchical brain-inspired robotic neural agent collective for disentangling complex manipulation
HiBerNAC以脑启发层级多智能体结合VLA规划推理,在MuJoCo仿真复杂操作基准验证长程与多路径任务表现。
World Models for Robotic Manipulation: A Survey
本文综述机器人操作世界模型,以动作条件预测系统为定义,梳理表示、行动连接和学习流程用途,并回顾38个操作数据集。
FEWT: Frequency‐Enhanced Wavelet‐Based Transformer for Multimodal Wheeled Bimanual Manipulation
FEWT缓解视觉语义与高频物理动态表征不匹配,并在仿真双臂插入和真实操作任务中验证。
Motus2: A Self-Evolving General World Model for Dexterous Manipulation
Motus2面向灵巧操作,将策略、模拟器和评估器耦合为闭环,并在仿生平台上实例化。
Is semantic SLAM ready for embedded systems? A comparative survey
本文从嵌入式部署视角比较语义视觉 SLAM 管线,在 Jetson AGX Orin 上评估三类方法的精度与效率。
Planning-Aligned Token Compression for Long-Context Autonomous Driving
针对长时上下文使视觉-动作模型超出实时预算的问题,COMPACT-VA用规划对齐条件VQ-VAE压缩记忆,并在动态驾驶场景验证。
Robust Scene Transfer for PointGoal Navigation via Privileged-Sensor–Guided Contrastive Learning
提出由 LiDAR 特权传感器引导的自适应对比学习框架,在高保真仿真中提升 PointGoal 导航的跨场景迁移。
Online Joint Calibration of Steering Offset and Planar LiDAR Extrinsics for Wheeled Mobile Robots
提出基于 EKF 的在线方法,在自行车运动学模型中估计转向偏置与平面 LiDAR 外参,并在真实数据集上验证。
One year in a forest: Analyzing the challenges of autonomous navigation in subarctic environments
针对亚寒带森林自主导航难题,论文用一年移动机器人外场数据评估九种方法,并分析季节变化下表现。
Remote Human-Robot Interaction In Greenhouses via Virtual Reality: How Plant Canopy Structure Affects Leaf Disease and Soil Moisture Inspection
研究用VR遥操作地面车与机械臂在温室检查叶片和土壤湿度,验证冠层遮挡对可靠性的影响。
A Terrain-Adaptive $\epsilon$-Constraint MPC for Uneven Terrain Kinodynamic Planning
该工作针对不平坦地形类车车辆规划,提出地形自适应 ε-约束 MPC,并在与 MPPI、GAKD 对比中验证。
Simple Actors and Deep Critics for Scalable Reinforcement Learning
LAC将容量投向训练期深度Critic并用轻量确定性Actor,在OGBench上匹配生成式基线且推理延迟更低。
Arrive and Survive: Scaling Safe Goal-Conditioned Policy Learning from One-Bit Failure Signals
Safe-CRL针对故障终止下CRL高估目标到达价值,仅用一位失败信号和两项校正,在十二个机器人导航与运动任务上验证安全学习。
When Obstacles Bend: Modeling Vegetation Deformation in the context of Field Robotics
针对自然环境机器人穿越植被的可通行性表征难迁移问题,提出用变形与接触力估计植被机械参数并重建交互响应。
A Tendon-Driven Five-Fingered Hand with Distributed Tactile Perception for Dexterous Manipulation
针对灵巧手受灵巧性与触觉感知限制,提出带分布式双模态触觉的腱驱五指手,并在多种操作实验中验证。
Trust-Aware Sequential Decision Making and Rollout Planning for Resilient Multi-Robot Systems
针对定位欺骗下在线多机器人路由,提出信任感知监测与移除机制,并在真实GPS欺骗数据和旧金山出租车需求上验证韧性路由。
AGRO-Nav: Autonomous Graph-based Orchard Navigation
AGRO-Nav用SLAM点云构建果园拓扑图并全局规划,在真实果园和Isaac Sim中验证行中心导航。
Phantom Navigator: Stealthy and Precise Unmanned Aerial Vehicle Redirection with Real-Time Tracking and GPS Spoofing
提出 Phantom Navigator,结合可达性分析与闭环隐蔽执行,在真实世界案例中验证用实时跟踪和 GPS 欺骗精确重定向无人机。
Praxist: From Experimental Artifacts to Solution Lineages
Praxist用谱系中心的证据图与代际系统解决自主R&D反复重学问题,并在MLE-bench和五个工程案例验证。
TacForcing: Streaming Action Generation with Execution-Time Tactile Feedback
TacForcing面向接触丰富操作中触觉反馈滞后的问题,通过流式动作生成与EATA,在仿真和真实任务上验证。
VirTooS: A ROS 2 - Unity Virtualization Toolkit for Fleet Management of Autonomous Mobile Robots
VirTooS结合ROS 2与Unity,为AMR团队车队管理提供混合现实虚拟实验工具,并在任务分配实验中验证。
A Durable Vision-Based Tactile Fingertip for Robotic Manipulation
针对视觉式触觉传感器易磨损问题,提出带TPU保护膜和可更换感知盒的触觉指尖,并用加速实验验证耐久性。
Learning to Act While Waiting: RL Finetuning of Generalist Robot Policies Under Inference Latency
针对 VLA 等通用策略推理延迟导致 RL 失效,提出 ARLI 延迟感知框架,并在仿真与真实操作任务中验证有效微调。
Privileged Critic Training Enables Sensor-Free Thruster Fault Adaptation in End-to-End RL
针对推进器故障难观测且缺少专用传感器的问题,提出RAFT用特权非对称Critic和循环记忆训练,并在浮动平台机器人上验证。
RoboRacer Arena: Specification-Driven Track Construction for Autonomous Racing
RoboRacer Arena以自然语言规格驱动生成、验证赛道并构建Isaac Sim环境,在地图生成、资产转换和物理竞速中验证。
TONAV: Task-Oriented Navigation and Action-Velocity Chunk Learning for Articulated Object Quadrupedal Mobile Manipulation
TONAV结合任务导向导航与动作-速度块学习,在真实关节物体任务中提升导航与移动操作成功率。
DELTA: Deformable Elevation-Based Local Terrain Attention Encoder for Sparse-Terrain Quadrupedal Locomotion
DELTA用可变形局部高程注意力编码器降低稀疏地形四足落足感知成本,并在仿真与RAIBO2真机验证。
The Coastline as a Structural Constraint: Harnessing Scene Geometry for Autonomous Surface Vessel Localization
面向GPS拒止水面船定位,利用海岸线与水面几何构建LiDAR和单目两套框架,并在三组真实海岸数据集验证。
Lifelong Robot Recomposition via Persistent Categorical Modeling for Unified Task-Driven Co-Design, Verification, and Planning
针对设计后部署导致机器人对变化脆弱的问题,提出持久范畴组合框架与SMT求解,并在部署机器人和搜救场景验证。
Extending the Speed Limit of Quadrupedal Locomotion via Refined Actuator Modeling and Adaptive Command Scheduling
该框架通过精细执行器模型和自适应命令调度缩小高速四足运动的仿真到现实差距,并在BP2上验证高速表现。
EllipseLIO: Adaptive LiDAR Inertial Odometry With an Ellipsoid Representation
针对异构环境和 LiDAR 传感器下 LIO 难以稳健泛化,EllipseLIO 通过自适应扫描滤波与配准,在五个数据集上验证。
GhostTac: Manipulating Tactile Sensors without Physical Contact
GhostTac利用电磁干扰无接触操纵触觉传感输出,并在多种传感器、灵巧手及真实机器人任务案例中验证影响。
GOLEM: Modular Humanoid Autonomy Towards Electric Vehicle Battery Disassembly
GOLEM面向退役EV电池包拆解,采用模块化开源架构,在仿真数字孪生与真实Unitree H1-2上验证。
TOL: Textual Localization With OpenStreetMap
提出T2O文本到OSM定位任务与TOL基准,并用粗到细TOLoc在多城市道路轨迹上验证定位性能。
ViTacPhys: Physical Property-Aware Grasping from Human Visual-Tactile Demonstrations
ViTacPhys从人类视觉-触觉演示估计物体物理属性并条件化抓取策略,在属性预测和真实自适应抓取中验证。
VT-MUSE: Multimodal Unified Sequential Visuotactile Representation Learning for Manipulation
VT-MUSE通过两阶段视觉触觉序列表征学习与门控交叉注意力策略,面向操作任务在仿真基准和真实实验中验证。
Towards general embodied intelligence: integrating large language models, knowledge bases, and reasoning capabilities to build the next generation of AI agents
本文综述LLM、知识库与推理能力如何融合迈向GEI,提出概念框架并梳理具身智能范式与关键挑战。
HiTac-WAM: A Hierarchical Tactile World Action Model for Contact-Rich Robot Manipulation
针对现有触觉世界动作模型未分层建模物理依赖,HiTac-WAM分解预测触觉状态并用于规划,在三项真机操作中验证。
The Missing Touch: Spatially Distributed Tactile Feedback Brings Teleoperation Closer to Human Dexterity
研究用二自由度力反馈遥操作器和32自由度触觉显示验证,空间分布式触觉反馈可提升遥操作表现并更接近人类动作。
Hybrid Feedback Sampling for Sample-Efficient Model Predictive Control
针对高维和开环不稳定系统中采样式MPC样本效率差的问题,提出FS-MPC,并在接触丰富及真实人形机器人任务上验证。
LabDex: A Hierarchical Benchmark for Dexterous Manipulation in Laboratories
LabDex针对实验室灵巧操作评测不足,构建层次化真实数据集与基准,并在真实与仿真环境中验证。
SoftVTBench: A Deformation-Aware Visuo-Tactile Dataset and Benchmark for Deformable-Object Manipulation
SoftVTBench用视触觉数据集和DSR闭环基准,在多种策略与分布转移设置上评估可变形物体操作的交互质量。
Reproducible Multimodal Affordance Prediction
针对可供性预测难以公平比较的问题,提出 Affordance Sheet 文档,用于真实场景中的可复现基准与评估。
Collective Ranking of Environmental Signals through Gaussian Belief Propagation in a Patrolling Robot Swarm
针对多机器人巡逻中的环境信号集体排序,利用巡逻图上 GBP 传播信念,并在仿真和四台 Leo Rovers 实测中验证。
Embodied-Navigator: Point, Think, Memorize, and Align for Efficient Navigation
TAMP-Nav通过2D像素提示、选择性推理记忆和两级对齐提升具身导航,并在R2R-CE等实验中验证。
GuideFetch: A Task Coordination Framework for Concurrent Navigation and Object Retrieval in Assistive Robot Dogs
GuideFetch用LLM生成受日程约束的动作方案,协调异构机器狗导盲与取物,并在仿真中验证。
PRISM: Precision and contact-rich Real-world Industrial Skill dataset with Multimodal sensing
PRISM面向工业装配的高精度富接触学习,收集同步多模态遥操作数据,并在真实制造操作上提供基准。
Trajectory-Level Automatic Curriculum Learning for Legged Locomotion on Unstructured Terrain
该文针对非结构化地形足式运动课程设计困难,提出轨迹级自动课程学习框架,并在非结构化地形轨迹任务上验证成功率提升。
Robot-Body-Aware Traversal Risk Graph Planning for Wheeled-Legged Robots in Complex Terrain
针对TRG忽略定向机身足迹的风险,RB-TRG以机身风险转移进行A*规划,并在扫描地形、MuJoCo和Go2-W实机上验证。
Terrain-Aware Local Path Planning with Global DEM Data Integration for Autonomous UGV Navigation
针对复杂户外地形中全局地图与实时感知脱节问题,提出融合 DEM 与 LiDAR 的混合规划框架,并在 Gazebo 仿真验证。
Throwing a Tight Spiral American Football by a Humanoid Robot
提出全身控制框架调控释放动量与接触过程,并在29-DoF人形机器人上验证紧密螺旋投球。
GaussianDWM++: Language-Grounded 3D Gaussian Driving World Model for Unified Scene Understanding, Editing, and Multi-Modal Generation
提出基础特征Gaussian驾驶世界模型,在驾驶基准上统一验证场景理解、语言推理、可控4D编辑与多模态生成。
ViHaTeleop: A Low-Cost, Lightweight Visual-Haptic Teleoperation System for Dexterous Manipulation Learning
ViHaTeleop以视觉追踪和逐指振动反馈采集接触示教,并在仿真与真机接触任务中验证。
Zetta $ζ$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence
Zetta通过三时间尺度闭环在线演化运行时评判器与恢复技能,在LIBERO-Pro和RoboCasa上验证自演化物理智能。
Tactile Sim2Real without Tactile Simulation via Bottlenecked Latent Reconstruction
针对触觉传感器仿真建模困难,SBLR用oracle潜变量与真实传感器对齐,在仿真和硬件任务上验证。
Accelerating Optimization over Graphs of Convex Sets via Neural Network Approximations
针对GCS在线重规划中子问题计算昂贵,方法以GAT和排序网络替代凸松弛,并在多类机器人规划任务上验证。
EgoTac: In-the-wild Tactile Prediction from Egocentric Vision
EgoTac从第一人称人类视频直接预测触觉信息,并在域内、域外基准及真实视频上验证。
HP2-SLAM: Adaptive Hybrid ICP for Robust and Efficient LiDAR SLAM
HP2-SLAM以邻域大小自适应混合ICP提升LiDAR SLAM鲁棒性与效率,并在公开数据集上验证。
LAPF: LLM-Agent-Based Path Finder Using the UAVScenes Dataset
针对复杂户外UAV自主导航泛化与适应不足,LAPF以闭环认知架构融合感知、记忆、规划和动作,并在开放场地与注入障碍场景验证。
LightLoc++: Sensor-Robust Representation Learning for Efficient Outdoor LiDAR Localization
LightLoc++通过跨传感器一致性预训练与高效新场景学习,在多个室外 LiDAR 定位基准验证传感器鲁棒定位。
SCORE: Shape-Conforming Regions for Flight in Enclosed, Degraded Environments
针对封闭退化环境中无人机避障保守问题,SCORE用SDF定义保形禁入区,并在真实地下数据上验证。
AdvDex: Learning Dexterous Manipulation from Human Demonstrations via Joint-Aligned Actions and Adversarial Learning
AdvDex用统一VLA框架、JAAS与域对抗学习,从人机演示学习灵巧操作,并在手部动作预测和真实操作中验证。
FlatLab: A Unified Methodology Framework and Simulation-Based Benchmark for Robotic Manipulation of Flat Objects
面向扁平物体难抓取与泛化问题,提出策略生成与动作执行解耦框架,并在FlatLab仿真基准验证。
PILOT: Privileged Imitation Learning for End-to-End Motion Planning of Autonomous UAVs under Partial Observability
PILOT面向部分可观测下UAV端到端运动规划,融合特权模仿学习与时空感知,并在仿真和室内外零样本部署验证。
SAP-Nav: Spatial Semantic Representation Meets Active Perception for Hierarchical Open-Vocabulary Object Navigation
SAP-Nav以在线零样本主动感知构建可查询空间语义表示,并在LangMap、HM3D-OVON和真实机器人上验证层次化OVON。
When Your State Estimator Has Lost The Plot: Detecting Estimator Failures Via Spectral Analysis
提出传感器无关的频域内省方法,分析近期速度估计功率分布,并在空中机器人户外飞行里程计数据上验证。
GS-CPE: Unified 6-Degree-of-Freedom Camera Pose Estimation via 3D Gaussian Splatting
针对鲁棒泛化与高精度难兼顾,GS-CPE结合几何粗估计与3DGS扭曲细化,在室内外基准和自定义数据集验证。
Seeing above the waves: A modular sensing framework for data acquisition at sea
针对水面船舶海上感知数据采集与复现实验困难,提出融合多模态传感器和ROS2数据管理的模块化框架。
Cross-View Sequential Visual Localization with Spatio-Temporal Context Modeling for Autonomous Driving
针对自动驾驶跨视角定位时序信息不足,提出循环跨帧时序上下文框架,并在CVIS、KITTI-CVL和真实车辆实验验证。
PBD-AG: Persistent Baseline-Delta Active Graphs with Uncertainty-Aware Inspection for Long-Horizon Service Robots
PBD-AG通过持久基线-增量主动图建模可变物体,在多环境仿真和物理机器人演示中验证长时程感知。
Navigating the Proximity-Safety Balance: Constraint Decomposition for Human Following in Pedestrian Crowds
该方法将人类跟随分解为稀疏任务奖励与独立成本约束,并在分布内外实验和真机部署中验证。
Whole-Body Planning for Humanoids Navigating Confined Spaces via Self-Collision Avoidance References
针对人形机器人狭窄空间导航,提出结合可达刚体体积与可微碰撞避免的三阶段全身规划,并在Unitree G1基准与物理仿真中验证。
Towards Collaborative Joint Perception and Prediction: Framework, Baseline Evaluation, and Deployment Perspectives
面向CAV感知误差累积与遮挡,提出Co-P&P框架,并在融合策略评估和端到端原型中验证。
Multi-Submap Implicit Neural SLAM with Local-to-Global Loop Closure for Large-Scale Scene Reconstruction
针对大规模复杂环境神经 SLAM 的遗忘与漂移,提出多子地图和双层闭环系统,并在公开基准及室内外数据上验证。
Knowledge-Distilled End-to-End Reinforcement Learning for Smooth 6-DOF Thrust Control and Rapid Adaptation to Ocean Currents in Remotely Operated Vehicles
针对ROV在海流扰动下难兼顾精度、响应、能耗和平滑推力,提出TSRCA-PPO并在仿真中验证优于P-PID。
Learning Fault-Tolerant Locomotion with Adaptive Gait Timing
针对执行器功率损失下的四足容错行走,提出带潜表示对齐和可学习步频的深度强化学习,并在仿真与实机验证。
Spatiotemporal Agility: Time-Constrained Reinforcement Learning for Vision-Guided Dynamic Quadrupedal Interception
针对四足机器人限时动态拦截,提出视觉预测结合位置与时间条件RL策略,并在接球实验中验证。
M2-SMap: Memory-Efficient Semantic Mapping with Hierarchical Multi-Model Representation
M2-SMap面向资源受限机器人稠密点云内存增长问题,采用分层多模型语义表示,并在三条RGB-D序列上验证实时性与紧凑性。
StepTrigger: Contact-State-Triggered Backdoor Attacks on VLM-Powered Legged Robots
针对VLM足式机器人规划器的隐蔽后门问题,提出StepTrigger用足地接触模式触发,并以分层离线评估验证。
From Passive Mirrors to Active Agents: Holonic Digital Twins for Physical AI over Networks
针对物理系统中AI难以共享时空上下文与长程规划的问题,提出HDT-Nets框架用于实时物理AI推理。
Acoustic-driven millimetric helical robot: ultrasonic synergistic manipulation in confined fluidic environment
针对受限生物环境中毫米级机器人声推进效率不足,提出多声场协同方法,并在仿真、运动实验和猪静脉体外测试中验证。
PathCover: A Fast Convex Decomposition along a Path via Randomized Iterative Space Partitioning (RISP) on Point Clouds
针对点云障碍下走廊生成实时瓶颈,提出RISP与PathCover,并在LiDAR数据、四旋翼仿真和四足真机中验证。
LoDA: A Level of Detection Aware Method and a Multimodal Sensing Benchmark for Object Level Change Detection
针对城市多时相LiDAR对象级变化检测,提出检测限感知3D管线与LoDA基准,并在Subiaco和Urb3DCD-V2验证。
SLAMFormer-$\infty$: Infinite SLAM Transformer for Unbounded Frontend and Backend Processing
SLAMFormer-∞面向无显式距离界限的SLAM前后端处理,借助记忆条件建模,并在大规模数据集上验证轨迹估计与场景重建。
On state estimation in multi-sensor fusion navigation: optimization and filtering
本文分析多传感器融合导航的状态估计方法,并在蒙特卡洛仿真和基于VO的车载消融实验中验证等价性。
Situation Aware Frontier Prioritization for Quadruped Search and Rescue
提出在前沿探索中融合多因素排序的情境感知方法,并在Gazebo四足机器人室内搜救仿真中验证。
DF$^3$: World Modeling via Decoder-Free Feature Forecasting in Autonomous Navigation
DF$^3$针对视频未来状态预测开销问题,在潜空间无解码器预测特征,并在公开基准和机器人仿真器零样本部署中验证。
ODG-NoMaD: Overhead-Camera Direction-Guided NoMaD
ODG-NoMaD用部署时顶视深度相机和机载深度为NoMaD探索提供方向,在模拟办公室环境中验证导航改进。
Open-DiffLoco: Open-Source Differentiable Learning for Deployable Blind Quadruped Locomotion
Open-DiffLoco用MJX中的SHAC和可微分仿真训练本体感知盲四足策略,并在Unitree Go2真机上验证。
Driver2Map: Imitating Human Driving for Online High-Definition Map Construction
Driver2Map面向在线高精地图构建,融合车载多视角图像、标准精度地图和卫星图,并通过对齐与BEV融合在实验中验证。
KING: Embodiment-Aware Kinematic Graph Neural Network for Unified Motion Representation of Legged and Wheeled Robots
针对跨具身运动学模型泛化差,KING用GNN统一表示轮式与腿式运动学,并在真实环境中验证高精度里程计估计。
Impedance Control via Generalized Output Regulation
本文将阻抗实现问题等价为广义输出调节,在导纳架构下推导唯一精确柔顺控制律,并通过数值仿真验证。
Towards Terrain-Aware Safe Locomotion for Quadrupedal Robots Using Proprioceptive Sensing
面向低成本四足机器人不平地形安全行走,提出本体感知地形估计与CBF安全控制,并在实验中验证。
Neural Radiance Fields for the Real World: A Survey
该综述梳理NeRFs在3D场景表示中的理论进展、替代表示、应用挑战,并覆盖重建、计算机视觉、机器人、数据集与工具包。
Accelerating Large-Scale Bundle Adjustment for LiDAR Mapping via Parallel Computing
提出全并行计算框架,加速大规模 LiDAR 建图的束调整,并在公开数据集和多平台验证。
Fast-SDE: Efficient Single-Microphone Sound Source Distance Estimation in Reverberant Environments
针对受限机器人上的声源距离估计,Fast-SDE以子带单麦克风框架在仿真和真实实验中验证。
HuMam: Humanoid Motion Control via End-to-End Deep Reinforcement Learning with Mamba
HuMam面向人形运动端到端RL不稳定和能耗高问题,采用单层Mamba融合状态与足步目标,在mc-mujoco的JVRC-1上验证。
PTRL: Prior Transfer Deep Reinforcement Learning for Legged Robots Locomotion
针对腿式机器人强化学习训练耗资源且难迁移,PTRL通过预训练、迁移、微调在多机器人行走任务上验证提升效率与性能。
SSIL: Self-Supervised Imitation Learning for End-to-End Driving
SSIL无需驾驶指令数据或预训练模型,利用激光雷达估计位姿生成伪转角,在三个基准数据集验证端到端驾驶。
VIP-Loco: A Visually Guided Infinite Horizon Planning Framework for Legged Locomotion
VIP-Loco面向复杂动态环境中的腿式感知运动,结合视觉场景理解、RL与无限时域MPC,并在多形态机器人仿真任务中验证。
Implementation of Tightly-Coupled SLAM Fusion of GPS, IMU, and LiDAR for Autonomous Vehicles
本文实现融合Velodyne 3D LiDAR、高频IMU与GPS的紧耦合SLAM,并在仿真和实体部署中验证连续定位建图。
An AI Scientist that Doesn't Drift: Taste, Structure, and Falsifiable Findings in a Quadruped Navigation Research Loop
提出结构化AI Scientist研究仿真四足导航泛化,用实验卡、子代理和kkanbu在十一条研究流验证。
Policy-Level Recursive Self-Improvement for Embodied AI with a Criticality World Model
针对具身 AI 任务微调易停滞,提出以关键性世界模型引导场景收集的递归自改进,并在五个具身领域验证。
Security of World-Model-Based Embodied AI: A Lifecycle of Threats, Defenses, and Evaluation
该综述面向基于世界模型的具身 AI 安全问题,按生命周期梳理威胁、防御与评估协议。
Voxeland: Probabilistic instance-aware semantic mapping with evidence-based uncertainty quantification
Voxeland将网络预测建模为几何与语义层面的主观意见,增量构建带不确定性的实例感知语义地图,并在SceneNN和ScanNet上验证。
Bridging language and action: A survey of language-conditioned robot manipulation
该综述面向自然语言指令执行问题,按语言融入机器人系统的方式系统梳理语言条件机器人操作进展。
Advances, challenges, and opportunities for legged robots
本文评估人形与四足机器人在硬件、运动、自主、数据和应用方面的能力,梳理进展、挑战与未来影响。
Dense Soft Weighting for Radar Ego-Velocity Estimation
针对退化视觉环境中的雷达自速度估计,提出 Dense Soft Weighting 前端,并在三个数据集和嵌入式硬件上验证。
NeoRacer: An Open, Standardized 1:12 Scale Autonomous Race Car for Benchmarking and Education
提出开源1:12自动驾驶赛车平台NeoRacer,用标准化软硬件支持跨机构算法基准与教育,并在两次试点部署中说明设计。
Leveraging Semantic Maps for City-Scale Cross-View Localization
该方法用VLM提取并匹配全景与OpenStreetMap语义地标,结合贝叶斯滤波,在十一环境轨迹上验证城市尺度跨视角定位。
P3: Probabilistic Policy Propagation for Stable VAE-Based Robot Learning
针对 VAE 随机潜变量与 PPO 的失配,提出 P3 分布感知优化,并在人形跑酷任务上验证其效率与稳定性。
A Review Of Robotic World Models For Dynamic Environments Based On Factor And Scene Graphs
该综述面向动态环境中静态图式世界模型受限问题,梳理因子图与场景图表示、更新管线及下游应用。
A Motion-Aware Vector Quantization Framework with Centroid Reuse for Efficient VLA Inference
面向VLA模型GPU推理延迟高的问题,VQVLA以运动感知向量量化和质心复用加速推理,并在实验中验证相对GPU和多种加速器提速。
NEO: NeRF It Once, Edit It Many Times for Continuous Object Manipulation
NEO面向连续物体操作,用语言引导NeRF编辑,并在场景编辑、物体移除和pick-and-place实验中验证。
WARL: Wrench-Augmented Reinforcement Learning for Task-Agnostic Learning in Legged Robots
针对腿式机器人关节空间探索受限,WARL将力旋量引入动作空间,并在四足机器人多地形与运动任务上验证。
Memory for Attention: Language-Conditioned Re-Perception with a Vision--Language--Motion Map
论文将有限感知预算下的注意力分配表述为重感知,利用 VLMM 持久地图记忆,在 AI2-THOR 场景、CLIP 先验和26个查询上验证。
DAP-Pose: Deep Temporal Alignment and Physics-aware Cross-modal Sensor Fusion for Robust Pose Estimation
DAP-Pose通过跨模态融合、潜空间时间对齐和物理约束,在KITTI上验证多模态鲁棒姿态估计。
Mag4D-SLAM Dataset: A Repeated-Traversal Multi-Modal 4D Geomagnetic Dataset for Localization and Mapping
Mag4D-SLAM面向室外地磁SLAM,提供多模态重复遍历数据,并在校园轨迹上分析地磁可重复性、航向估计与地点识别。
When Is a Learned Command Adapter Worth It? Closed-Loop Identification and Counterfactual Auditing of Frozen Locomotion Policies
提出适配器必要性审计,用闭环识别和反事实指标评估冻结运动策略,并在Go2多类查询上验证。
S3: Stable Subgoal Selection by Constraining Uncertainty of Coarse Dynamics in Hierarchical Reinforcement Learning
本文针对HRL高层反馈稀疏且依赖低层执行的问题,引入粗粒度动力学不确定性内在奖励,并在非平稳长时程环境中验证。
SLAM in Low-Light Environments: Project Report
该报告针对低光照下RGB相机SLAM鲁棒性问题,基准测试六个系统在五个LaMARia序列上的表现。
Configuration-Induced Passive Self-Rotation for Perception-Enhanced Autonomous Flight
针对机载传感器视场受限问题,提出构型诱导被动自旋转三旋翼及分层自主框架,并在真实飞行实验中验证。
Stability and Comfort in Mobile Robot-Pedestrian Interactions
针对公共空间NMR与行人交互舒适性不足,提出基于SFM/TSFM的社会感知导航,并在仿真与行人实验中验证。
The Open Ant: A Robot Platform for Reinforcement Learning Research
为降低强化学习从仿真走向实物的不确定性,Open Ant提供实机与仿真平台,并在行走学习和仿真到现实迁移中验证。
VLN-AVP: Zero-Shot Vision-Language Navigation with Hybrid Long-Short-Term Memory for Autonomous Valet Parking
提出VLN-AVP,结合BEV与VLM及混合记忆,在仿真和真实车辆上验证零样本自主代客泊车导航。
Multi-Resolution Voxelized Map-Based Stereo Visual-Inertial Odometry
针对先验地图传输受限的VIO,提出多分辨率体素化地图与锥形索引关联,并在两个公开数据集验证。
Cross-Coordinate Correspondence Pruning for Image-to-Point Cloud Registration
针对I2P配准中点云密度权衡导致的粗匹配质量问题,提出CCP与MDPE,并在多个基准验证性能提升。
VIDAR: Visual-Inertial Dense Alignment and Reconstruction via a Geometric Foundation Model
VIDAR将SVO+IMU里程计与Depth Anything 3耦合,在EuRoC和TUM RGB-D验证单目度量稠密重建。
ADMM-Based Safety-Critical Distributed NMPC for Cooperative Transportation by Quadrupedal Robots
针对四足机器人团队协同搬运载荷,提出ADMM分布式NMPC,并在仿真与多机器人真机实验中验证安全鲁棒运输。
PhyAgentOS: A Self-Evolving Operating System for Embodied Agents with Decoupled Cognitive Planning and Physical Execution
PhyAgentOS以会话运行时和文件化状态解耦认知规划与物理执行,并在游戏、仿真和真实机器人上验证。
Toward Semantic Communication for Real-time Mobile 3D Reconstruction
面向实时移动3D重建,提出带像素置信图的语义通信框架,并在仿真中验证其提升位姿估计与结构一致性。
RAVEN: Reinforcement-Adaptive Visibility-Graph Planning for Robust Humanoid Navigation with Collision-Free MPC
RAVEN用强化学习自适应可见图几何参数,并结合无碰撞MPC,在延迟和噪声下验证鲁棒人形导航。
Learning Agile Navigation in Crowded Environments for Quadruped Robots
提出VOP-Nav,将VO几何安全与端到端学习结合,并在Isaac Gym和Unitree Go2实机验证拥挤动态导航。
SoftNav: Injecting 3D Scene Tokens into VLMs for Embodied Navigation
SoftNav将3D场景软token注入VLM,在HM3D-OVON、迁移基准和真实机器人上验证目标导航。
Design and Control of the "QuadBoat": A Quadruped Surface Vehicle for Drowning Rescue
针对水面救援中快速救捞溺水者的需求,提出仿生无人水面航行器QuadBoat,通过相关实验验证其救援执行有效性。
From Refusal to Recovery: A Control-Theoretic Approach to Generative AI Guardrails
该文将智能体 AI 安全视为序贯决策问题,用安全关键控制与强化学习构建模型无关预测护栏,并在模拟驾驶和电商中验证。
Vision-Based Dribbling for Humanoid Soccer via Privileged Representation Learning
针对人形足球带球中感知与控制分离的不足,提出嵌入时序深度编码器的强化学习策略,并在仿真Booster T1上验证。
ReflectVLN: Training Vision-Language Navigation Agents with Reflective Reasoning
ReflectVLN通过意图与执行智能体的闭环交互和Action-CoT,在标准VLN基准上提升成功率与路径效率。
StratMamba: Strategic and Reactive Stream Partitioning for Path-Efficient LiDAR-Based Obstacle Avoidance
StratMamba用双流Mamba时序建模分离反应避障与战略规划,并在IsaacLab、Gazebo和GO1真机上验证。
Self-Supervised Bootstrapping of Action-Predictive Embodied Reasoning
R&B-EnCoRe将推理作为潜变量自监督精炼,在多类具身任务和VLA架构上验证动作预测推理。
Toward Reliable Sim-to-Real Predictability for MoE-based Robust Quadrupedal Locomotion
提出结合 MoE 运动策略与 RoboGauge 评估套件的框架,在 Unitree Go2 上验证多地形鲁棒迁移。
Safe Large-Scale Robust Nonlinear MPC in Milliseconds via Reachability-Constrained System Level Synthesis on the GPU
提出 GPU-SLS,将可达性约束 SLS 与 GPU 并行 QP 用于安全鲁棒非线性 MPC,并在四足与人形等复杂系统上验证。
Now You See That: Learning End-to-End Humanoid Locomotion from Raw Pixels
针对视觉人形运动的感知噪声与多地形训练冲突,提出端到端框架,并在两个人形平台上验证。
Learning Agile Quadrotor Flight in the Real World
针对敏捷四旋翼对仿真建模与保守裕度的依赖,提出自适应在线学习框架,并在真实飞行实验中验证。
FlashSAC: Fast and Stable Off-Policy Reinforcement Learning for High-Dimensional Robot Control
针对高维机器人控制中离策略RL收敛慢且不稳定,FlashSAC以少更新、大模型和范数约束,在多仿真任务及人形运动Sim-to-Real中验证。
MOBIUS: A Multi-Modal Bipedal Robot that can Walk, Crawl, Climb, and Roll
提出MOBIUS双足机器人,结合多形态肢体、混合控制与MIQCP规划,并在硬件实验中验证多种运动与操作能力。
OmniXtreme: Breaking the Generality Barrier in High-Dynamic Humanoid Control
OmniXtreme通过解耦通用运动学习与Sim-to-Real物理细化,在高难数据集和真机上验证高动态人形跟踪。
CWI: Composite Humanoid Whole-Body Imitation System for Loco-manipulation
针对人形机器人移动操作难题,CWI框架解耦上下肢MoCap数据使用,通过对抗运动先验与多评论家架构优化策略。经蒸馏后仅凭手部姿态与速度指令即可驱动LimX Oli完成稳健移动操作与无全身动捕遥操作。
Drop-Then-Recovery: How Redundant Are Vision-Language-Action Models?
研究提出Drop-Then-Recovery协议与GateProbe指标,证实VLA模型语言骨干对机器人操控高度冗余。OpenVLA-OFT移除半数LLM块后LIBERO成功率从95.0%升至98.3%,仅保留2个语言块即可恢复基线,揭示视觉与动作通路更关键。
HumanoidUMI: Bridging Robot-Free Demonstrations and Humanoid Whole-Body Manipulation
提出HumanoidUMI无机器人数据采集框架,利用轻量VR与UMI夹爪采集人体关键点及腕部视角数据。通过高层策略预测关键点并重定向至全身控制器,在5个真实场景验证了从人类演示到人形机器人全身操作技能的有效迁移。
WOLF-VLA: Whole-Body Humanoid Optimal Locomotion Framework for Vision-Language-Action Learning
针对人形机器人接触丰富运动数据稀缺痛点,提出WOLF-VLA框架。通过融合全身最优控制合成动态一致轨迹,构建六类任务多模态数据集训练VLA模型,实现自然语言指令驱动的鲁棒运动策略生成,并将开源全套资产。
HiL-ResRL: A Model-Agnostic Finetuning Adapter via Human-in-the-loop Residual Reinforcement Learning
针对VLA模型行为克隆误差累积痛点,提出模型无关的残差强化学习微调框架。通过人机协同安全探索与动作修正机制,仅需1.5小时真机在线训练即可将任务成功率提升至95%以上,解决工业部署难题。
OpenHLM: An Empirical Recipe for Whole-Body Humanoid Loco-Manipulation
针对人形机器人上下肢解耦控制痛点,提出原生全身视觉语言动作模型OpenHLM。通过关节级遥操作与HuMI异构共训,在长程任务中以不足基线一半的演示数据,性能超越GR00T N1.6等SOTA模型并开源全套资产。
RT-VLA: Real-Time Vision-Language-Action Models via Knowledge Distillation
针对VLA模型推理延迟高难题,提出RT-VLA轻量化架构。通过多级监督蒸馏迁移SimLingo能力,视觉模式推理提速44.8倍,视觉语言模式提速7.9倍,兼顾实时控制与事后可解释性分析。
APT: Action Expert Pretraining Improves Instruction Generalization of Vision-Language-Action Policies
针对VLA模型OOD指令泛化差的问题,提出APT两阶段训练法。通过解耦视觉-动作先验与语言条件似然,在冻结VLM下预训练动作专家,显著提升未见指令与组合任务性能,兼容π及GR00T架构。
RoboSemanticBench: Diagnosing Semantic Grounding in Action Prediction for VLA Models
新基准RSB通过数学与常识问答抓取任务诊断VLA模型,发现其在控制抓取成功率后,语义正确目标选择率接近或低于随机水平,暴露预训练语义理解未能有效转化为具身动作决策的关键瓶颈。
Co-training with Ego-centric Video and Demonstration for Robot Navigation Task
提出将人类行走视频转化为移动机器人模仿学习数据集的VLA训练框架,通过相机运动估计生成兼容动作表征。水果搜索任务实验证实,人机数据联合训练显著提升语言理解与动作鲁棒性,验证了低成本扩展导航数据的有效性。
HOIST: Humanoid Optimization with Imitation and Sample-efficient Tuning for Manipulating Suspended Loads
针对人形机器人悬挂负载操作难题,HOIST框架结合VR遥操作微调VLA策略与批量强化学习。实测相比纯VLA基线,平移放置误差降低19.9cm,角度误差减少3.56度,验证了欠驱动搬运任务中模仿学习与样本高效调优的有效性。
HumanoidMimicGen: Data Generation for Loco-Manipulation via Whole-Body Planning
针对人形机器人移动操作数据稀缺难题,提出HumanoidMimicGen方法。通过全身规划与技能交错生成稳定无碰撞演示数据,配套9任务仿真基准。实验表明,混合生成数据训练的视觉运动策略比纯真值数据训练性能提升20%。
Silent Failures in Physical AI: A Literature Review of Runtime Action Authorization for Autonomous Systems
针对具身基础模型置信度高但物理执行错误的静默失效问题,提出运行时动作授权框架。定义失效分类与护栏功能体系,填补黑盒模型与物理执行间的安全验证空白。
PAPO-VLA: Planning-Aware Policy Optimization for Vision-Language-Action Models
针对VLA模型闭环交互不可靠难题,提出PAPO-VLA算法。通过因果充分性与必要性量化规划动作重要性并融入GRPO优势估计,在多基准测试中验证了其对任务成功率的有效提升。
Real-Time Whole-Body Teleoperation of a Humanoid Robot Using IMU-Based Motion Capture with Sim2Sim and Sim2Real Validation
研究提出无需离线缓冲的实时全身遥操作系统,利用Virdyn IMU动捕服驱动Unitree G1人形机器人。经MuJoCo仿真与真机双重验证,系统稳定复现行走、坐立及复杂手势,为低成本穿戴式具身数据采集提供可扩展框架。
BifrostUMI: Bridging Robot-Free Demonstrations and Humanoid Whole-Body Manipulation
提出BifrostUMI无机器人数据采集框架,利用轻量VR与UMI夹爪采集人体关键点及腕部视角数据。通过高层策略预测关键点并重定向至全身控制器,在5个真实场景验证了从人类演示到人形机器人全身操作技能的有效迁移。
HANDFUL: Sequential Grasp-Conditioned Dexterous Manipulation with Resource Awareness
针对灵巧手多任务序列操作难题,提出HANDFUL学习框架与仿真基准。通过将手指建模为有限资源并引入接触奖励,优化抓取策略以保留后续操作能力。仿真显示成功率优于贪婪基线,并在LEAP手上完成推、拉、压等实机验证。
Can Explicit Physical Feasibility Benefit VLA Learning? An Empirical Study
研究证实将几何物理可行性目标引入扩散策略VLA训练,可显著增强避障等硬约束下的动作可靠性。该方法在低数据场景下提升了学习效率与任务成功率,验证了显式物理信号对纯模仿学习的有效补充价值。
Learning Whole-Body Humanoid Locomotion via Motion Generation and Motion Tracking
提出结合扩散模型与强化学习的人形机器人全身运动框架,解决传统RL下肢主导及模仿学习缺乏在线适应问题。在宇树G1上实现基于机载感知的目标导向与地形自适应,成功穿越楼梯、障碍等复杂场景。
Vision-Language-Action Jump-Starting for Reinforcement Learning Robotic Agents
提出VLAJS方法将视觉语言动作模型作为瞬态引导源增强PPO算法,解决长程任务探索低效难题。仿真及Franka Panda真机验证显示,该方法在六类操作任务中环境交互需求降低超50%,并实现零样本Sim-to-Real迁移。
Cross-Hand Latent Representation for Vision-Language-Action Models
针对多形态灵巧手数据孤岛难题,XL-VLA构建跨具身统一潜在动作空间,支持标准VLA架构即插即用。实验证实该框架在灵巧操作任务中性能持续优于原始关节空间基线模型,显著降低新本体数据采集成本。
ZeroWBC: Learning Natural Whole-Body Humanoid Interaction from Human Egocentric Data
针对人形机器人全身遥操数据昂贵痛点,提出ZeroWBC免遥操框架。通过微调VLM将人类第一视角视频转为动作Token并重定向至宇树G1,配合交互导向跟踪策略,在无机器人示教下实现多样化场景感知全身交互控制。
Moving Through Clutter: Scaling Data Collection and Benchmarking for 3D Scene-Aware Humanoid Locomotion via Virtual Reality
针对人形机器人在复杂三维环境运动数据缺失痛点,开源MTC框架通过VR采集具身一致全身动作并自动重定向。构建含145个场景、348条轨迹的基准数据集,量化环境 clutter 程度与运动稳定性,支撑几何自适应控制研究。
X-Loco: Towards Generalist Humanoid Locomotion Control via Synergetic Policy Distillation
X-Loco提出协同策略蒸馏框架,训练单一视觉策略集成直立行走、全身协调及跌倒恢复技能。该方案仅依赖速度指令无需参考动作,通过动态专家选择机制解决多目标冲突,显著提升地形穿越与鲁棒性。
CLOT: Closed-Loop Global Motion Tracking for Whole-Body Humanoid Teleoperation
针对人形机器人长时遥操作全局位姿漂移难题,CLOT系统通过高频定位反馈与解耦奖励策略实现闭环全局运动跟踪。基于20小时动捕数据训练Transformer策略,在31自由度本体上验证了高动态、高精度及强鲁棒性的Sim-to-Real迁移效果。
Humanoid Manipulation Interface: Humanoid Whole-Body Manipulation from Robot-Free Demonstrations
针对人形机器人全身操作数据获取难题,HuMI框架利用便携设备实现无机器人数据采集与分层学习。实验显示其采集效率较遥操作提升3倍,在跪姿、双手操作等5类任务中于未见环境达成70%成功率。
TIC-VLA: A Think-in-Control Vision-Language-Action Model for Robot Navigation in Dynamic Environments
针对VLA模型语义推理滞后问题,提出TIC-VLA延迟感知框架与DynaNav仿真套件。通过显式建模延迟状态及一致性训练管线,使机器人在数秒级推理延迟下仍保持实时反应控制,仿真与真机实验性能均优于现有VLA模型。
Coordinated Humanoid Manipulation with Choice Policies
研究提出模块化遥操作接口与Choice Policy模仿学习框架,解决人形机器人全身协调难题。在洗碗机装载与白板擦拭任务中,该策略性能显著优于扩散策略与标准行为克隆,验证了手眼协同对长程任务的关键作用。
MiVLA: Towards Generalizable Vision-Language-Action Model with Human-Robot Mutual Imitation Pre-training
针对VLA模型跨具身泛化难题,MiVLA提出人机互模仿预训练机制,利用运动学规则对齐人手与机械臂动作空间。在ARX、PiPer等三型机器人验证中,仿真任务成功率超SOTA 25%,真机控制提升14%。
MindDrive: A Vision-Language-Action Model for Autonomous Driving via Online Reinforcement Learning
提出MindDrive框架,通过双LoRA参数将连续动作空间转化为离散语言决策空间,解决VLA在线强化学习探索低效难题。基于Qwen-0.5B在Bench2Drive基准取得78.04驾驶分与55.09%成功率,首次验证该范式有效性。
VideoVLA: Video Generators Can Be Generalizable Robot Manipulators
研究提出VideoVLA框架,将视频生成模型转化为机器人操作VLA。基于多模态Diffusion Transformer联合预测动作序列与未来视觉结果,验证了高质量视觉想象与任务成功率正相关,并实现跨具身技能模仿与新物体操作泛化。
Reinforcing Action Policies by Prophesying
针对VLA模型模仿学习泛化差痛点,提出Prophet世界模型与FlowScale算法。通过异构数据预训练构建可迁移仿真器,结合流匹配梯度重加权稳定后训练,在公开基准与真机任务中分别实现5-17%及24-30%成功率提升。
GraSP-VLA: Graph-based Symbolic Action Representation for Long-Horizon Planning with VLA Policies
针对VLA模型长程规划短板,提出GraSP-VLA神经符号框架。利用连续场景图将人类演示转化为符号表征,推理时自动生成规划域并编排底层VLA策略,实现在真实机器人长程任务中的有效执行与泛化。
TWIST2: Scalable, Portable, and Holistic Humanoid Data Collection System
提出便携式无动捕人形机器人遥操作与数据采集系统TWIST2,基于PICO4U VR与自研低成本颈部实现全身控制。15分钟可采集100条演示且成功率近100%,配套分层视觉运动策略及数据集已完全开源。
ACG: Action Coherence Guidance for Flow-based Vision-Language-Action models
针对流匹配VLA模型模仿学习中的演示噪声问题,提出免训练测试时引导算法ACG。在RoboCasa、DexMimicGen及SO-101真机任务中验证,该方案有效抑制轨迹漂移并显著提升精细操作成功率,代码已开源。
VLA-RFT: Vision-Language-Action Reinforcement Fine-tuning with Verified Rewards in World Simulators
针对VLA模型分布偏移痛点,提出基于数据驱动世界模型的强化微调框架VLA-RFT。利用动作条件视觉预测生成密集奖励,仅400步微调即超越强监督基线,显著提升具身策略鲁棒性与样本效率。
World-Env: Leveraging World Model as a Virtual Environment for VLA Post-Training
针对VLA模型数据稀缺与实机RL高风险痛点,提出World-Env框架。利用物理一致世界模型替代实机交互,结合VLM即时反馈机制,仅凭5条专家演示即可在复杂操作任务中显著提升成功率,代码已开源。
VLA-Reasoner: Empowering Vision-Language-Action Models with Reasoning via Online Monte Carlo Tree Search
针对VLA模型短视缺陷,提出VLA-Reasoner插件框架。通过在线MCTS与世界模型在测试时进行轨迹推演,结合KDE置信采样与离线价值评估,显著提升长程任务成功率,验证了具身智能测试时计算扩展的有效性。
Bi-VLA: Bilateral Control-Based Imitation Learning via Vision-Language Fusion for Action Generation
提出Bi-VLA框架,通过SigLIP与FiLM融合视觉语言特征及双边控制数据,解决传统方法单任务局限。真机实验验证其在语言辅助与纯视觉区分任务中成功率显著提升,实现单模型多任务精准操作。
Latent Action Pretraining Through World Modeling
提出LAWM模型无关框架,利用世界模型从无标签视频学习潜在动作表征进行自监督预训练。该方法支持跨任务与跨本体迁移,在LIBERO基准及真机实验中性能优于Ground-Truth动作预训练模型,且具备低算力部署优势。
Whole-Body Bilateral Teleoperation with Multi-Stage Object Parameter Estimation for Wheeled Humanoid Locomanipulation
提出物体感知全身双边遥操作框架,融合视觉尺寸估计与VLM先验进行在线惯性参数辨识。在自定义轮式人形机器人上验证,支持实时举升搬运约1/3自重负载,显著提升力反馈同步性与操作跟踪精度。
IRL-VLA: Training an Vision-Language-Action Policy via Reward World Model
针对VLA模型开环模仿学习性能受限及闭环仿真低效痛点,提出IRL-VLA框架。通过逆强化学习构建轻量级奖励世界模型并结合PPO优化,在NAVSIM v2端到端驾驶基准获SOTA,并斩获CVPR2025自动驾驶挑战赛亚军。
CO-RFT: Efficient Fine-Tuning of Vision-Language-Action Models through Chunked Offline Reinforcement Learning
针对VLA模型微调难题提出CO-RFT算法,结合动作分块与离线强化学习。仅需30至60条演示数据,实测任务成功率提升57%,循环时间缩短22.3%,未见位置泛化率达44.3%。
CHILD (Controller for Humanoid Imitation and Live Demonstration): a Whole-Body Humanoid Teleoperation System
针对人形机器人缺乏全身关节级遥操难题,CHILD系统集成自适应力反馈与直接关节映射,支持四肢同步控制及移动操作。该紧凑型硬件设计已开源,并在人形与双臂系统验证了复杂任务能力,显著降低具身数据采集门槛。
A Survey on Vision-Language-Action Models: An Action Tokenization Perspective
arXiv最新综述提出以动作Token化统一VLA模型框架,将现有研究归纳为语言描述、代码、功能可供性、轨迹、目标状态、隐式表征、原始动作及推理八类Token范式,系统剖析各类表征优劣并指明具身智能通用化演进方向。
TACT: Humanoid Whole-body Contact Manipulation through Deep Imitation Learning with Tactile Modality
研究提出TACT策略,融合关节、视觉与触觉多模态输入,通过模仿学习解决人形机器人全身接触操控难题。真机验证表明该方案使RHP7 Kaleido在保持平衡行走的同时完成大面积精细接触任务,显著提升操作鲁棒性。
From Intention to Execution: Probing the Generalization Boundaries of Vision-Language-Action Models
研究发布包含50个仿真任务的统一评测套件,系统评估主流VLA模型。结果显示VLM骨干赋予模型良好意图与规划能力,但在分布外观测下动作执行显著失效,且动作微调会侵蚀原始推理能力,代码已开源。
CLONE: Closed-Loop Whole-Body Humanoid Teleoperation for Long-Horizon Tasks
针对人形机器人遥操作上下肢解耦与开环漂移痛点,CLONE系统基于MoE架构与MR头显追踪实现全身协调控制。通过实时闭环误差校正,在长轨迹任务中保持极低位置漂移,支持地面拾取等复杂动作,确立长时程交互数据采集新基准。
SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics
针对大参数VLA部署难痛点,提出SmolVLA小参数视觉语言动作模型。支持单GPU训练与消费级硬件推理,引入异步推理栈解耦感知执行,性能对标10倍参数量模型,全量开源代码、权重及社区数据集。
ChatVLA-2: Vision-Language-Action Model with Open-World Embodied Reasoning from Pretrained Knowledge
针对VLA微调丧失通用能力痛点,提出ChatVLA-2混合专家模型及两阶段训练管线。实验验证其在未显式训练下具备数学解题、OCR及新物体空间推理能力,综合性能显著优于OpenVLA、DexVLA及pi-zero等SOTA模仿学习方法。
Heavy lifting tasks via haptic teleoperation of a wheeled humanoid
研究提出面向轮式人形机器人的动态移动操作遥操作框架,通过全身运动重定向与实时触觉反馈闭环,验证了2.5kg(占本体质量21%)重物的动态举升与搬运能力,解决了负载扰动下的平衡控制难题。
PartDexTOG: Generating Dexterous Task-Oriented Grasping via Language-driven Part Analysis
提出PartDexTOG方法,通过LLM解析物体部件功能并引导扩散模型生成灵巧抓取。在OakInk-shape数据集上P-FID指标较SOTA提升41.43%,有效解决新类别与多任务下的灵巧手抓取泛化难题。
Unveiling the Potential of Vision-Language-Action Models with Open-Ended Multimodal Instructions
针对现有VLA模型仅依赖文本指令的局限,研究提出OE-VLA架构,支持图像、视频、白板文字等多模态开放指令输入。实验验证其在保持语言任务性能的同时,成功覆盖四类非文本交互场景,显著拓展具身智能应用边界。
TWIST: Teleoperated Whole-Body Imitation System
TWIST系统通过RL+BC混合策略与未来帧特权信息,实现人形机器人单一神经网络下的全身协调遥操作。该系统整合MoCap数据重定向与自适应控制器,突破传统局部任务限制,支持全身操作、足式操作及表达性运动等多模态技能统一执行。
$π_{0.5}$: a Vision-Language-Action Model with Open-World Generalization
VLA模型π0.5通过异构任务联合训练融合多源数据,首次验证端到端系统在全新家庭环境中执行厨房清洁等长程灵巧操作的能力,证实跨域知识迁移对开放世界泛化的关键作用。
Adversarial Locomotion and Motion Imitation for Humanoid Policy Learning
针对人形机器人全身协调难题,提出ALMI对抗学习框架,解耦上下身策略并在Unitree H1实机验证。同步开源MuJoCo高质量全身运动数据集,支持从仿真到真机的稳定部署与遥操作扩展。
Humanoid Agent via Embodied Chain-of-Action Reasoning with Multimodal Foundation Models for Zero-Shot Loco-Manipulation
提出Humanoid-COA框架,通过具身动作链机制将多模态大模型推理转化为结构化动作序列,在Unitree H1-2与G1上实现零样本移动操作,显著优于现有基线并支持长程非结构化任务。
DexTOG: Learning Task-Oriented Dexterous Grasp with Language
提出语言引导扩散学习框架DexTOG及8万条数据集DexTOG-80K,解决灵巧手高自由度空间下任务导向抓取的非唯一最优解难题,确立多任务灵巧操作新基准。
CoT-VLA: Visual Chain-of-Thought Reasoning for Vision-Language-Action Models
针对现有VLA模型缺乏时序规划难题,提出CoT-VLA方法。该7B参数模型通过自回归预测未来帧作为视觉目标并生成动作序列,在真实机器人操作中较SOTA提升17%,仿真基准提升6%,显著增强复杂任务推理能力。
GR00T N1: An Open Foundation Model for Generalist Humanoid Robots
NVIDIA发布开源人形机器人基座模型GR00T N1,采用双系统VLA架构联合训练。该模型在仿真基准测试中超越现有模仿学习SOTA,并在傅利叶GR-1本体上实现语言驱动双臂操作,验证了异构数据下的高数据效率与泛化能力。
HybridVLA: Collaborative Diffusion and Autoregression in a Unified Vision-Language-Action Model
针对VLA模型动作预测离散化或推理割裂痛点,提出统一框架HybridVLA。通过协同训练将扩散去噪融入Next-token预测,并设计自适应集成机制,在仿真与真机任务中平均成功率分别提升14%和19%,实现未见配置下的稳定操作。
RoboDexVLM: Visual Language Model-Enabled Task Planning and Motion Control for Dexterous Robot Manipulation
针对协作机械臂配灵巧手场景,提出RoboDexVLM框架。集成VLM任务级恢复机制与语言引导抓取感知算法,支持自然语言指令下的零样本开放词汇操作,验证了长程复杂任务执行的有效性与鲁棒性,项目已开源。
Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success
研究提出OpenVLA-OFT微调策略,通过并行解码与动作分块等优化,在LIBERO基准测试中将平均成功率从76.5%提升至97.1%,推理吞吐提高26倍。该方案在双臂ALOHA机器人上超越π0、RDT-1B及Diffusion Policy等主流模型。
Diffusion Trajectory-guided Policy for Long-horizon Robot Manipulation
针对长程机器人操作中模仿学习误差累积难题,提出扩散轨迹引导策略(DTP)。该方法利用扩散模型生成2D轨迹指导策略学习,在CALVIN基准上较SOTA基线成功率提升25%,且无需外部预训练即可显著改善真机表现。
DOGlove: Dexterous Manipulation with a Low-Cost Open-Source Haptic Force Feedback Glove
针对灵巧手遥操作高成本与感知缺失痛点,研究提出DOGlove系统。该手套造价低于600美元,集成21-DoF动捕、5-DoF力反馈及触觉致动器,支持无视觉任务执行与模仿学习策略训练,软硬件全开源。
A Unified and General Humanoid Whole-Body Controller for Versatile Locomotion
提出HugWBC通用全身控制器,通过通用指令空间与对称损失训练,使仿真策略迁移至真机。支持行走、跳跃等可变参数步态及上身实时干预,验证了高跟踪精度与鲁棒性,解决单一运动模式局限。
Learning to Transfer Human Hand Skills for Robot Manipulations
提出基于联合运动流形的数据驱动重定向方法,通过生成伪监督三元组映射人手、物体与机器人3D运动,解决具身差异。真机实验验证其在灵巧操作任务中显著优于传统运动学重定向技术。
Mobile-TeleVision: Predictive Motion Priors for Humanoid Whole-Body Control
提出PMP框架解耦人形机器人上下肢控制,利用CVAE编码上肢运动先验作为RL下肢策略条件输入。实验证实该方案在保持稳健行走的同时,高精度操作性能显著优于传统端到端RL全身控制,支持远程遥操作探索与作业。
Navigation World Models
研究提出10亿参数导航世界模型NWM,基于条件扩散Transformer预测未来视觉观测。该模型支持在熟悉环境动态约束规划及陌生环境单图轨迹想象,验证了生成式视频模型作为具身导航规划器的可行性。
DimensionX: Create Any 3D and 4D Scenes from a Single Image with Controllable Video Diffusion
提出DimensionX框架,通过ST-Director解耦视频扩散模型时空因子,实现单图到3D/4D场景的可控生成。引入轨迹感知与身份保持策略,解决生成视频与真实场景对齐难题,在多项数据集上验证了优于现有方法的生成质量与可控性。
The Role of Domain Randomization in Training Diffusion Policies for Whole-Body Humanoid Control
基于IsaacGym仿真验证,扩散策略虽能实现人形机器人稳定行走,但相比操作任务,其运动控制训练对数据集规模与多样性要求显著更高,域随机化是生成有效合成示教数据的关键前置条件。
EgoMimic: Scaling Imitation Learning via Egocentric Video
EgoMimic提出全栈模仿学习框架,通过Project Aria眼镜采集人体数据并联合训练。实验表明增加1小时人手数据比等量机器人数据更具价值,在长程双臂任务中显著优于SOTA方法并实现新场景泛化。
$π_0$: A Vision-Language-Action Flow Model for General Robot Control
提出π0视觉-语言-动作流匹配模型,继承互联网语义知识并支持单双臂及移动操作平台。验证了零样本执行、语言指令跟随及微调新技能能力,覆盖叠衣、清洁与装配等复杂灵巧任务,为通用机器人策略提供新范式。
Generalizable Humanoid Manipulation with 3D Diffusion Policies
研究构建含遥操作与25-DoF本体的系统,改进3D Diffusion Policy算法。仅凭单场景数据与板载算力,经2000+次真机验证,实现全尺寸人形机器人在多类真实场景下的自主泛化操作。
MuxHand: A Cable-driven Dexterous Robotic Hand Using Time-division Multiplexing Motors
提出MuxHand灵巧手,采用时分复用电机机制以4个电机独立控制9根缆绳,显著降本并保持高灵巧度。集成磁吸关节增强抗冲击与自复位能力,实验验证指尖负载达1.0kg,可实现稳健抓取与精细操作。
Wheeled Humanoid Bilateral Teleoperation with Position-Force Control Modes for Dynamic Loco-Manipulation
研究提出位力控制模式切换的双边遥操作框架,通过躯干俯仰偏航映射及触觉反馈,使轮式人形机器人完成5-10.5kg重物插槽及人机协作搬运,验证了动态移动操作在复杂接触任务中的有效性。
DexGrasp-Diffusion: Diffusion-based Unified Functional Grasp Synthesis Method for Multi-Dexterous Robotic Hands
提出端到端扩散模型DexGrasp-Diffusion,集成MultiHandDiffuser与双重判别器,在MultiDex数据集上验证了多灵巧手功能抓取生成的成功率、多样性及物理合理性优于基线模型。
Mobility VLA: Multimodal Instruction Navigation with Long-Context VLMs and Topological Graphs
提出分层Vision-Language-Action架构Mobility VLA,利用长上下文VLM解析演示视频与多模态指令定位目标帧,结合离线拓扑图生成底层动作。在836m²真实环境中验证,成功解决手持物体等复杂语义导航任务,端到端成功率显著优于基线。
OmniH2O: Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning
提出以运动学位姿为通用接口的人形机器人控制系统,支持VR、语音及RGB多模态输入。构建Sim-to-Real流水线并开源含6类任务的OmniH2O-6数据集,验证了从遥操作演示到全自主执行的技能迁移能力。
OpenVLA: An Open-Source Vision-Language-Action Model
OpenVLA发布7B参数开源VLA模型,基于97万真实机器人数据训练。在29项任务中绝对成功率超55B闭源RT-2-X达16.5%,微调性能优于Diffusion Policy 20.4%,支持消费级GPU低秩适配与量化部署。
RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots
面向通用机器人训练的RoboCasa仿真框架开源,集成150+类别3D资产与100项厨房任务。实验证实合成数据在模仿学习中呈现显著Scaling趋势,有效支撑Sim-to-Real迁移,解决真实数据采集瓶颈。
Octo: An Open-Source Generalist Robot Policy
基于Open X-Embodiment数据集80万条轨迹训练的Transformer通用策略Octo发布,支持语言与目标图像指令。实验验证其在9种平台上仅需数小时即可在消费级GPU上完成新传感器与动作空间适配微调。
Evaluating Real-World Robot Manipulation Policies in Simulation
针对通用操作策略真机评测难问题,提出SIMPLER仿真基准。通过缓解控制与视觉差异,验证了仿真与真机性能的强相关性,并开源全套环境与构建工作流,支持分布偏移敏感性分析。
DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset
DROID数据集发布7.6万条演示轨迹与350小时交互数据,覆盖亚欧美564场景84任务。验证表明该数据显著提升操作策略性能与泛化能力,全套数据、训练代码及硬件复现指南已开源。
Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation
提出基于强化学习的H2O框架,仅用单目RGB相机即可实现全尺寸人形机器人实时全身遥操作。通过Sim-to-Data流程构建大规模重定向运动数据集,训练出的策略可零样本迁移至真机,支持行走、后跳、踢腿等动态动作。
3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations
提出3D Diffusion Policy(DP3),利用稀疏点云紧凑表征结合扩散模型。仿真72任务10次演示相对提升24.2%,真机4任务40次演示成功率达85%,具备空间与实例泛化能力且安全性显著优于基线,代码数据已开源。
Learning and Leveraging World Models in Visual Representation Learning
研究提出Image World Models(IWM),将JEPA从掩码预测扩展至潜空间全局光度变换预测。实验证实条件化、预测难度与模型容量是训练关键,微调后性能匹配或超越现有自监督方法,且支持控制表征抽象层级。
Expressive Whole-Body Control for Humanoid Robots
提出Exbody全身控制策略,通过解耦上肢模仿与下肢速度跟踪解决动捕数据迁移难题。经仿真训练与Sim2Real验证,该策略使真机具备多风格行走、握手及人机共舞能力,证实了图形学动捕数据在具身控制中的有效性。
Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots
UMI框架通过手持夹持器与相对轨迹动作表示,解决野外示教数据到机器人策略的迁移难题。支持双手动态操作零样本泛化,具备推理延迟匹配与硬件无关性,软硬件系统已完全开源。
Adaptive Motion Planning for Multi-fingered Functional Grasp via Force Feedback
提出基于深度强化学习的多指手自适应运动规划方法,利用关节扭矩实时感知物体位置并动态调整抓取轨迹。实验证实力反馈闭环控制显著提升操作精度与适应性,实现类人灵巧抓取。
Dynamically Reprogrammable Stiffness in Gecko-Inspired Laminated Structures
研究提出基于仿壁虎干粘附的可逆层压技术,实现铰链刚度被动保持与动态重编程。实验刚度调制比达14.4,仿真预测超73,状态切换仅需约1s静电或磁驱动,显著降低机器人变刚度机构能耗与设计复杂度。
Vision-Language Foundation Models as Effective Robot Imitators
基于OpenFlamingo构建的RoboFlamingo框架,通过解耦单步视觉语言理解与显式策略头时序建模,仅用语言条件操作数据微调即可超越SOTA。该方案支持开环控制与低算力平台部署,为VLM适配机器人操控提供低成本范式。
MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations
MimicGen系统通过上下文适配,仅用约200条人类演示自动生成超5万条机器人操作数据,覆盖18类任务。实验证实合成数据在长时序装配等任务中训练效果优于人工采集,显著降低具身学习数据成本。
Finetuning Offline World Models in the Real World
针对强化学习数据效率低痛点,提出FOWM框架结合离线预训练与在线微调。通过测试时规划正则化平衡回报与认知不确定性,在仿真及真机视觉运动控制任务中验证了有限离线数据下的少样本迁移能力,代码与数据集已开源。
Open X-Embodiment: Robotic Learning Datasets and RT-X Models
21家机构联合发布Open X-Embodiment数据集,涵盖22种机器人、527项技能及16万任务。基于此训练的RT-X模型验证了跨本体正迁移能力,为具身智能通用策略研究提供标准化数据基准与预训练范式。
DELTAHANDS: A Synergistic Dexterous Hand Framework Based on Delta Robots
研究提出DELTAHANDS协同灵巧手框架,利用Delta并联机构实现高自由度与低控制复杂度平衡。系统采用低成本现货材料制造,支持构型重配与驱动协同,成功验证衣物折叠、开盖及理线等遥操作任务,全套设计已开源。
RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
提出VLA架构RT-2,将机器人动作编码为文本Token与互联网数据联合微调。6000次评估证实模型具备新物体泛化、未见指令解析及链式思维推理能力,验证了Web知识向具身控制迁移的有效性。
Whole-Body Dynamic Telelocomotion: A Step-to-Step Dynamics Approach to Human Walking Reference Generation
研究提出步到步动力学方法解决人形机器人遥操作鲁棒性难题,通过虚拟接口嵌入双足欠驱动特性生成动态一致步态。仿真验证操作员可同步控制机器人以0-0.3m/s速度持续行走及2米后退,实现全身动态遥 locomotion。
Dynamic Mobile Manipulation via Whole-Body Bilateral Teleoperation of a Wheeled Humanoid
论文提出基于SATYRR双轮人形机器人的动态移动操作(DMM)全身遥操作框架,通过降阶模型映射与触觉反馈,实现抓取0.4m/s移动目标及推动105%自重箱体,验证了轮式人形在重载动态任务中的有效性。
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
研究提出Action Chunking with Transformers (ACT)算法,解决低成本机器人双臂精细操作难题。仅凭10分钟遥操作演示数据,该系统在穿扎带、插电池等6项高难度任务中实现80-90%成功率,验证了端到端模仿学习在低精度硬件上的有效性。
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
论文提出将机器人视运动策略建模为条件去噪扩散过程,在4大基准12项任务中较SOTA方法平均提升46.9%。通过引入滑动时域控制、视觉条件化及时间序列扩散Transformer,有效解决多模态动作分布与高维空间难题,代码数据已开源。