
外观
Skip to content
 smolvla_basehugging-face/lerobot-smolvla-base22 天前openvla-7bopenvla/openvla-7b8 个月前
 GR00T-N1.7-3Bnvidia/gr00t-n1-7-3b6 个月前smolvla_liberoHuggingFaceVLA/smolvla_libero2025-09-17pi05_libero_finetuned_v044hugging-face/lerobot-pi05-libero-finetuned-v04422 天前smolvla_liberohugging-face/lerobot-smolvla-libero16 天前
概述
这个模型的核心架构、动作空间设计与真机部署定位。
该模型属于VLA(视觉-语言-动作)家族,主干采用SigLIP与DINOv2作为视觉编码器、Llama 2 7B作为核心推理架构,参数量为7B,输入模态覆盖视觉、语言信号,动作空间以离散动作token表示,每维度含256个bins,控制频率为10Hz。
其基于Open X-Embodiment数据集的970k条机器人轨迹完成预训练,支持RLDS数据格式,代码采用MIT开源协议发布,模型权重继承Llama 2 Community License许可,当前处于研究阶段,可用于机器人具身控制相关的技术探索与落地适配。
关键参数与架构规格
参数量、网络主干、控制频率、显存需求及 Hugging Face Hub 统计。
- 参数量
- 7B
- 微调显存需求
- 72GB
- 闭环控制频率
- 10Hz
- 网络架构
- SigLIP+DINOv2 视觉编码 → Llama 2 7B,离散动作 token(每维 256 bins)
- 动作空间表示
- discrete_tokens
- 支持数据格式
- RLDS
公开基准跑分
分数来自 taxonomy/benchmarks.yaml,只展示已关联到本模型的条目。
| 基准 | 平均 | 协议 | 出处 |
|---|---|---|---|
| LIBERO | 76.5% | third-person image + language, modified dataset, original discrete-token fine-tune | OpenVLA LIBERO table(OFT Table I 复引同一行) |
| SimplerEnv Google Robot Visual Matching | 34.3% | CogACT's OpenVLA visual-matching eval; do not mix with SpatialVLA Table VIII | CogACT Table 1, OpenVLA row |
| SimplerEnv Google Robot Variant Aggregation | 39.3% | variant aggregation | CogACT Table 1, OpenVLA variant aggregation |
| SimplerEnv WidowX Visual Matching | 4.2% | WidowX visual matching | CogACT Table 2, OpenVLA row |
| SimplerEnv Google Robot Visual Matching (SpatialVLA overall) | 27.7% | SpatialVLA | SpatialVLA Table VIII, OpenVLA visual matching overall |
| SimplerEnv Google Robot Variant Aggregation (SpatialVLA overall) | 39.8% | SpatialVLA | SpatialVLA Table VIII, OpenVLA variant aggregation overall |
快速部署与许可说明
开源许可证、权重拉取命令、预训练数据集与关联文章。
代码许可证
MIT
权重许可证
继承 Llama 2 Community License
权重下载与策略推理参考
# 1. 使用 Transformers 加载 OpenVLA 视觉语言动作模型
from transformers import AutoModelForVision2Seq, AutoProcessor
import torch

processor = AutoProcessor.from_pretrained("embodied-ai/openvla", trust_remote_code=True)
vla = AutoModelForVision2Seq.from_pretrained("embodied-ai/openvla", torch_dtype=torch.bfloat16, low_cpu_mem_usage=True, trust_remote_code=True).to("cuda:0")
# 2. 输入相机图像与自然语言指令预测 7-DoF 动作增量
inputs = processor("In: What action should the robot take to pick up the object?\nOut:", image).to("cuda:0", dtype=torch.bfloat16)
action = vla.predict_action(**inputs, unnorm_key="bridge_orig", do_sample=False)
预训练数据 1
相关文章与评测 6
关联机型
模型卡或论文声明在这些机器人上训练、微调或部署过;口径是作者声明,不是第三方复现。
机型关联记录 3
| 适配机型 | 实测说明与帧率表现 | 记录日期 |
|---|---|---|
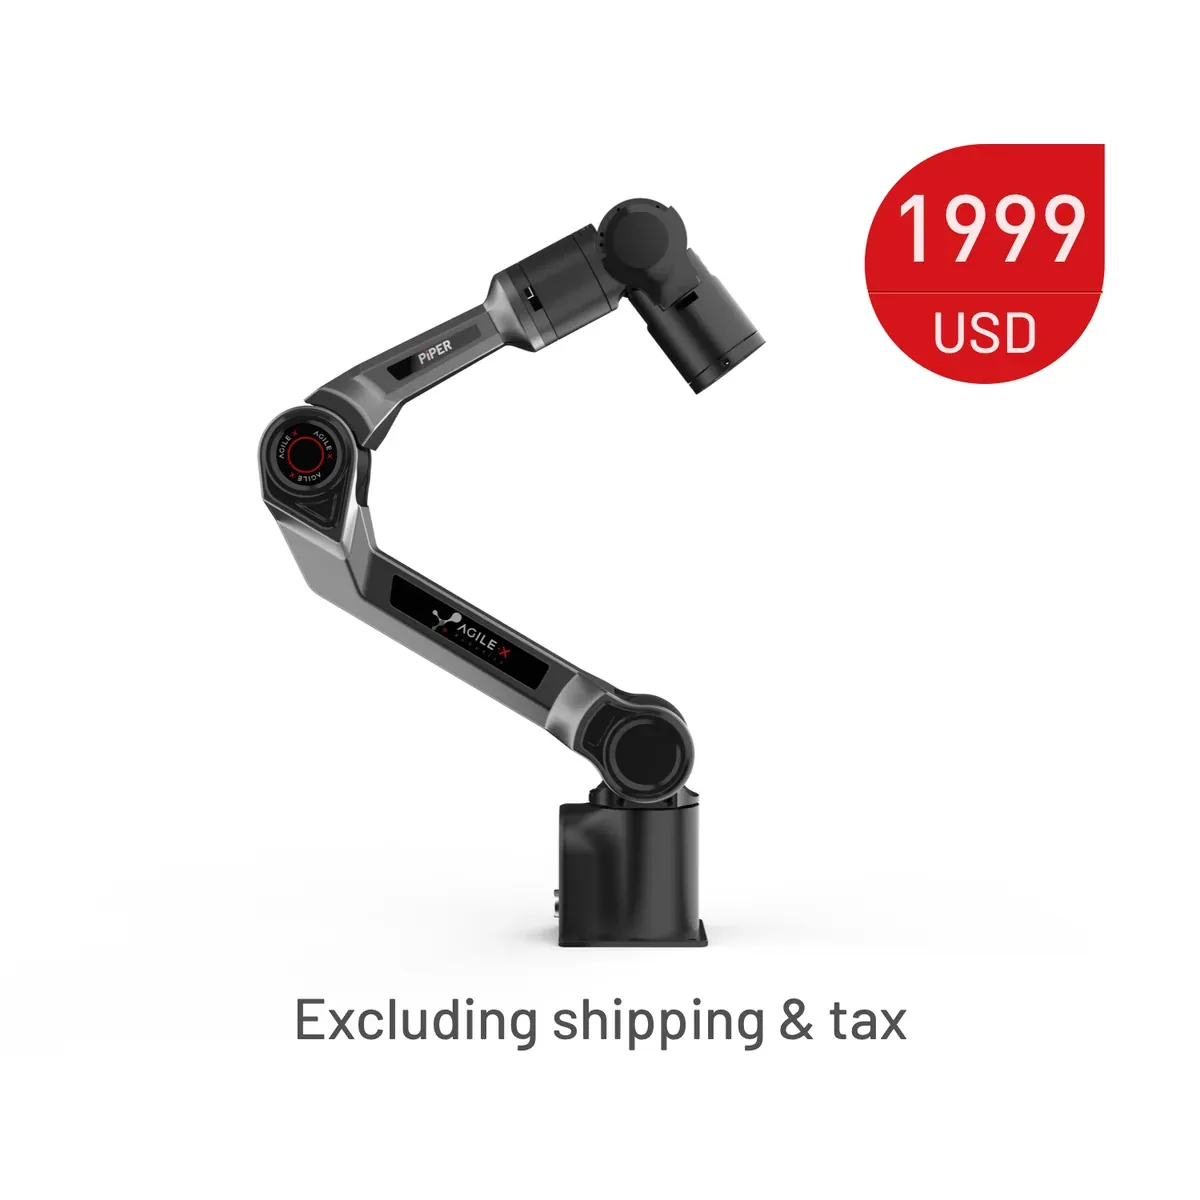
| 松灵 PiPER | OpenVLA 7B 支持通过 LoRA 微调适配松灵 PiPER 6DoF 机械臂桌面抓取任务。 | 2026-10-21 |
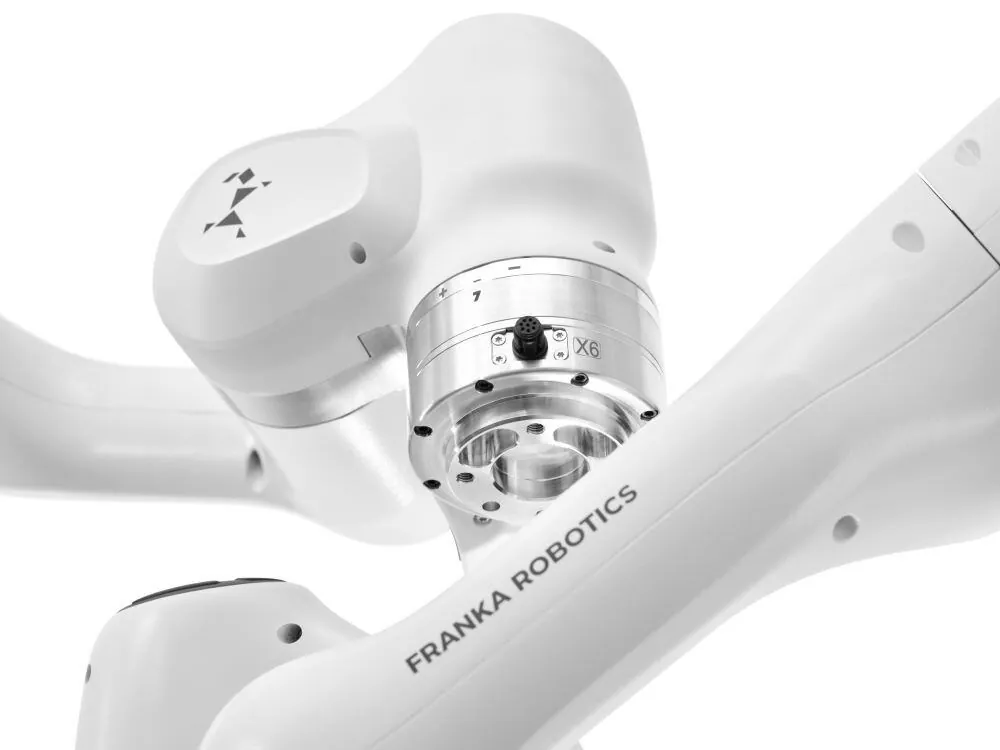
| Franka FR3 | OpenVLA 7B 基于 Open X-Embodiment 97 万条轨迹预训练,原生支持 Franka 7DoF 末端增量位姿控制与 LoRA 微调。 | 2026-10-21 |
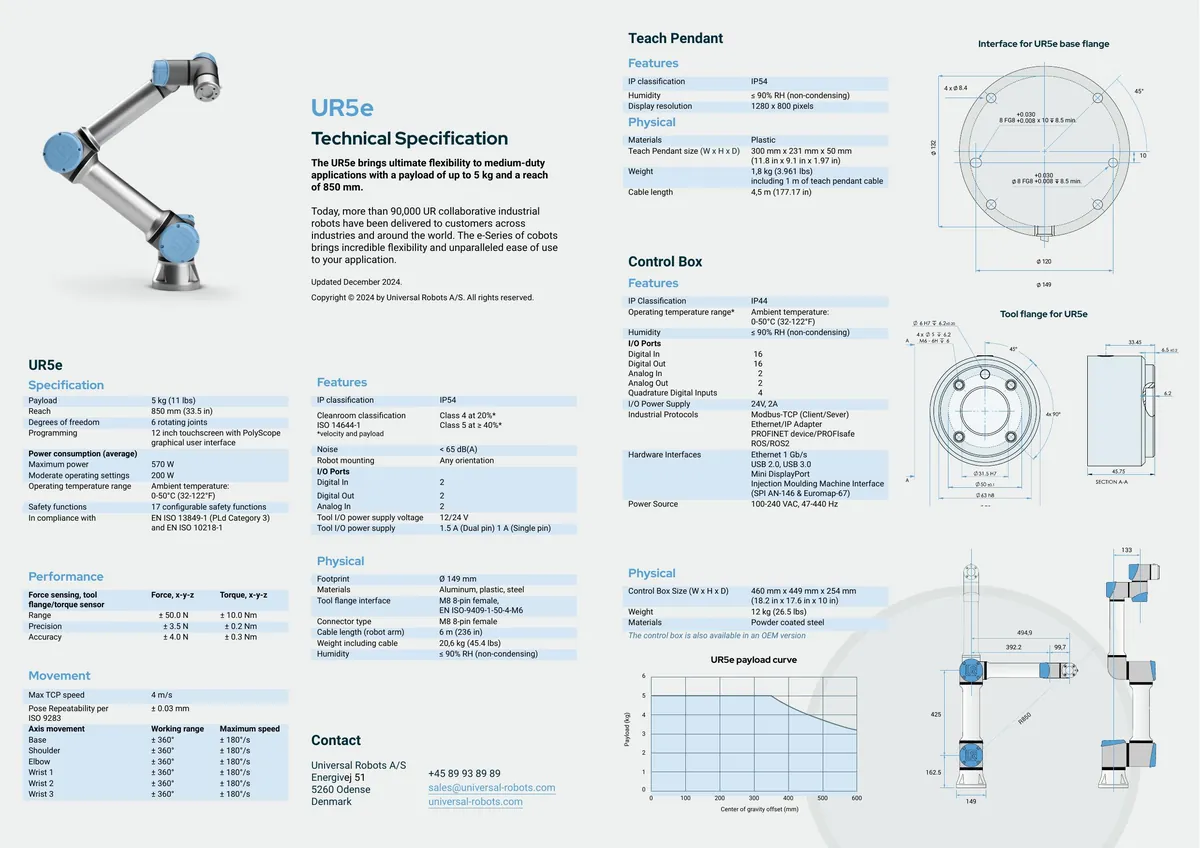
| Universal Robots UR5e | OpenVLA 7B 预训练包含 UR5 轨迹,支持通过 ROS 2 MoveIt/Servo 桥接部署至 UR5e。 | 2026-10-21 |



同家族模型
同一家族里的热门模型。
smolvla_basehugging-face/lerobot-smolvla-base22 天前openvla-7bopenvla/openvla-7b8 个月前GR00T-N1.7-3Bnvidia/gr00t-n1-7-3b6 个月前smolvla_liberoHuggingFaceVLA/smolvla_libero2025-09-17pi05_libero_finetuned_v044hugging-face/lerobot-pi05-libero-finetuned-v04422 天前smolvla_liberohugging-face/lerobot-smolvla-libero16 天前来源
本页事实对应的公开页面,以原文为准。
- OpenVLA访问 2026-10-10
- Open Robot Foundation Models Compared访问 2026-10-10