
外观
解读aws.amazon.com14 天前
AWS 开源 Physical AI Toolchain:把 NVIDIA 机器人训练与仿真栈搬上云,GR00T 完整微调 11 小时预估 $79
一分钟速览
- 这不是新模型,而是云端工程胶水:AWS 以 Apache 2.0 许可证开源了
sample-the-physical-ai-toolchain-on-aws仓库,用 Terraform、CDK 和部署脚本把 NVIDIA 机器人软件栈(GR00T、Isaac Sim、Isaac Lab、Cosmos、OSMO)映射到 SageMaker、AWS Batch、EKS 和 EC2 上。 - 开箱自带 27 条 UR3 抓取演示与预估价目:仓库内置 UR3 机械臂配 Robotiq 2F-85 夹爪的 27 条真实遥操作轨迹;在
ml.g5.12xlarge上跑 15 min 的 GR00T 冒烟测试预估~$2,跑 11 hrs 的完整微调预估~$79(本站按官方预估数计算,时长为 44.0 倍,标价为 39.5 倍)。 - 本地 MuJoCo 仿真环路免云费:控制面的
strands-agents-on-aws组件默认拉起本地 MuJoCo 仿真,不需要 GPU、真机或 AWS 账号就能用自然语言驱动so100或so101机械臂,但托管版 Bedrock AgentCore 运行时仍标为 Planned。 - 新闻稿与代码仓库存在明显断层:About Amazon 新闻稿把 Edge Deployment 列为五大支柱之一,仓库 README 的选型表也指导开发者调用
jetson-edge-deployment;但组件状态表里 Edge Deployment 明确标为 Planned,且仓库根目录下根本不存在jetson-edge-deployment文件夹。
材料说明
本文材料来自 AWS 于 2026-10-07 发布的官方技术博文、2026-10-08 发布的 About Amazon 新闻稿,以及 GitHub 仓库 aws-samples/sample-the-physical-ai-toolchain-on-aws(含根目录 README、strands-agents-on-aws 子目录 README、LICENSE 与仓库目录树)。仓库中的耗时与美元金额均为 AWS 提供的粗略预估(原文均带 ~),并非实测账单;材料包不包含任何机器人任务成功率基准,目前也没有第三方独立复现报告。文中涉及的训练时长倍数与标价倍数由本站根据 README 预估表计算并明确标注。
- ~$2 vs ~$79 同一台
ml.g5.12xlarge上 GR00T 冒烟测试(15 min)与完整训练(11 hrs)的官方预估花费,本站计算时长相差 44.0 倍、标价相差 39.5 倍 - 4096 个 Isaac Lab 在单张 GPU 上同时运行的并行强化学习仿真环境数量
- 27 条 仓库随附的 UR3 协作机械臂配 Robotiq 2F-85 夹爪真实遥操作拾放(pick-and-place)演示轨迹
- 零云端费用
strands-robots默认本地 MuJoCo 仿真路径的云资源开销,无需 GPU 与物理硬件即可跑通控制闭环
它不是新模型,而是把 NVIDIA 机器人栈绑上 AWS 的工程胶水
把机器人从实验室原型推向生产系统,最耗时间的往往不是改模型结构,而是跨阶段搬运数据和算力。训练一个能在杂乱仓库里以 200 Hz 频率控制 6-axis arm(六轴机械臂)的策略,光靠离线评估指标高没有用,必须打通数据采集、合成数据扩增、模型训练、物理仿真验证和边缘部署。
AWS 在 2026-10-07 推出的 Physical AI Toolchain on AWS(仓库 aws-samples/sample-the-physical-ai-toolchain-on-aws),定位很明确:它不发明新的具身基础模型,也不直接交付现成的机器人动作技能,而是提供一套参考架构、基础设施即代码(IaC,用代码模板自动创建云资源)和部署自动化脚本,把 NVIDIA 的 Physical AI 软件栈搬到 AWS 托管服务上运行。
AWS 博文指出了传统机器学习运维(MLOps)在物理 AI 场景下失效的五个具体工程痛点:
- 算力异构(Compute heterogeneity):单条工作流横跨三类硬件——基础模型预训练与微调需要高带宽 GPU 集群,物理仿真与软件在环(SIL,把控制软件放进虚拟仿真里做闭环测试)需要弹性中端 GPU,机上实时推理依赖边缘端 GPU(NVIDIA Jetson Thor / AGX)。没有单一云服务能同时覆盖这三头。
- 产物蔓延(Artifact sprawl):一次机器人发布同时牵扯数据集、仿真场景、URDF(统一机器人描述格式,定义连杆和关节几何关系的 XML 文件)、标定参数、训练容器、权重检查点(checkpoint)、评测输出和边缘部署包。缺乏跨阶段产物管理,几周内就会丢失可复现性。
- 验证深度(Validation depth):机械臂在真实世界里一旦执行失败,重启面对的是已被碰乱的物理现场,无法像网页服务那样做简单的蓝绿发布,必须依次通过仿真、受控真机测试和分阶段上线。
- 数据经济性(Data economics):真机遥操作数据采集昂贵,生产级策略需要覆盖成百上千种环境变化,必须靠合成数据扩增和强化学习放大稀疏的人类演示。
- 控制链路位置(Control path placement):决定物理运动的推理受限于延迟、功耗和机载散热。云端负责训练与车队管理,但安全相关的实时控制闭环必须在边缘端完成。
以前自己搭云端管线
- 每个阶段各自写脚本:采集完 Zarr 或 ROS bag 数据手工转格式、手工传存储桶。
- 跑仿真、强化学习和视觉-语言-动作模型(VLA,输入图像和语言指令、输出动作控制的模型)微调要分别配 EC2 实例、容器镜像和权限。
- 跨阶段交接靠人工拷权重,拉起环境动辄耗掉数周底层运维时间。
用这套参考工具链
- 每个环节封装成独立 Terraform 模块或 CDK 栈,通过 AWS SSM 参数共享基础配置,按需单独部署或串成飞轮。
- 容器镜像交给 AWS CodeBuild 在云端构建,本地不需要装 Docker。
- 数据统一转成社区通用的 LeRobot v2 格式进 Amazon S3,训练与仿真映射到 SageMaker、AWS Batch 和 EKS。
AWS Industries 副总裁 Uwem Ukpong 在 About Amazon 新闻稿中称,客户太多工程精力耗在了基础设施而非创新上,这套开源工具链的目标就是省掉花在环境搭建和阶段交接上的时间。
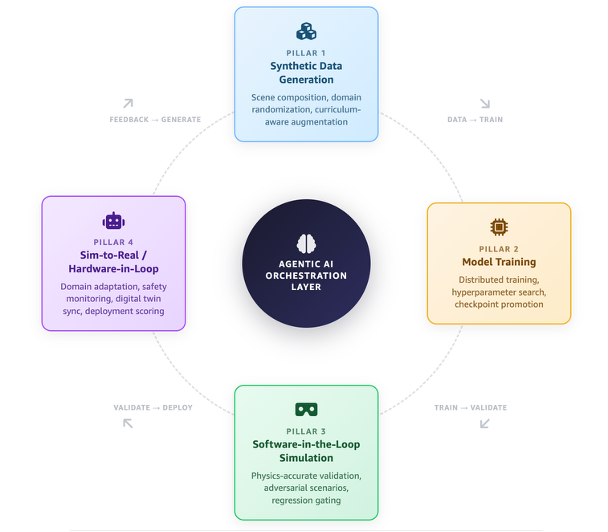 图片来源:GitHub
sample-the-physical-ai-toolchain-on-aws 仓库(Apache-2.0)。图中展示了合成数据生成、模型训练、SIL 仿真和 Sim-to-Real / HIL 四个支柱及中心的智能体编排层。注意第四支柱中的边缘部署模块在当前仓库中仍标为 Planned。
组件表里八项可用、一项预览,边缘部署还在画饼
拆开仓库根目录,这套工具链由十个按功能切分的模块组成。除 DreamZero 微调使用 AWS CDK 并指向独立仓库 sample-dreamzero-finetuning-on-sagemaker 外,其余云端模块均用 Terraform 编写,存放在对应子目录的 infra/ 或 001-iac/ 下。
下表完整还原了仓库 README 中的组件清单(Toolchain Components):
| 组件名称 | 功能描述与上游依赖 | 部署入口(Terraform / CDK) | 状态 |
|---|---|---|---|
| Foundation | 共享 S3 存储桶、ECR 镜像仓库、IAM 角色、VPC 与 SSM 参数 | foundation/infra/ | Available |
| Cosmos | NVIDIA Cosmos 世界生成(Predict V2V)与数据扩增(Transfer 2.5) | cosmos-on-aws/infra/ | Available |
| Isaac Lab | 基于 Isaac Lab 在 SageMaker + AWS Batch 上跑强化学习(4096 并行环境) | isaac-lab-on-aws/infra/ | Available |
| Isaac GR00T | 在 SageMaker + AWS Batch 上微调 NVIDIA GR00T N1.6 VLA 模型 | isaac-gr00t-on-aws/infra/ | Available |
| DreamZero | 在 SageMaker 上用 LoRA(低秩适应轻量化微调)微调 14B 世界动作模型 DreamZero,自动合并为可服务权重 | CDK 独立仓库 sample-dreamzero-finetuning-on-sagemaker | Available |
| Isaac Sim | 用于物理仿真的 NVIDIA Isaac Sim GPU 云工作站 | isaac-sim-on-aws/infra/ | Available |
| OSMO | 在 EKS 上部署 NVIDIA OSMO 6.3 编排平台(控制面、算力与 GPU 调度) | osmo-on-aws/001-iac/ | Available |
| Edge Deployment | 通过 EKS Hybrid Nodes + Greengrass 将模型打包推送至 Jetson | Planned(无入口) | Planned |
| Strands Agents | Strands Agents SDK + strands-robots 自然语言控制面(默认 MuJoCo 仿真,真机需显式开启;Bedrock AgentCore 托管运行时处于规划中) | (control plane) | Available |
| Isaac Lab Arena Evaluation | GR00T 闭环评测、检查点完整性校验与受控 SageMaker 注册 | isaac-lab-arena-on-aws/infra/ | Preview |
架构上,上层是五个垂直领域支柱,底层是横向编排层——包含负责异构算力与工作流调度的 NVIDIA OSMO 6.3,以及负责自然语言指令与策略闭环调度的 Strands Agentic Layer。
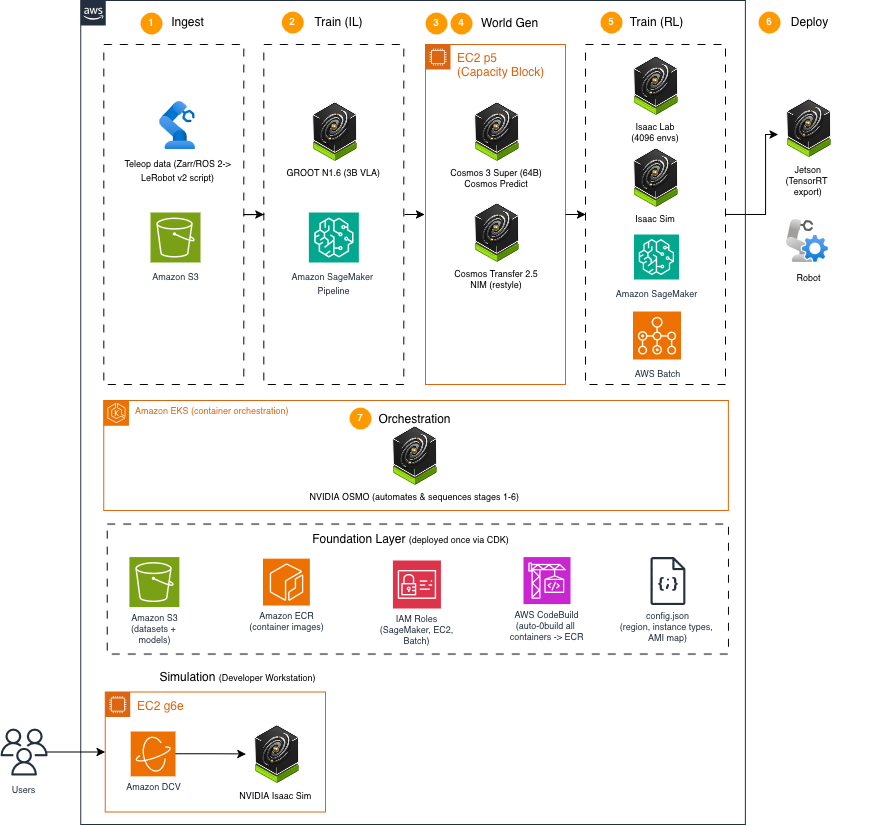 图片来源:GitHub
sample-the-physical-ai-toolchain-on-aws 仓库(Apache-2.0)。展示五个流水线阶段及其对应的 AWS 服务。注意第 5 阶段(Deploy 至 Greengrass)在当前组件表中尚未实现。
README 同时给出了飞轮各阶段与 AWS 算力、支撑服务的映射表(How It Maps to AWS):
| 飞轮阶段(Flywheel Stage) | AWS 计算服务(AWS Compute) | 支撑服务(Supporting Services) |
|---|---|---|
| Synthetic Data Generation | Amazon EC2(G6e / L40S、P5 / H100),运行于 EKS | Amazon S3、Amazon ECR、NVIDIA NGC |
| Model Training | Amazon SageMaker、AWS Batch(带 EFA 网络的 P5 / P6) | Amazon S3、Amazon FSx for Lustre |
| SIL Simulation | Amazon EC2(G6e GPUs),运行于 EKS | Amazon S3、Amazon CloudWatch |
| HIL / Edge Deployment | EKS Hybrid Nodes(Jetson、RTX 工作站) | AWS Site-to-Site VPN、AWS Direct Connect |
| Orchestration (OSMO) | Amazon EKS(系统节点) | Amazon RDS、ElastiCache、S3、Secrets Manager、KMS |
仓库支持两种接入方式:从零搭建平台或需要跨云、实验室与边缘多集群调度时,部署 osmo-on-aws 做全局 YAML 编排;已有 Kubeflow、Airflow 或 Argo Workflows 流水线的团队,则按需单独拉起 isaac-lab-on-aws、isaac-gr00t-on-aws 或 cosmos-on-aws。
从 27 条 UR3 遥操作轨迹出发,数据怎么在云上走完一圈
为了演示端到端闭环,仓库内置了一个工业拾放(pick-and-place,对应料箱拣选、零件配套和码垛)示例,采用 UR3 协作机械臂搭配标准 Robotiq 2F-85 二指夹爪,随库附带 27 条真实遥操作轨迹(episodes)。换用其他机器人时,只需替换自己的 URDF 和遥操作数据。
整条流水线按五个阶段推进:
- Ingest(数据摄取与标准化):输入遥操作采集的原始 Zarr、ROS bags 或 CSV 记录,统一转换为社区标准
LeRobot v2格式并存入Foundation创建的 Amazon S3 存储桶。 - Train — Imitation Learning(模仿学习微调):读取 S3 中的
LeRobot v2数据,在 SageMaker 或 AWS Batch 上用 PyTorch 与 Hugging Face 微调 NVIDIA GR00T N1.6 VLA 模型,或通过独立 CDK 仓库用 LoRA 微调 14B 参数的 DreamZero 世界动作模型并自动合并权重。产出的model.tar.gz回写 S3,可由Isaac Lab Arena Evaluation(Preview)做闭环评测与受控模型注册。 - World Generation(世界生成与合成数据扩增):在 EKS 或 EC2(G6e / L40S、P5 / H100)上运行
cosmos-on-aws,调用 Cosmos 3 Predict(Predict V2V)生成新合成演示,或用 Cosmos Transfer 2.5 对现有视频做风格重绘(restyle),扩增后的数据回流 S3 反哺训练。 - Train — Reinforcement Learning(大规模强化学习与仿真验证):任务基于 Gymnasium 定义,
isaac-lab-on-aws在单张 GPU 上开启 4096 个并行环境从零训练策略,并在 EC2(g6e.4xlarge)上的isaac-sim-on-aws工作站里做物理仿真验证,输出policy.pt或 ONNX 模型。 - Deploy(边缘导出与机上闭环):按架构设计,模型导出为 TensorRT 或 ONNX,经 AWS IoT Greengrass 推送到 NVIDIA Jetson Thor / AGX 硬件,交由机上
ROS 2执行实时控制;同时Strands Agents可拉取 S3 上的model.tar.gz或policy.pt在仿真孪生体或真机上验证并决定下一轮训练。但其中的 Greengrass + Jetson 部署模块目前仍在规划中。
同一台 ml.g5.12xlarge 上,完整训练比冒烟测试贵 39.5 倍
AWS 博文没有提价格,仓库根目录 README 则给出了九项带 ~ 的粗略预估成本表(Estimated Costs):
| 组件与工作负载 | 官方预估费用 | 机型配置与运行时长说明 | 计费形态 |
|---|---|---|---|
| GR00T training (smoke test) | ~$2 | ml.g5.12xlarge 运行 15 min | 单次训练作业 |
| GR00T training (full) | ~$79 | ml.g5.12xlarge 运行 11 hrs | 单次训练作业 |
| DreamZero fine-tune (smoke gate) | ~$10 | ml.g7e.24xlarge 运行 25 min | 单次训练作业 |
| DreamZero fine-tune (1000 steps) | ~$93 | ml.g7e.24xlarge 运行 4 h 11 m | 单次训练作业 |
| Isaac Lab RL training | ~$10-30 | ml.g5.xlarge 运行 2-4 hrs | 单次训练作业 |
| Cosmos 3 Predict | ~$37/hr | p5.48xlarge(Capacity Block 容量块) | 按小时计费 |
| Cosmos Transfer 2.5 | ~$8/hr | g6e.12xlarge(Spot 竞价实例) | 按小时计费 |
| OSMO (full deployment) | ~$5/hr | EKS + RDS + ElastiCache 全套控制面 | 按小时计费 |
| Isaac Sim workstation | ~$1.86/hr | g6e.4xlarge(空闲时停止) | 按小时计费 |
把单次训练总价与按小时费率放在一起重排(Isaac Lab RL training 取区间上限 30 与下限 10 分列),开销梯度如下:
对照表里的两组模型微调数据,可以算出从冒烟验证到完整训练的放大倍数:
- GR00T 微调:冒烟测试与完整训练都跑在
ml.g5.12xlarge上,前者 15 min 预估~$2,后者 11 hrs 预估~$79。本站按官方预估数计算,完整训练时长是冒烟测试的 44.0 倍(11 / (15/60)),预估标价是冒烟测试的 39.5 倍(79 / 2)。 - DreamZero 微调:冒烟门禁与 1000 steps 微调都跑在
ml.g7e.24xlarge上,前者 25 min 预估~$10,后者 4 h 11 m 预估~$93。本站按官方预估数计算,1000 steps 微调时长是冒烟门禁的 10.04 倍((4 + 11/60) / (25/60)),预估标价是 9.3 倍(93 / 10)。
真正容易在账单上超支的是按小时计费的服务:Cosmos 3 Predict 在 p5.48xlarge Capacity Block 上每小时预估 ~$37/hr,跑两个多小时就超过一次 11 hrs 的 GR00T 完整训练;OSMO 全套控制面(EKS + RDS + ElastiCache)即使不跑 GPU 任务也要 ~$5/hr。因此实验结束后必须用 terraform destroy 或 aws cloudformation delete-stack 销毁资源,闲置的 Isaac Sim workstation(~$1.86/hr)也应及时停机。
不开 AWS 账号也能跑:Strands 本地仿真环路与文档前后的机型错位
如果不想申请 AWS GPU 配额,仓库里的 strands-agents-on-aws/ 模块提供了一条零云端费用的本地控制路径。它基于 Strands Agents SDK 和 strands-robots,把仿真孪生体与真机统一封装在 Robot() 接口后:
python
from strands import Agent
from strands_robots import Robot

robot = Robot("so100")                       # 默认启动 MuJoCo 仿真;传入 mode="real" 才连接真机
Agent(tools=[robot])("pick up the red cube")  # 自然语言指令 -> 电机控制命令
默认调用 Robot("so100") 会在本地拉起 MuJoCo 仿真(no GPU, no hardware, no cloud cost),除非显式传入 mode="real",否则物理舵机绝不动作。通过命令行快速启动只需三步:
bash
pip install 'strands-agents' 'strands-robots[sim-mujoco]'
pai agent sim --robot so101 --task "pick up the red cube"
pai agent info --robot so101
核对 strands-agents-on-aws/README.md,有三个细节值得开发者留心:
- 代码与命令行的机型不一致:顶部 Python 示例写的是
Robot("so100"),下方 CLI 示例却用--robot so101,文档未说明两边型号不同的原因。 - 云端托管控制面尚未落地:虽然新闻稿和根 README 把
Amazon Bedrock AgentCore列为核心编排能力,但子模块状态表明确标注Bedrock AgentCore hosted runtime (pai agent deploy)和AWS IoT Core mesh bridge for fleets均为Planned,目前只有本地笔记本/工作站控制面可用。 - 机型数量未经本仓逐一核验:文档宣称支持
50+ robots, 8 categories并支持遥操作录制LeRobot v2数据集,但该数字仅见于说明文字,仓库内未提供50+款机型的测试清单。
新闻稿写五大支柱已就位,仓库里却找不到边缘部署目录
把 About Amazon 新闻稿、AWS 博文与 GitHub 仓库目录树对照核查,最明显的矛盾出在 Edge Deployment(边缘部署):
- About Amazon 新闻稿将
Edge Deployment列为五大核心支柱之一,声称通过 AWS IoT Greengrass 把优化模型推向现场机器;AWS 博文也写明最终阶段用 Greengrass 推送模型至 NVIDIA Jetson。 - GitHub 根目录 README 的选型表(
When to Use OSMO vs. Individual Tools)直接写着:已有流水线若只需边缘部署,请使用jetson-edge-deployment打包并推送模型。 - 但同一篇 README 的 组件表(
Toolchain Components) 中,Edge Deployment的部署入口与状态全部标为Planned。 - 核查仓库
main分支的 根目录清单(cdk、containers、cosmos-on-aws、docs、dreamzero-on-aws、foundation、isaac-gr00t-on-aws、isaac-lab-arena-on-aws、isaac-lab-on-aws、isaac-sim-on-aws、kubernetes、notebooks、osmo-on-aws、pai、scripts、strands-agents-on-aws、training、workflows、workshop),根目录下根本没有jetson-edge-deployment文件夹。
除边缘部署缺位外,材料核查还发现四处脱节与边界:
- 内部相对链接失效:
strands-agents-on-aws/README.md多次用../gr00t-training-on-aws/链接训练模块,但仓库真实目录名为isaac-gr00t-on-aws。 - 一手材料作者署名不一致:AWS 博文署名为
Ignacio Sánchez,而 GitHub README 作者列表(均为 AWS Solutions Architect)写的是Ignacio Salvar。 - 交付周期宣传无实测支撑:博文称从评估到跑通自有数据只需
hours rather than weeks,新闻稿则写weeks rather than the years,两边均无实测计时。 - 背景宣传数字不属于本工具链指标:About Amazon 提到的「AWS 与 NVIDIA 再部署
2 millionGPUs」是同页另一则合作消息,并非工具链配额;文首转引的行业报告比例(Capgemini 的79%组织接触物理 AI、60%高管看好;Global Startup Trends Report 的七分之一初创公司做物理 AI、72%认为云计算必不可少)及客户规模数字(Amazon 部署超1 million机器人与 Proteus、NEURA 目标2030年推向市场数百万台机器人、RLWRLD 的8.1-billion-parameter模型、Config 超200,000 hours动作数据),均非本工具链的评测结果。
仓库已经提供
- 8 个 Available 模块:
Foundation、Cosmos、Isaac Lab、Isaac GR00T、DreamZero(独立 CDK 仓库)、Isaac Sim、OSMO(6.3)与Strands Agents本地控制面。 - 1 个 Preview 评测模块:
Isaac Lab Arena Evaluation,用于 GR00T 闭环评测与检查点校验。 - 27 条 UR3 + Robotiq 2F-85 真实遥操作数据:开箱可跑的拾放示例,支持把 Zarr / ROS bags / CSV 转成
LeRobot v2存入 S3。 - 免本地 Docker 与免云费仿真入口:容器由 AWS CodeBuild 云端构建;本地
pai agent sim零云费跑 MuJoCo。
还在画饼或缺失
- Jetson 边缘部署模块缺失:组件表标为
Planned,README 点名的jetson-edge-deployment在仓库中不存在。 - Bedrock AgentCore 托管运行时未就绪:
pai agent deploy与 AWS IoT Core 车队网格桥接均标为Planned。 - 无任务成功率基准:
4096 parallel envs只是单卡并行环境数,无任务成功率、误差线或基线对比。 - 无实测账单与第三方复现:价格均为带
~的粗略估计,尚无独立团队复现报告。
跑通云端训练或本地仿真的前置条件与最小步骤
本地体验只需安装 Python 3.11+ 并执行上文的 pip install 'strands-agents' 'strands-robots[sim-mujoco]' 与 pai agent sim。若要在 AWS 云端拉起训练与仿真,需备齐以下条件:
- 账号与配额:拥有已获批 SageMaker 与 EC2 GPU 配额的 AWS 账号。
- 命令行与环境:
AWS CLI v2、Python 3.11+;生产路径(Production path)需Terraform >= 1.5,工作坊路径(Workshop path)无需 Terraform;本地无需安装 Docker(容器在 AWS CodeBuild 中构建)。 - 外部凭证:用于拉取容器镜像的 NVIDIA NGC API Key,以及用于下载模型权重的 Hugging Face Token。
云端部署时,先进入 foundation/infra/ 部署共享底座(S3、ECR、IAM、VPC、SSM),再进入 isaac-gr00t-on-aws/infra/ 或 isaac-lab-on-aws/infra/ 单独拉起训练,或用 osmo-on-aws/001-iac/ 部署全局编排。测试完毕后务必执行 terraform destroy 或 aws cloudformation delete-stack 释放资源。
上手卡 · Physical AI Toolchain on AWS
- 仓库入口 GitHub
https://github.com/aws-samples/sample-the-physical-ai-toolchain-on-aws(DreamZero 独立仓库为sample-dreamzero-finetuning-on-sagemaker) - 开源许可 Apache License 2.0(2004 年 1 月版)
- 数据与接口标准 原始记录(Zarr / ROS bags / CSV)转
LeRobot v2存 S3;强化学习基于 Gymnasium;本体用 URDF 描述;导出 ONNX / TensorRT 交接给ROS 2 - 硬件与账号门槛 本地 MuJoCo 仿真无需 GPU 和 AWS 账号;云端需
AWS CLI v2、Python 3.11+、Terraform >= 1.5(生产路径)、AWS GPU 配额、NVIDIA NGC API Key 与 Hugging Face Token,本地免 Docker - 预估成本参考 本地 MuJoCo 仿真无云端费用;GR00T 冒烟测试
~$2(15 min)/ 完整微调~$79(11 hrs);DreamZero 冒烟门禁~$10(25 min)/ 1000 steps 微调~$93(4 h 11 m);Isaac Lab 训练~$10-30(2-4 hrs);Isaac Sim 工作站~$1.86/hr;OSMO 全套控制面~$5/hr
本站判断:这套工具链真正的工程价值,是帮使用 NVIDIA 机器人软件栈(Isaac Lab、GR00T、Cosmos、OSMO)的团队省掉了在 AWS 上手写 Terraform、配 VPC 权限、建 CodeBuild 容器流水线和打通 S3 数据格式的重复劳动;随库附带的 27 条 UR3 遥操作数据和明码标出的冒烟测试配置(~$2 / 15 min),也让验证云端训练管线的试错成本足够透明。但它的短板同样清楚:从云端训练到机载边缘落地的「最后一公里」(Jetson 边缘部署模块与 Bedrock AgentCore 云端控制面)在仓库里依然标着 Planned,且 README 出现了指向不存在目录 jetson-edge-deployment 和错误相对路径 ../gr00t-training-on-aws/ 的文档纰漏。把它当成云端训练与仿真的 Terraform 脚手架很实用,但指望靠它今天就把模型一键推上现场机器人,还为时尚早。
带走一句
这是一套实用的 NVIDIA 机器人云端训练与仿真 Terraform 脚手架,但下发到 Jetson 真机的边缘部署模块还没写完。
本站说明
- 表格与图片出处:正文中「组件清单表」、「飞轮阶段与 AWS 服务映射表」及「官方预估费用表」均译自 GitHub 仓库
sample-the-physical-ai-toolchain-on-aws根目录README.md;两张架构与飞轮配图(flywheel.png、arch-diagram.png)直接引用自该仓库main分支,遵循 Apache-2.0 许可证。 - 本站计算说明:GR00T 完整训练相对于冒烟测试的时长倍数
44.0(11 / (15/60))与预估费用倍数39.5(79 / 2),以及 DreamZero 1000 steps 微调相对于冒烟门禁的时长倍数10.04((4 + 11/60) / (25/60))与预估费用倍数9.3(93 / 10),均由本站根据 README 预估成本表计算得出;<RankBars>图表由本站按同一预估表重排生成。 - 本站解释与核查说明:关于
Edge Deployment在新闻稿、README 选型表与组件状态表、仓库根目录树之间的矛盾对比,strands-agents-on-aws中so100与so101的前后差异、../gr00t-training-on-aws/相对链接与isaac-gr00t-on-aws真实目录名的错位,以及两份官方材料中Ignacio Sánchez与Ignacio Salvar的署名差异,均为本站对照原始材料包核查所得。The Robot Report 的二次报道因权限受限未纳入材料包,本文完全基于 AWS 与 GitHub 一手材料撰写。
来源
本页事实对应的公开页面,以原文为准。