# 只看一条 5 秒人类视频,20 自由度五指灵巧手零样本上真机:未见位置平均成功率 75%,比基线高 71 个百分点
> 原文链接:https://robotics.hellobike.com/explainers/dex-one2many
> 频道:explainers | 更新日期:2026-10-14 | 标签:
> 核心摘要:首尔大学、马里兰大学与 KAIST 提出 Dex-One2Many,用 Gemini 3.1 Pro 把单条人类视频抽象成顺序场景图引导 49,152 个并行环境强化学习,零样本迁移至真机。
# 只看一条 5 秒人类视频,20 自由度五指灵巧手零样本上真机:未见位置平均成功率 75%,比基线高 71 个百分点
::: quick
- **不抄人手动作轨迹,改抄任务阶段的「关系图」**:首尔大学(SNU)、马里兰大学(UMD)与 KAIST 团队提出 `Dex-One2Many`,用视觉语言模型(Gemini 3.1 Pro)把一条单视角人类演示视频拆成按阶段排列的顺序场景图(sequential scene graphs),全部在仿真里用强化学习训练,再零样本(zero-shot,不采任何真机数据、不做真机微调)部署到 20 自由度多指灵巧手上。
- **视频里见过的摆法只领先 6.5%,换个没见过的位置差距拉大到 71 个百分点**:在五个操作与工具使用任务上,当物体放在视频演示过的附近位置(Seen)时,该方法比基线高 6.5%;一旦把物体挪到视频没出现过的新位置和新姿态(Unseen),基线在仿真和真机上全部掉到 15% 或以下,而 `Dex-One2Many` 平均成功率达到 75%(真机 60–85%、仿真 85–100%),领先次优基线 71 个百分点(本站按论文数据计算,未见场景的领先幅度是已见场景的约 10.92 倍)。
- **单卡/集群并行规模是硬门槛:49,152 个环境能超 90%,砍半就跌破 25%**:消融实验显示,去掉稠密谓词奖励后训练全程成功率为 0%;去掉阶段重置后成功率从超过 90% 掉到约 16%;即使机制全留,把并行仿真环境数从 49,152 降到 24,576 或 12,288,同样训练步数下成功率依然低于 25%。
- **跨本体只测了仿真,且代码尚未放出**:论文在四种机械臂+灵巧手组合上跑出 94.6%–96.8% 的平均成功率,但其中三种组合只在仿真里测过,真机只上了 `UR3 + Wuji 1`;此外真机依赖外部相机估计 6D 物体位姿、只支持刚体,且项目页代码链接目前仍是 `Code (Coming soon)`。
:::
::: stance
本文材料来自 2026 年 10 月 8 日提交至 arXiv 的论文《Dex-One2Many》(编号 `arXiv:2610.12470v1`,知识共享许可协议为 `CC BY 4.0`)HTML 全文与摘要页,以及作者公开的项目主页 `https://dex-one2many.github.io/`(网页底部标明网站许可为 `CC BY-SA 4.0`)。文中所有实验数字均来自作者团队在仿真(每方法每任务 30 个 episode,跨本体表为每任务 500 个 episode)与单套真机(每方法每任务 30 次试验:Seen 10 次、Unseen 20 次)上的自测结果,目前没有第三方独立复现,项目代码尚未开源。需要特别说明的是,论文 Figure 4 的逐任务真机柱状图与 Figure 5 的工作空间热力图未在文本中给出逐格数字,且 Figure 4 图注提到存在因硬件故障缺失的实验(标为 `N/A`),但未在图注中点名具体是哪一项任务。文中涉及的比值与极差均由本站计算并明确标注。
:::
::: stats
- **75% vs ≤15%** 视频未见配置(Unseen)下的平均成功率(真机 60–85%、仿真 85–100%)与两条基线方法(Do as I Do、CHORD)的上限对比,领先次优基线 71 个百分点
- **94.6%–96.8%** 四套不同机械臂+多指手组合在 5 个任务(每任务 500 次仿真 episode)上的平均成功率区间,本站计算跨本体极差仅 2.2 个百分点
- **49,152 个** 训练突破 90% 成功率所需的并行 GPU 物理仿真环境数,砍半至 24,576 个时同更新步数下成功率低于 25%
- **$0.171 / 81.9s** 全部 5 个任务(合计 27.11 秒视频)调用 Gemini 3.1 Pro 抽取顺序场景图的总 API 费用与总耗时
:::
## 只给机器人看一段几秒钟的人手视频,它能学会在新位置拿锤子砸、拿刷子扫 {data-eyebrow="先看发生了什么"}
教一只拥有 20 个以上驱动关节的五指灵巧手干活,一直是具身智能里数据成本最高的活儿。如果走遥操作(teleoperation)路线,操作员得戴着昂贵的动作捕捉手套或外骨骼,手把手带着真机在桌面上反复抓几十上百次;如果走纯强化学习(RL)路线,工程师又得为每个新任务手写复杂的阶段奖励函数。
2026 年 10 月 8 日,来自首尔大学(Seoul National University)、马里兰大学帕克分校(University of Maryland, College Park)和韩国科学技术院(KAIST)的 Jusuk Lee、Sungha Kim、Yeonsoo Park(三人共同一作,Youngseok Jang 与 Seungjae Lee 共同指导;注:论文作者单位行中还出现了 `All Purpose AI`,但未标明对应哪位作者)在 arXiv 提交了论文 **Dex-One2Many**(`arXiv:2610.12470`)。
他们展示了一件很干脆的事:不需要人类戴动捕手套,不需要任何真机遥操作数据,甚至不需要多视角相机阵列——只需要用普通相机拍**一条几秒钟(4.00 秒到 7.07 秒,分辨率 640×480)的人类单手演示视频**,系统就能在仿真器里自动训练出一个多指灵巧操作策略,然后**零样本(zero-shot)**直接装到真实的 6 自由度 `UR3` 机械臂配 20 自由度 `Wuji 1` 五指灵巧手上。
::: figure
项目主页总览演示视频(含英文旁白):展示如何从单条人类演示视频出发,在仿真中学会灵巧操作策略,并零样本泛化到视频里从未出现过的物体初始位置、目标位置与多指抓取姿态。来源:Dex-One2Many 项目主页(CC BY-SA 4.0)。
:::
论文一共测了五个桌面操作任务,分为两类:
- **三项直接操作任务(Direct-manipulation tasks)**:把皮卡丘玩偶放进锅里(**Doll**,形式化成功谓词写作 `success:inside(pikachu, pot)`)、抓起易拉罐移到目标位(**Can**)、抓起印章盖下去(**Stamp**)。
- **两项工具使用任务(Tool-use tasks)**:抓起锤子去敲击目标物体(**Hammer**)、抓起蓝刷子把灰色小猫毛绒玩具扫进蓝色簸箕里(**Sweep**,VLM 抽取出的任务名为 `sweep toy into dustpan`)。
在真机评测中,所有试验都要求灵巧手**从空手状态(free hand)出发**,一口气做完「接近—抓取—操作/使用工具」的完整流程。当把桌上的玩偶、锤子或簸箕摆到输入视频里根本没出现过的新位置和新朝向(Unseen configurations)时,两条 2026 年的最新基线方法在仿真和真机上的成功率全都塌缩到了 **15% 或以下**,而 `Dex-One2Many` 在仿真中拿到了 **85–100%**、在真实机器人上拿到了 **60–85%** 的成功率。
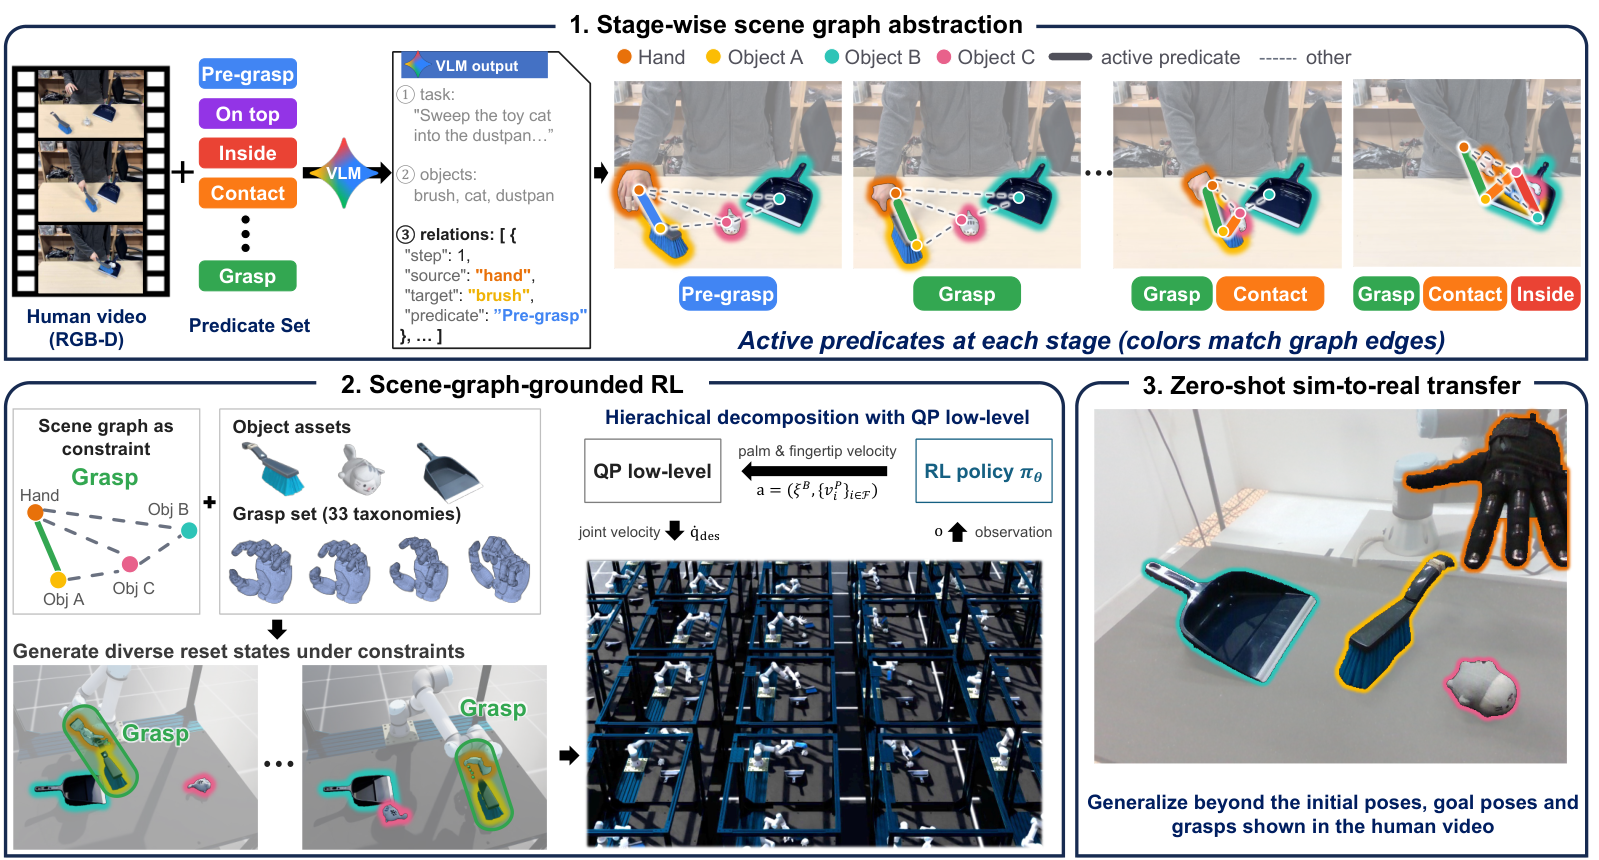
*图片来源:arXiv:2610.12470v1 Figure 1(CC BY 4.0)。从单条人类演示视频出发,策略完全在仿真中训练并零样本部署到真机,能够覆盖视频未展示的初始位姿、目标位姿与多样化抓取构型。*
## 为什么「照着视频复刻人手动作」换个位置就会失灵? {data-eyebrow="旧瓶颈"}
从单条或少量人类视频里学机器人操作,学术界通常叫 **Real-to-Sim-to-Real**(先把真实视频重建进仿真器,在仿真里学会动作,再迁回真机)。但为什么以前的方法只要把桌子上的物体挪开几厘米,成功率就会断崖式下跌?
根源在于:**以前的方法太执着于「一模一样地复刻视频里那条轨迹」了。**
论文在相关工作与实验部分对比了多条代表性路线,我们把它们的做法与局限整理成下表:
| 方法名称 | 核心做法 | 为什么换个物体位置或换只灵巧手就容易失效 |
| :--- | :--- | :--- |
| **Do as I Do**(Paliwal et al., 2026,本文实验基线 1) | 从视频中重建 4D 手-物体交互过程,再通过轨迹优化(trajectory optimization)把恢复出的人手动作重定向(retarget)到机器人手上 | 强绑定视频里那一次特定的人手运动轨迹与抓取姿势;当物体换到新位置,机械臂运动学可达性改变,原来的抓取方向可能根本够不着或发生碰撞 |
| **CHORD**(Zhu et al., 2026,本文实验基线 2) | 利用演示视频中的物体状态演化(object state evolution)和接触扳手(contact wrench)引导,去复现演示轨迹 | 依然围绕单条演示轨迹做局部引导;面对大幅度偏离演示的新初始位姿或新目标位姿,策略缺乏跨抓取构型的全局搜索能力 |
| **早期视频重建路线**(Human2Sim2Robot / Video2Sim2Real / Morphometric Imitation) | 重建演示场景并在小范围内做强化学习或模仿 | 论文脚注与项目页指出其泛化评测范围很窄:`Human2Sim2Robot` 初始位置仅在 `4 cm × 4 cm` 内变化且目标固定;`Video2Sim2Real` 初始/目标仅在 `±5 cm`、`±10°` 内变化;`Morphometric Imitation` 仅在演示周围约 `10 cm × 10 cm` 区域内变化 |
用一个日常场景就能想明白这件事:假设视频里的人是从桌子正前方伸手、虎口朝下抓起茶杯的。如果现在把茶杯挪到机械臂左侧边缘、并且手柄转了 90 度,机械臂再去硬抄视频里「从正前方虎口朝下」的手部轨迹,手腕关节就会直接卡进奇异点或者撞上桌面。要想在新位置成功,机器人必须具备**「一对多(One-to-Many)」**的能力——**看懂视频里要干成的「阶段关系」,但到了新位置上,自己换一种能抓稳的新手势、走一条全新的运动路线**。
:::: pair
::: side 以往的轨迹复刻路线(One-to-One)
- **抄动作(How)**:把视频里人手每一帧的关节角度、手指接触点和物体移动轨迹当成标准答案去模仿。
- **单手势死磕**:自始至终只用视频里出现的那一种抓法(grasp),一旦物体移到机械臂另一侧导致该抓法不可达,任务直接失败。
- **泛化半径只有几厘米**:只能在演示位置附近 `4 cm × 4 cm` 或 `±5 cm` 的小格子里微调。
:::
::: side 本文的场景图引导路线(One-to-Many)
- **抄关系(What)**:用 VLM 把视频抽象成离散的「顺序场景图」,只保留每个阶段哪个部位该挨着哪个部位、朝向怎么对齐,彻底扔掉人手的具体轨迹。
- **33 类抓取分类学全覆盖**:用 `Dexonomy` 在物体可抓取区域自动生成成百上千种多指抓法(横跨 Feix 33 类抓取分类学),让强化学习自己挑最顺手的那一种。
- **换手不换管线**:因为场景图只描述物体和部位关系、与人手解剖结构解耦,换一套机械臂和灵巧手只需替换机器人模型和抓取集即可重新训练。
:::
::::
## 核心机制拆解:花 3 美分让 Gemini 3.1 Pro 画张「过关地图」,再开 49,152 个环境练手 {data-eyebrow="这次怎么解"}
`Dex-One2Many` 是怎么把一段几秒钟的 RGB-D 视频变成一个能泛化的多指控制策略的?整套流水线可以分为三个核心步骤。
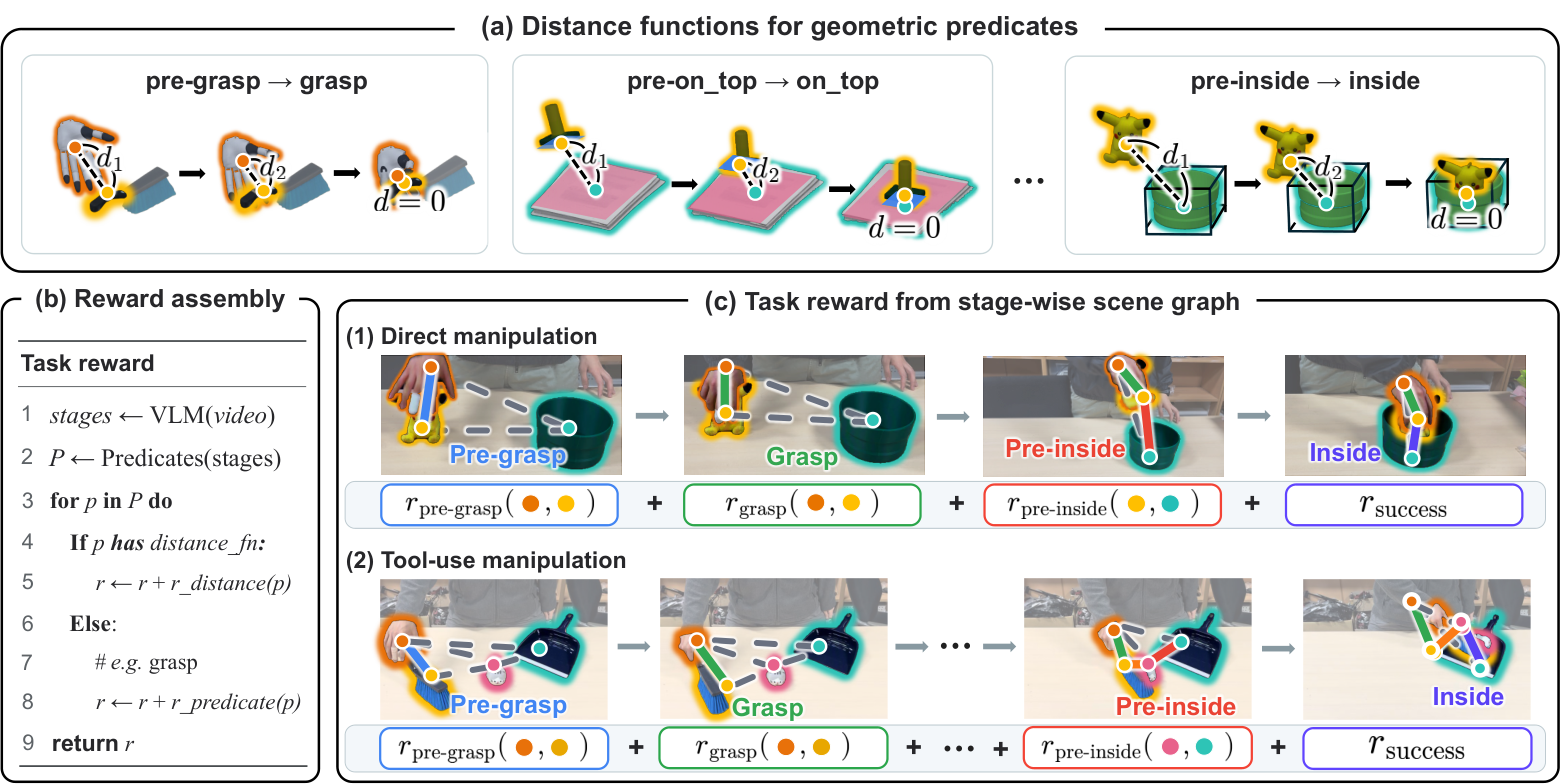
*图片来源:arXiv:2610.12470v1 Figure 2(CC BY 4.0)。VLM 从人类演示视频中抽取阶段化顺序场景图(Stage-wise Scene Graph),用图中的空间关系谓词同时约束阶段重置状态采样与稠密强化学习奖励,最终零样本迁移至真机。*
### 第一步:调用 5 个预训练大模型,把视频拆成「3D 资产 + 顺序场景图」
系统首先要把视频里的东西搬进仿真器,并看懂任务分几步走。论文没有自己训练视觉大模型,而是直接把现成的五个预训练模型串成了一条自动化资产与语义抽取管线(论文 Table 2):
| 处理环节(Step) | 调用的预训练模型 | 输入与输出(Input → Output) | 在管线里的具体作用 |
| :--- | :--- | :--- | :--- |
| **场景图抽取**(Scene-graph extraction) | **Gemini 3.1 Pro**(`gemini-3.1-pro-preview`) | `video → entities, parts, stage sequence` | 看 640×480 视频,识别任务涉及的物体、功能部位(如锤头、锤柄),并把视频切分成按时间顺序排列的任务阶段图 |
| **实例分割**(Instance segmentation) | **SAM 3.1** | `first frame, visual_phrase → object mask` | 根据首帧画面和物体描述词,抠出每个物体的像素级掩码(mask) |
| **网格重建**(Mesh reconstruction) | **SAM 3D Objects** | `RGB, mask, metric point map → metric mesh` | 结合 RGB 图像、掩码与带真实尺度的点云图,重建出带米制尺寸的 3D 物体网格资产(刚体) |
| **物理参数估计**(Physical parameters) | **GPT-5** | `category, size → mass, friction` | 根据物体类别和尺寸,估计物体的质量与摩擦系数区间(供仿真域随机化与物理校验使用) |
| **部位定位**(Part localization) | **SAM 3** | `rendered views, part name → part region` | 在重建好的 3D 网格多视角渲染图上,标出功能部位(如刷毛、印章底面、杯柄)对应的三维区域 |
| **物体位姿跟踪**(Object pose tracking) | **FoundationPose++** | `RGB-D stream, mesh → 6D pose` | 在视频解析及真机实时部署时,用两台 RGB-D 相机流实时跟踪物体的 6D 位姿(三维位置 + 三维朝向) |
什么叫**顺序场景图(Sequential Scene Graph)**?简单说,它就是一张用符号逻辑写成的「游戏过关地图」。在每个阶段(Stage)里,图的节点是物体或物体上的功能部位,边则是预定义好的空间几何关系谓词(predicates)——比如「灵巧手抓住刷柄」、「刷毛接触小猫玩具」、「小猫玩具进入簸箕内部」(如 Doll 任务的终点谓词就是 `success:inside(pikachu, pot)`)。
你可能担心调大模型分析视频会不会又慢又贵。论文在附录 Table 6 里把全部 5 个任务调 `Gemini 3.1 Pro`(`gemini-3.1-pro-preview`)的真实耗时和账单晒了出来:
| 任务名称 | 输入视频时长(秒) | Gemini 3.1 Pro 响应延迟(秒) | API 调用费用(美元) |
| :--- | :--- | :--- | :--- |
| **Doll**(玩偶入锅) | `7.07` | `21.2` | `$0.045` |
| **Can**(移易拉罐) | `5.30` | `11.5` | `$0.024` |
| **Stamp**(盖印章) | `4.97` | `12.0` | `$0.026` |
| **Hammer**(锤子敲击) | `4.00` | `18.7` | `$0.039` |
| **Sweep**(刷子扫玩具进簸箕) | `5.77` | `18.5` | `$0.037` |
| **合计(Total)** | **`27.11`** | **`81.9`** | **`$0.171`** |
单条视频查询只需要 **11.5 秒到 21.2 秒**,花费全部低于 **`$0.05`**(最便宜的 Can 只要 2.4 美分);把五个任务的场景图全部抽完,总耗时 **81.9 秒**,总账单只有 **`$0.171`**(约合人民币 1.2 元)。
### 第二步:用场景图生成「阶段重置状态库」与「门控稠密奖励」
拿到顺序场景图之后,为什么不直接让机械臂从零开始在仿真里瞎试?因为长程灵巧操作的搜索空间太大了——如果灵巧手连锤子都没抓稳,它永远不可能偶然试出「拿锤子敲准目标」的动作,强化学习一辈子都拿不到最后那一下稀疏奖励。
`Dex-One2Many` 用场景图同时干了两件大事:
1. **反向生成经过物理校验的「阶段重置状态库(Stage-wise Reset States)」**:
系统不绑死视频里人手那一个抓法,而是调用抓取生成工具 **Dexonomy**,在物体被标注出的抓取部位上生成大量不同的多指抓取构型(横跨 Feix 等人 2015 年提出的 **33 类抓取分类学 33-type grasp taxonomy**),每个抓取构型都附带一组经过验证的手指闭合指令 $q_{\text{cmd}}$。接着,系统按场景图的阶段把状态往回推(比如预抓取状态把手指张开插值到抓取构型的 **30–90%**,并沿接近轴后退 **1–5 cm**),并在仿真器里做严格的**最坏情况物理稳定性检验**——用估计的**最大质量**和**最小静摩擦系数**(静摩擦在 $[0.9\mu, 1.1\mu]$ 采样且下限为 `0.05`,动摩擦为静摩擦的 `0.9` 倍),施加量级为 $\min(0.5 m_{\max} g, 0.5\text{ N})$、力臂为 **0.02 m** 的外力扰动测试能不能抓稳。每个任务阶段最终保留 **10,000 个通过物理检验的有效状态**。训练时,环境可以直接随机初始化在这些中间阶段状态上,相当于让机器人从「存档点」开始分段练级。
2. **带「抓稳门控(Hold Condition)」的谓词稠密奖励(Predicate-derived Dense Rewards)**:
场景图里的每条空间关系边都会自动翻译成平滑的稠密奖励函数;抓取阶段则采用 CHORD 的 **6D 扳手空间力闭合奖励(force-closure reward in 6D wrench space)**加上抓取质量项。更关键的一个防作弊设计是**阶段门控**:后续操作阶段的奖励,只有当物体满足 **`hold`(稳固持握)条件**时才会激活——所谓 `hold`,要求物体被抬离桌面达到 **$h_{\text{lift}} = 5\text{ cm}$**,同时**至少有两根不同的手指与物体保持接触**,且最弱扳手方向的力支撑为正。这就堵死了强化学习最爱钻的空子(比如不抓起工具、直接用手掌推着工具在桌面上蹭过去骗分)。
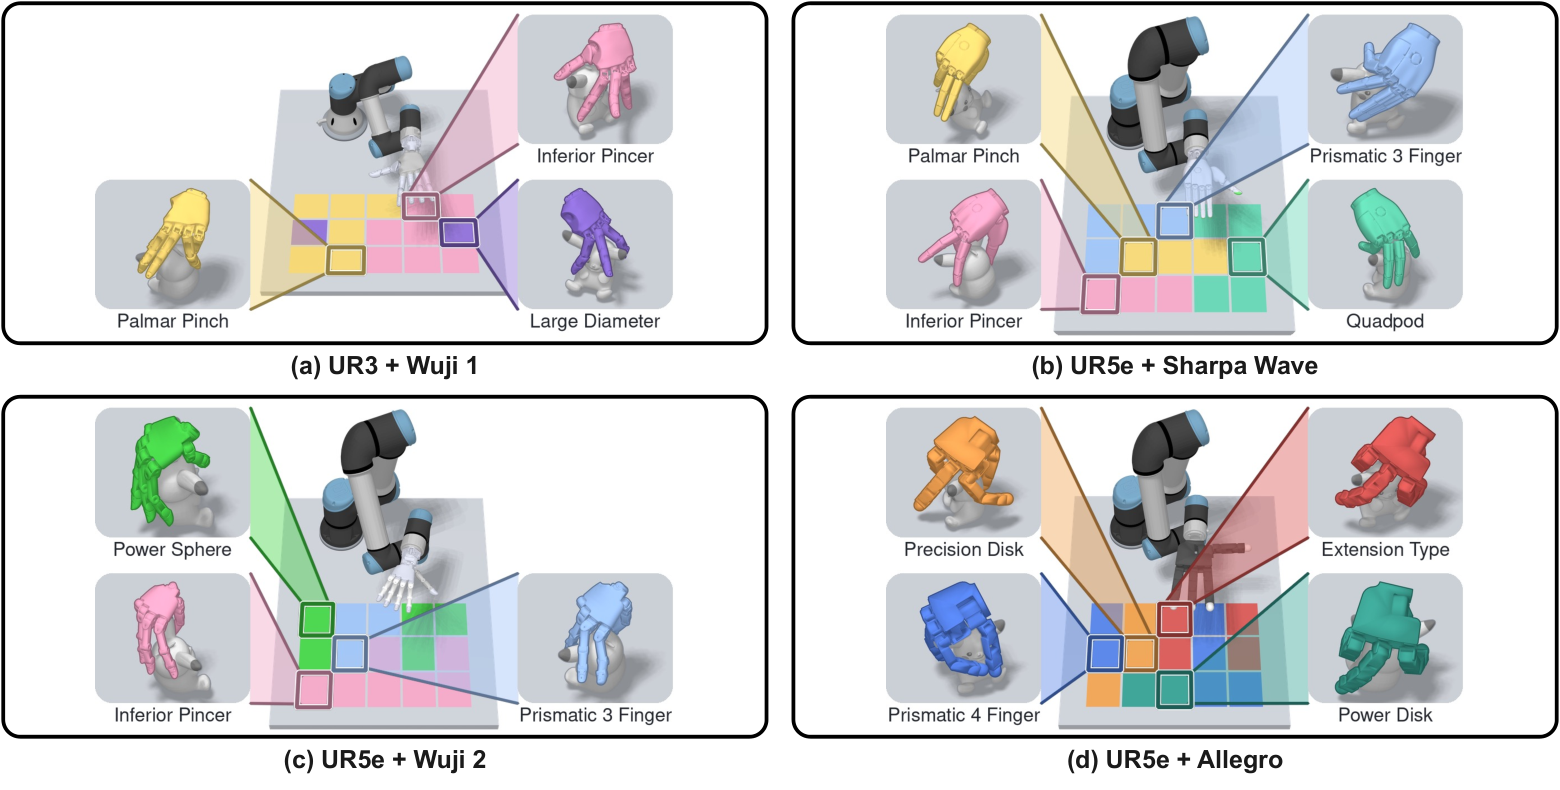
*图片来源:arXiv:2610.12470v1 Figure 6(CC BY 4.0)。在 Doll 任务上,策略不局限于人类视频中的单一手势,而是根据物体所在方位自适应展现出横跨 Feix 33 类抓取分类学的多种抓取构型。*
### 第三步:不看图像的非对称 PPO 训练 + 零重训 QP 安全控制器上真机
在训练与部署架构上,论文做了两个非常务实的工程取舍:
1. **策略网络不直接看相机图像,只看 6D 位姿与场景图状态**:
训练在 **NVIDIA Isaac Sim + [Isaac Lab](/sdks/isaac-lab)** 的 GPU PhysX 物理引擎中进行,物理仿真频率为 **120 Hz**,策略每 12 个仿真步输出一次动作,即**控制频率为 10 Hz**;每个 episode 时长 **16 秒**(对应 **160 个策略步**)。算法采用 PPO 配合**非对称 Actor-Critic(asymmetric actor–critic)**架构:Critic 网络在训练时可以偷看仿真器里的特权物理状态,而真正上真机运行的 Actor 网络(采用 1 层、宽度 1024 的 LSTM 循环网络,初始学习率 $1\times 10^{-4}$)**只观测物体的 6D 位姿(object poses rather than images)**与本体关节状态。为了抗住真机视觉误差,训练时在桌面静摩擦(`0.3–0.6`)和动摩擦(`0.2–0.5`)上做随机化,并人为往动态物体位置观测里注入每轴标准差 **1 cm**(上限 **3 cm**)的高斯噪声,往静态物体位置注入每轴标准差 **0.5 cm**(上限 **1.5 cm**)的噪声,朝向随机旋转 **$-5^\circ$ 到 $+5^\circ$**。真机部署时,由两台 **Intel RealSense D435i** RGB-D 相机运行 `FoundationPose++` 实时追踪物体 6D 位姿,并用深度一致性权重融合后喂给 Actor。
2. **输出任务空间速度,用底层二次规划(QP)控制器零重训解决真机撞桌脱扣**:
Actor 网络输出的不是底层电机关节角度,而是**期望的手掌与各指尖在任务空间中的三维速度**(四指手动作维度为 **18**,五指手动作维度为 **21**),再交给底层的**二次规划(QP,Quadratic Programming)控制器**实时映射成各个关节的速度指令。
这个分层设计在真机实验里立了大功(论文 Figure 12):他们用的 `Wuji 1` 五指手有一个机械结构软肋——手腕耦合器(coupler)一旦在桌面上撞击受力,在真实物理世界里就会直接从机械臂上**脱扣掉下来(disengage)**,而仿真器里根本没有建模这种机械脱扣失效。得益于底层的 QP 控制器,作者**一行策略权重都没重新训练**,直接在部署时的 QP 优化目标里加了一条「手部与桌面最小安全间隙约束(hand–table clearance constraint)」,同时收紧了关节速度上下限($\dot{q}_{\min}$ 与 $\dot{q}_{\max}$)来降低真机运行速度,当场消除了撞桌脱扣故障。
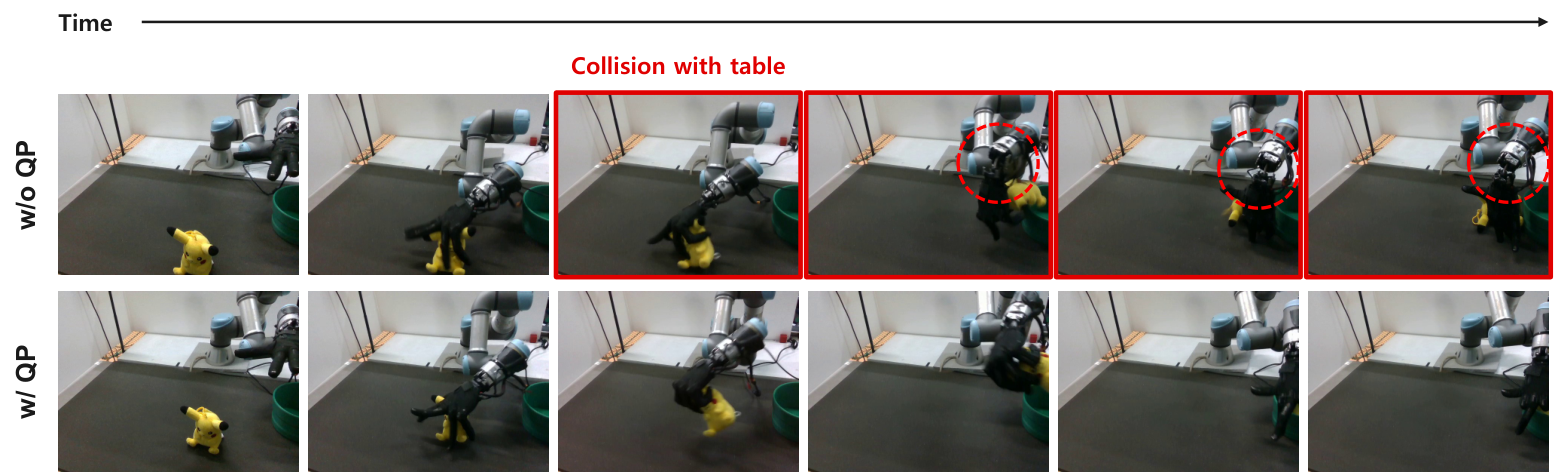
*图片来源:arXiv:2610.12470v1 Figure 12(CC BY 4.0)。真实世界里 Wuji 1 灵巧手耦合器碰到桌面会导致机械脱扣(左),部署时在底层 QP 控制器中加入手-桌间隙约束后,无需重新训练 RL 策略即可避开碰撞(右)。*
::: figure
方法详解视频(含英文旁白):分步展示 VLM 顺序场景图抽取、阶段重置状态验证以及强化学习策略训练过程。来源:Dex-One2Many 项目主页(CC BY-SA 4.0)。
:::
## 实验成绩与消融:并行环境从 49,152 砍半到 24,576,成功率直接从超 90% 跌到 25% 以下 {data-eyebrow="数据与消融"}
论文的实验部分围绕三个核心问题展开:未见位置泛化到底比基线强多少?换一套机械臂和灵巧手还灵不灵?管线里哪块抽掉就会崩?
### 1. 真机与仿真泛化对比:Seen 差距 6.5%,Unseen 差距拉大到 71 个百分点
在主实验(§4.2)中,作者将 `Dex-One2Many` 与前面提到的两条 2026 年基线方法 **Do as I Do** 和 **CHORD** 放在 `6-DoF UR3 + 20-DoF Wuji 1` 上同台对比。每个方法在每个任务上跑 **30 个仿真 episode** 和 **30 次真机试验**(其中 **10 次为 Seen 配置**,即物体摆在输入视频演示过的位姿附近;**20 次为 Unseen 配置**,即物体摆在视频从未出现过的新位置与新朝向)。
- 在 **Seen(已见配置)** 下:大家都能复现演示附近的动作,`Dex-One2Many` 的平均成功率比基线高出 **6.5%**。
- 在 **Unseen(未见配置)** 下:两条基线方法无论在仿真还是真机上,成功率全部停留在 **15% 或以下**;而 `Dex-One2Many` 在未见配置下取得了 **75% 的平均成功率**(其中仿真成功率为 **85–100%**,真机零样本部署成功率为 **60–85%**),比表现次优的基线高出 **71 个百分点(71 percentage points)**。
**本站按论文公布数字计算**,未见配置下的领先幅度(71 个百分点)是已见配置下领先幅度(6.5%)的 **约 10.92 倍**(`71 / 6.5`)。这组数字非常直观地说明:如果只是在演示点原地复现,搞复杂场景图和大规模 RL 的收益并不大(+6.5%);这套框架真正的杀手锏在于把单次演示泛化到整张桌面工作空间(+71 个百分点)。
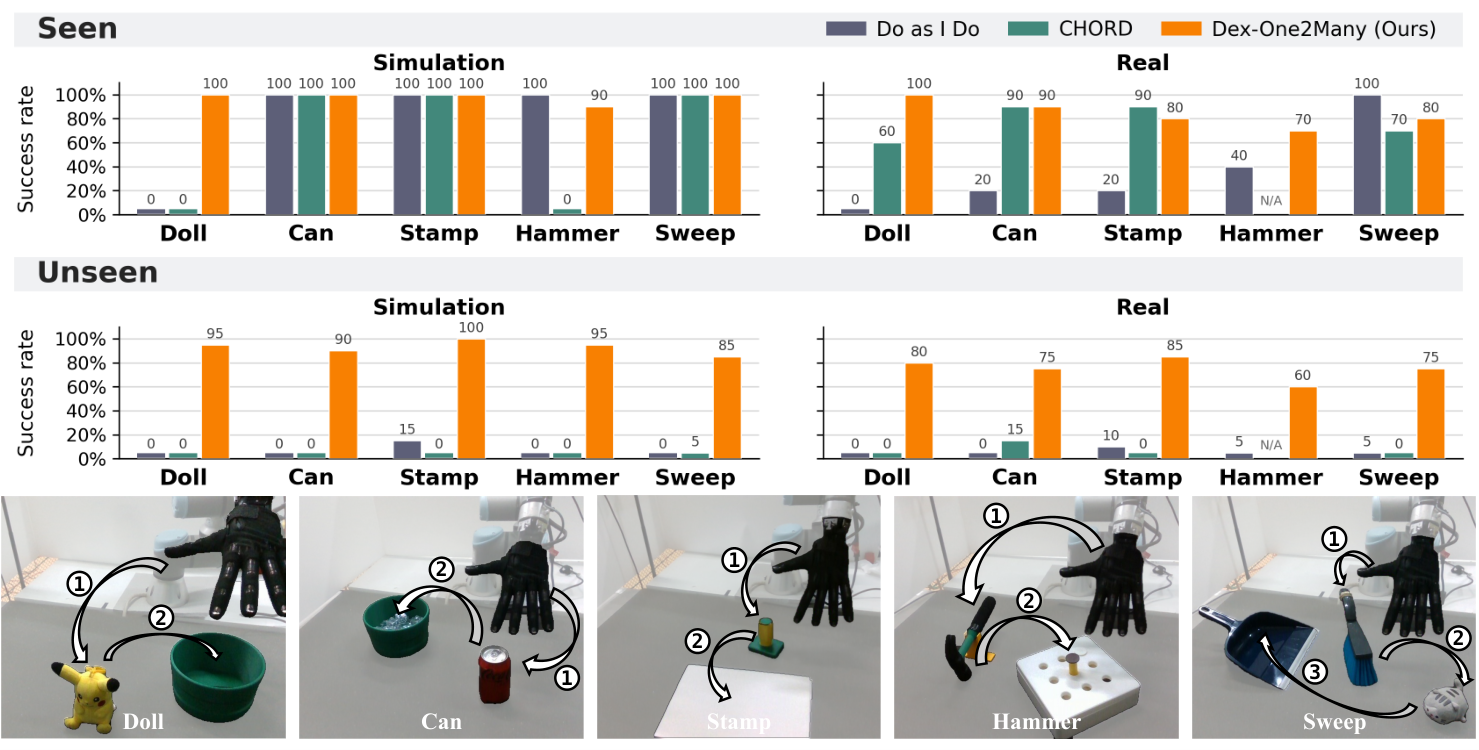
*图片来源:arXiv:2610.12470v1 Figure 4(CC BY 4.0)。展示五个任务在仿真与真机上的 Seen / Unseen 成功率对比。注意:各任务的逐柱精确数值画在图片内部,正文仅给出总体区间(仿真 Unseen 85–100%、真机 Unseen 60–85%、基线 ≤15%);图注注明 N/A 代表因硬件故障未能完成的实验,但未在文字中点名具体是哪一项。*
### 2. 四套机械臂+灵巧手跨本体仿真:2000 次评测均值全部在 94.6% 以上
既然顺序场景图只描述「锤头敲目标」这类物体关系,不包含人手关节数据,那它能不能直接迁到不同厂家、甚至不同手指数量的机械臂+灵巧手组合上?
作者在仿真中测试了四套总驱动关节数在 **22 到 28 个**之间、带 **四根或五根指尖**的异构硬件组合,包括刚在我们站内入库的 [Universal Robots UR5e](/robots/universal-robots-ur5e) 机械臂与 [Sharpa](/companies/sharpa) Wave 灵巧手(切换本体时只替换机器人的 URDF/USD 模型和 Dexonomy 生成的抓取集,为每个本体单独训练策略,物体初始位置在 $(x, y) \in [0.3, 0.7] \times [-0.17, 0.4]\text{ m}$ 的可达区域内随机采样,每个任务评估 **500 个 episode**)。论文 Table 1 的完整成绩如下:
| 任务名称(每项 500 episodes) | UR3 + Wuji 1(五指) | UR5e + Sharpa Wave(五指) | UR5e + Wuji 2(五指) | UR5e + Allegro(四指) |
| :--- | :--- | :--- | :--- | :--- |
| **Doll**(玩偶入锅) | `88.4%` | **`98.4%`** | `97.2%` | `97.2%` |
| **Can**(移易拉罐) | `93.6%` | **`97.4%`** | `95.2%` | `92.2%` |
| **Stamp**(盖印章) | `98.6%` | `96.6%` | `97.0%` | **`98.8%`** |
| **Hammer**(锤子敲击) | `94.6%` | `94.2%` | **`97.6%`** | `91.8%` |
| **Sweep**(刷子扫玩具) | `98.0%` | `96.6%` | `97.0%` | **`100.0%`** |
| **五任务平均(Mean)** | **`94.6%`** | **`96.6%`** | **`96.8%`** | **`96.0%`** |
**本站按 Table 1 数据计算**,四套硬件组合的五任务平均成功率最高为 `UR5e + Wuji 2` 的 **96.8%**,最低为 `UR3 + Wuji 1` 的 **94.6%**,跨四种本体的平均成功率极差只有 **2.2 个百分点**(`96.8 - 94.6`);全表 20 个单项单元格中,最高分是四指手 `UR5e + Allegro` 在 Sweep 任务上的 **100.0%**,最低分是 `UR3 + Wuji 1` 在 Doll 任务上的 **88.4%**,全表极差为 **11.6 个百分点**(`100.0 - 88.4`)。连只有四根手指(动作维度 18)的 Allegro 手也能用同一条人类五指视频训出 **96.0%** 的平均分。
### 3. 反直觉的消融实验:并行环境少一半都不行
为了搞清楚到底是哪个模块撑起了高成功率,作者在仿真 **Sweep(拿刷子扫玩具进簸箕)** 任务上做了四组消融实验(均从空手状态开始测完整任务,训练 2,000 次 PPO 更新,即 `2k PPO updates`):
这四组对比揭示了这套方法极其硬核的工程条件:
1. **去掉谓词稠密奖励(`w/o dense reward`)→ 全程 `0%`**:如果不用场景图边转换出的平滑稠密奖励,只靠稀疏成功信号,哪怕有阶段重置,训练从头到尾成功率一直是 **0%**。
2. **去掉阶段重置(`w/o stage-wise reset`)→ 从 `over 90%` 暴跌到 `about 16%`**:如果不让强化学习从中间阶段的 10,000 个验证状态「读档练级」,而是每次都从空手状态重头探索,2k PPO 更新后的成功率直接从超过 90% 摔到约 16%。
3. **去掉验证闭合指令(`w/o qcmd`)→ 掉到 `about 48%`**:如果在抓取初始化时不恢复经过物理检验的手指闭合指令 $q_{\text{cmd}}$,成功率掉到约 48%,且训练中频繁出现抓不紧打滑和物体掉落。
4. **最反直觉的算力门槛——并行环境数(Training scale)**:通常做强化学习的人会觉得,把并行环境数减半,无非就是收敛慢一点。但在 `Dex-One2Many` 的 Sweep 任务上,开满 **49,152 个并行环境**时,2k PPO 更新后成功率能**超过 90%**;而一旦把并行环境数降到 **24,576 个**(砍半)或 **12,288 个**(**本站计算**:49,152 是 12,288 的 **4.0 倍**),在相同的 PPO 更新次数下,成功率竟然**全都卡在 25% 以下(remains below 25%)**。这说明要在横跨 33 类抓法、三维工作空间和长序列多阶段的巨大状态空间里把策略采样透,接近五万个并行环境的暴力吞吐量是必不可少的。
## 哪些已经在真机上验证,哪些还停在仿真或图片里? {data-eyebrow="证据边界"}
综合核对论文正文、附录与项目主页,我们把这项工作「已经实测验证的部分」和「尚未证明或存在缺口的部分」严格切开:
:::: pair
::: ok 论文已经测到与公布
- **单套真机零样本迁移成功**:在 `6-DoF UR3 + 20-DoF Wuji 1` 真机上完成 5 个任务的 Seen(10 次/任务)与 Unseen(20 次/任务)评测,Unseen 真机成功率达 `60–85%`(基线 `≤15%`)。
- **四套本体仿真高成功率**:在 `UR3 + Wuji 1`、`UR5e + Sharpa Wave`、`UR5e + Wuji 2`、`UR5e + Allegro` 上各测 500 episodes/任务,均值达 `94.6%–96.8%`。
- **VLM 抽取成本极低且有明细账单**:5 个任务用 Gemini 3.1 Pro 抽场景图合计耗时 `81.9s`、总花费 `$0.171`。
- **QP 底层安全约束真机有效**:证实无需重训 RL 策略,靠部署时 QP 间隙约束即可阻止 `Wuji 1` 手腕耦合器撞桌脱扣。
:::
::: no 论文尚未展示或受限
- **另外三只手没有上真机**:`UR5e + Sharpa Wave`、`Wuji 2` 和四指 `Allegro` 的高分全部来自仿真 Table 1,没有真机实验。
- **感知靠外部双相机 + 已知 3D 网格,且只管刚体**:策略不直接看图像,依赖两台 RealSense D435i 跑 `FoundationPose++` 估计 6D 位姿;作者坦承位姿估计噪声与网格几何误差会拉低真机接触表现,且自动重建只支持刚体(铰接物体需手工准备资产)。
- **逐任务真机具体百分比与 N/A 故障未在正文写明**:Figure 4 的单任务真机数字只画在柱状图图片里,且图注中因硬件故障标为 `N/A` 的那项实验未在文字中点名是哪个任务或哪个基线。
- **代码尚未开源**:项目主页上的 `Code` 按钮目前标为 `Coming soon`,外部团队暂时无法复现训练管线。
:::
::::
此外,论文在 Appendix A 中还专门提醒了一句学术对比边界:由于不同论文的实验设定存在差异,某些相关工作与本文设定**不可直接横向比较(the two settings are not directly comparable)**。
## 如果想复现或跟进这套方案,你需要准备什么硬件与工具栈? {data-eyebrow="能不能复现"}
虽然官方代码仓库还挂着 `Code (Coming soon)`,但论文正文和附录把整套软硬件配方交代得非常具体。如果你打算等代码放出后第一时间复现,或者在自己的灵巧手项目里借鉴这条管线,可以先对照下面这份清单备齐环境:
1. **仿真与强化学习底座**:
- 物理仿真器:**NVIDIA Isaac Sim** + **[Isaac Lab](/sdks/isaac-lab)**(基于 GPU PhysX 引擎,120 Hz 仿真步长 / 10 Hz 策略控制频率)。
- 显存与算力准备:由于消融实验证明 **49,152 个并行环境**与 24,576 个环境之间存在从 `<25%` 到 `>90%` 的性能断层,你需要准备足以在 Isaac Lab 里同时撑起近五万个多指接触环境的 GPU 算力。
2. **外部大模型与视觉感知工具链(Table 2)**:
- 云端 API:**`gemini-3.1-pro-preview`**(抽取顺序场景图,单任务不到 `$0.05`)与 **`GPT-5`**(估计物体质量与摩擦系数)。
- 视觉与 3D 模型:**`SAM 3.1`**(首帧分割)、**`SAM 3D Objects`**(单目/点云米制网格重建)、**`SAM 3`**(多视角渲染图功能部位定位)、**`FoundationPose++`**(实时 6D 位姿跟踪)。
- 多指抓取生成:**`Dexonomy`**(生成覆盖 33 类抓取分类学的候选抓法与闭合指令 $q_{\text{cmd}}$)。
3. **真机硬件配置参考**:
- 机械臂与灵巧手:真机验证配置为 `6-DoF UR3` + `20-DoF Wuji 1`;仿真验证过的配置还包括本站收录的 [Universal Robots UR5e](/robots/universal-robots-ur5e) 搭配 [Sharpa](/companies/sharpa) Wave(`/parts/sharpa-wave-hand`)、`Wuji 2` 或 `Allegro` 四指手。
- 相机与控制器:两台固定机位的 **Intel RealSense D435i** RGB-D 深度相机(用于深度一致性加权融合的 6D 位姿追踪),以及运行在底层、带关节速度限幅和手-桌避碰间隙约束的 **QP(二次规划)控制器**。
::: handson 上手卡 · Dex-One2Many
- **论文与项目页** arXiv 全文 `https://arxiv.org/html/2610.12470`(`arXiv:2610.12470v1`,2026-10-08 提交);项目主页 `https://dex-one2many.github.io/`
- **代码与许可证** 代码状态为 `Code (Coming soon)`;arXiv 论文许可证为 `CC BY 4.0`,项目主页网站许可证为 `CC BY-SA 4.0`
- **软件栈依赖** 训练使用 `NVIDIA Isaac Sim` + `Isaac Lab`(GPU PhysX,49,152 并行环境,PPO + 非对称 Actor-Critic,1 层 1024 宽 LSTM);预处理与感知调用 `Gemini 3.1 Pro`、`GPT-5`、`SAM 3.1`、`SAM 3D Objects`、`SAM 3`、`Dexonomy` 与 `FoundationPose++`
- **硬件门槛** 真机需 6 自由度机械臂(如 UR3)+ 多指灵巧手(如 20-DoF Wuji 1)+ 2 台 `Intel RealSense D435i` RGB-D 相机;仿真已验证 `UR5e` + `Sharpa Wave` / `Wuji 2` / `Allegro`
- **API 成本参考** 5 个任务(共 27.11 秒 640×480 视频)调用 `gemini-3.1-pro-preview` 抽取场景图总耗时 `81.9s`,总费用 `$0.171`(单任务 `$0.024–$0.045`)
:::
**本站判断**:`Dex-One2Many` 最聪明的地方,是看穿了「从人类视频学灵巧手」真正的死胡同不在视觉重建精度,而在**不应该去模仿人手的具体运动轨迹**。用几美分的 `Gemini 3.1 Pro` 调用把人类视频提炼成与硬件无关的「顺序场景图」,再用 `Dexonomy` 生成的成百上千种多指抓法和经过最坏物理校验的 10,000 个阶段重置状态去喂饱 `Isaac Lab` 里的 49,152 个并行环境,这套「大模型抽符号关系 + 大规模仿真做物理搜索 + 底层 QP 保真机安全」的三明治架构,把各自最擅长的事放在了最合适的位置上。不过在工程落地上,它依然绑着两根拐杖:一是真机策略完全不看图像、强依赖外部双相机跑 `FoundationPose++` 实时报出刚体的 6D 位姿;二是近五万个并行环境的算力门槛和尚未放出的代码。一旦面临柔性物体、铰接机构或严重遮挡导致 6D 位姿追踪漂移,这套纯位姿观测的策略就会遇到真正的硬骨头。
::: takeaway
别让多指灵巧手硬抄视频里人手的轨迹;把视频抽成阶段关系图、在近五万个并行仿真环境里重搜抓法,未见位置成功率能从 15% 以下拉到 75%。
:::
::: sitenote
- **表格与媒体出处**:正文中跨本体仿真成功率表(Table 1)、预训练模型分工表(Table 2)及 VLM 查询耗时与费用表(Table 6)均译自 `arXiv:2610.12470v1` HTML 全文;四张论文配图(Figure 1、Figure 2、Figure 4、Figure 6、Figure 12)直接引用自 arXiv HTML 论文页面,遵循 `CC BY 4.0` 许可协议;两段带旁白的演示视频(`teaser.mp4`、`method_video.mp4`)引用自作者项目主页 `https://dex-one2many.github.io/`,遵循网站注明的 `CC BY-SA 4.0` 许可协议。
- **本站计算说明**:未见配置领先幅度与已见配置领先幅度的比值 `10.92`(`71 / 6.5`)、Table 1 四种本体五任务平均成功率的极差 `2.2` 个百分点(`96.8 - 94.6`)、Table 1 单项最高格与最低格的极差 `11.6` 个百分点(`100.0 - 88.4`)、以及 49,152 个并行环境相对于 12,288 个环境的倍数 `4.0`(`49152 / 12288`),均由本站根据论文公布数字计算得出;`` 消融对比图由本站根据论文 §4.4 正文数据整理生成。
- **材料核查说明**:论文作者单位行中出现的 `All Purpose AI` 因未与项目页上的 SNU / UMD / KAIST 作者一一对应,本文按材料包纪律未将其安在具体作者名下;Figure 4 中的单任务真机柱值与 `N/A` 硬件故障未在正文及图注中给出文字明细,本文严格引用正文给出的总体区间。
:::
## 原始参考来源 (Sources)
- [Dex-One2Many arXiv abstract (arXiv:2610.12470) · arXiv](https://arxiv.org/abs/2610.12470)
- [Dex-One2Many HTML full text (arXiv:2610.12470v1) · arXiv](https://arxiv.org/html/2610.12470)
- [Dex-One2Many project page · Authors](https://dex-one2many.github.io/)